12.2 随机矩阵理论:初始化为什么重要
本节位置:模块 12 · 进阶 | 前置:7.2、10.2 | 预计:40 分钟
一句话:随机矩阵的奇异值不会「平均地」落在 1 附近,而是铺开成一个分布;初始化的任务,就是把这个分布的中心调到 1 附近。
0. 场景引入
上午 10 点,你在一台 8 卡节点上训练一个 32 层、 的模型(约 7B 参数),顺手把初始化从 改回 ,理由是「初始化不就是把方差归一化嘛」。,标准正态矩阵的谱范数约 ,残差流每过一层放大 128 倍: 还在 fp16 上限 65504 以内,第 3 层 直接 inf,loss 变 NaN。
你本来想验证的是「初始化调大一点,梯度会不会在 12 层后消失」;结果先看到了反方向的极端——不是消失,是溢出。
你原本想省掉的是「按时长调学习率」的麻烦,结果先付了 3 天 × 8 卡 ≈ 576 卡·时的重跑成本;更贵的是排查的那半天——所有人先怀疑数据管线,最后才发现问题在一行 std。
问题:随机矩阵的谱到底长什么样?Marchenko–Pastur 和半圆律在什么条件下才成立?「方差除以 」为什么不够?换句话说:你要控制的是「每层放大倍率」,而不是「每层元素标准差」。
读完本节,你应该能回答三件事:
- 随机矩阵最大/最小奇异值的典型尺度,以及 是从哪来的;
- MP 律、半圆律、 各自的适用边界;
- 怎样用谱、而不是元素方差,判断一个初始化会不会爆。
1. 直觉
把随机矩阵想成「一面有纹理的墙」:
- 大多数方向被拉伸/压缩的程度接近某个典型值;
- 少数方向(最大奇异值)拉伸得特别厉害;
- 如果你反复乘,信号会逐渐对齐到最大奇异值的方向,每步放大 倍。
所以初始化不是「随便随机」,而是控制谱。
💡 一句话直觉:随机矩阵的谱有典型尺度;初始化 = 把权重缩放到让这个尺度 ≈1。
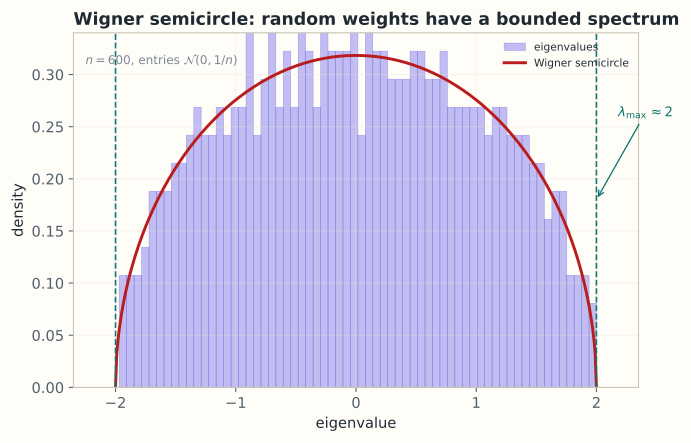
图:、元素方差 的对称随机矩阵的特征值直方图;大部分落在 ,与 Wigner 半圆律吻合,最大特征值约 2。
类比边界:随机矩阵理论多讨论独立同分布元素、大维度极限;真实训练好的权重有结构(低秩、重尾),不能完全套用。
1.1 它在现实世界里对应什么:一串齿轮
把每层权重想成一组齿轮:元素方差决定「齿数大概多少」,谱范数决定「这一级的传动比」。传动比 的 100 级是 倍; 的 100 级就是 倍。随机矩阵理论告诉你:方差为 时,最坏那一级齿轮的传动比约是 2,不是 1——因为最大奇异值对应的是「所有齿刚好对齐」的那个方向。
同一个东西也出现在声学里:房间的平均吸收决定混响衰减多快,但某个模态(最大特征值)决定会不会啸叫。谱范数就是那个「最响的模态」。
1.2 这个类比在哪里失效
齿轮的传动比是确定、可数的;随机矩阵的谱是分布, 是渐近期望,单次实现会上下浮动。更关键的是:真实网络里有 ReLU/GELU、LayerNorm 和残差,实际算子不是纯矩阵连乘,线性谱只能当「量级/上界」,不能当精确预测。训练好的权重还有低秩离群值和重尾,恰好落在 MP 假设之外(§2.6)。
1.3 量级
时 ; 时 。方差 的方阵,,而 在有限 下不为 0——方阵的 MP 下界是 0,所以条件数随 增大而增大,– 时在 – 量级(数量级估计,不是定理)。
2. 定义
2.1 随机矩阵
元素 是随机变量。常见:
- Ginibre 系综: 独立;
- Wigner 系综:对称随机矩阵;
- 样品协方差:, 为 随机数据。
2.2 经验谱分布
即特征值/奇异值的经验分布。
2.3 Marchenko–Pastur 律
设 ,元素 i.i.d. 均值 0、方差 ,。则 的特征值分布趋近 Marchenko–Pastur 律,支撑区间
2.4 Wigner 半圆律
对称随机矩阵(方差 )的特征值分布在 ,密度为半圆,即 Wigner 半圆律。
2.5 谱范数尺度
对 ,元素 i.i.d. 方差 :
若取 (),则 ,而不是 1。
2.6 这些结论的适用边界
| 结论 | 前提 | 边界 / 失效 |
|---|---|---|
| MP 律 | 元素 iid、均值 0、方差 、四阶矩有限; 且 | 元素相关(整行复制、tied weights)或重尾(如 分布)会改变支撑; 时 有 个精确的 0 特征值,§4.2 的条件数公式只描述非零部分 |
| 半圆律 | 对称/Hermitian,上三角 iid、方差 | 描述的是特征值,不是奇异值;非对称矩阵的特征值落在复平面,不能套半圆 |
| 元素 iid、方差 、 都大 | 是渐近期望,不是硬上界;有限 会围绕它涨落,相关列/重尾会让它更大 | |
| ( 的方阵) | 同上, | 是 的极限; 这种小矩阵误差可观,不能拿它做精确预算 |
一句话:RMT 是零模型。它回答「没有任何结构时谱长什么样」,可以当基线,不能当保证。
3. 为什么这样定义
深度网络是矩阵连乘。若每层谱范数平均为 , 层后信号放大约 。要让前向/反向稳定,需要 。
但「方差为 」只让平均奇异值接近 1,最大奇异值仍约 2。真正决定稳定性的是谱范数,不是元素方差。这就是为什么初始化要考虑 fan-in/fan-out、正交初始化、谱归一化。
3.1 反事实一:元素尺度对了,谱可以差 32 倍
取 ,令 ——每个元素都是 ,和「元素尺度 」完全一致。
对 :。所以谱范数是 ,其余奇异值全为 0。
同样「元素尺度」下,iid 高斯的谱范数是 2,这个矩阵是 64——差 32 倍,因为列与列完全相关,MP 的独立性前提被破坏。每层放大 64 倍,2 层就是 ,3 层 ,fp16 直接溢出。
教训:判断初始化不能只看 std,要看独立性与谱;工程上至少抽查一次 torch.linalg.matrix_norm(W, 2)。
3.2 反事实二:平均奇异值等于 1,照样爆
。平均奇异值 ,Frobenius 范数 ,看上去「总体上不放大」。
但 :20 层后 ,30 层 。只盯着「平均奇异值/元素方差」的检查会给出「正常」结论,而信号在 20 层内已经放大三个数量级。这就是 §2.5 与 §8 都用谱范数、而不用元素方差或 Frobenius 范数做稳定性判据的原因。
4. 性质与推导
4.1 为什么 给
的奇异值平方是 的特征值。 的对角元约为 ,非对角元随机;最大特征值约为 (MP 律上界),所以 。
4.2 条件数
随机方阵的条件数
当 (方阵)时,,条件数发散——随机方阵接近奇异。
4.3 信号传播
若 各向同性、方差 1,则
取 得 。所以输出每维方差约 1(若 则总范数 )。
4.4 尖峰模型(spiked model)
若在随机矩阵上加一个低秩信号 ,当信号强度超过 MP 边缘时,会出现离群特征值;否则信号被噪声淹没。这是 PCA/低秩检测的理论基础。
5. 例子
5.1 模拟:谱范数 vs 缩放
import numpy as np
n = 1000
for scale in [1/np.sqrt(n), 1.0]:
    W = np.random.randn(n, n) * scale
    s = np.linalg.svd(W, compute_uv=False)
print(scale, s[0], s[-1], s[0]/s[-1])- scale :,,条件数很大;
- scale :,信号爆炸。
5.2 手算: 随机矩阵
(缩放后的 Hadamard 型),
所有奇异值为 1,谱范数 1。这是正交初始化的理想情形。
5.3 场景:为什么 Transformer 初始化要除以
若 的元素方差为 1,,则 。残差流每层放大 128 倍,几十层就溢出。 除以 后,,再配合归一化/残差,信号可维持在可控范围。
5.4 场景闭环:给 32 层网络定一个初始化
输入:,,fp16(上限 65504);残差流激活 个元素,单层 134 MB。
计算:若取 ,单层 ;不做归一化时 32 层连乘 。即使每层只比预期大 10%, 倍——误差是复利。
输出决策:选 、正交初始化,还是谱归一化?判据是「每层 是否接近 1」,不是「元素方差是否等于 」。
成本:激活若全部保留供反向, GB;一次 3 天 ×8 卡的失败训练约 576 卡·时。训练前花 10 分钟打印逐层 RMS,比事后重跑便宜两个数量级。
失败条件:① 小(比如 32)时 的渐近估计偏差大,按它设缩放会偏;② 有 LayerNorm 时,谱不再直接对应激活尺度,必须实测;③ fp16 的 65504 硬上限让「先涨后 NaN」来得非常快。兜底:前 100 步逐层记录激活 RMS 与 ,超阈值就中止;bf16 能推迟溢出,但掩盖不了指数增长。
6. 常见误区
-
误区:随机矩阵的特征值都接近 0。 纠正:大维度下特征值铺开成区间,最大奇异值约 。
-
误区:方差 就保证谱范数 1。 纠正:只保证平均尺度约 1,谱范数约为 2;要谱范数 1 需正交初始化或谱归一化。
-
误区:随机矩阵理论只适用于纯噪声。 纠正:它是零模型;真实权重有低秩/重尾结构,但零模型能解释「为什么随机初始化会爆炸/消失」。
-
误区:初始化只影响训练初期。 纠正:它影响整个训练动态、可训练性、最终泛化;大模型的 muP 等工作专门研究这个。
7. 概念网络
- 前置:7.2 SVD 性质 —— 奇异值。
- 前置:10.2 条件数 —— 谱范数。
- 关联:11.12 训练稳定性 —— 梯度连乘。
- 关联:12.3 全景图 —— 谱视角。
8. 通往大模型:初始化与谱
| 方法 | 目标谱 |
|---|---|
| Xavier | 前向/反向方差平衡, |
| He | ReLU 网络, |
| 正交初始化 | 所有奇异值 =1 |
| 谱归一化 | 每步把 约束到 1 |
| muP | 随宽度调整学习率/初始化,使特征学习稳定 |
可检验结论:对 高斯矩阵,(方差 1)。若你的初始化让每层放大 2 倍,20 层就是 倍——必须缩放。
学错/选错时,下游看到什么:
- 用元素方差代替谱做判据:loss 前几百步正常,随后 spike/NaN,grad norm 从 1 跳到 以上;日志里最先异常的是某一层激活 RMS,而不是 loss;
- 用「平均奇异值」定量化/压缩预算:outlier 方向被 clip,短 prompt 几乎看不出,长文任务先掉点;
- 把 MP 当硬上界:真实权重的重尾会让 超过 ,按上界设的缩放不够,深层照样爆。
9. 练习
- 概念:为什么随机方阵的条件数通常很大?
- 计算:,方差 1 的高斯矩阵,谱范数量级是多少?方差 呢?
- 计算:若每层谱范数 1.5,30 层后放大多少倍?
- 场景:正交初始化为什么能让信号稳定?它的奇异值是什么?
- 开放:真实训练好的权重往往有「重尾」奇异值分布,这与 MP 律的差异说明了什么?
参考答案
- 最小奇异值接近 0(MP 律下界),最大约 2,比值发散。
- 方差 1:;方差 :。
- 。
- 所有奇异值为 1,每层不放大也不缩小;但正交矩阵不唯一,且与非线性配合仍需调整。
- 真实权重有低秩结构/离群奇异值,不是纯噪声;这说明训练会塑造谱,而初始化只是起点。
10. 一页速记
- 高斯矩阵谱范数 。
- 方差 的方阵:,。
- MP 律描述 的谱区间。
- 初始化目标:让每层放大倍率 ≈1。
- 正交初始化/谱归一化直接控制谱。
- 物理意义/现实对应: 是这一级齿轮的传动比,谱半径是增长率;随机矩阵是「没有任何结构时的基线噪声」。
- 适用边界:MP/半圆律都要求元素独立同分布、维度大;相关列、重尾、小 都会让结论失效, 是渐近期望而非硬上界。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、定理名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- Marchenko 与 Pastur(1967):Distribution of Eigenvalues for Some Sets of Random Matrices。证明 的经验谱在 时收敛到 MP 律,给出本页 §2.3 的支撑区间下界 与上界 。Mathematics of the USSR-Sbornik
- Wigner(Eugene P. Wigner, 1958):On the Distribution of the Roots of Certain Symmetric Matrices。半圆律的原始论文:对称随机矩阵的特征值密度趋近 上的半圆,本页 §2.4 的出处。Annals of Mathematics
- Glorot 与 Bengio(2010):Understanding the difficulty of training deep feedforward neural networks。Xavier 初始化:用 让前向与反向的信号方差逐层保持,正是本页 §8 的第一行目标。PMLR(AISTATS 2010)
- He 等(2015):Delving Deep into Rectifiers: Surpassing Human-Level Performance on ImageNet Classification。He 初始化:指出 ReLU 把一半激活置零,于是要用 补回方差,解释了本页 §8 为何 Xavier 与 He 差一个因子 2。arXiv:1502.01852
下一篇 → 12.3 线性代数全景图
随堂测 · 4 题
源文件:12-进阶/02-随机矩阵理论.md