7.3 低秩近似与 Eckart–Young
本节位置:模块 7 · SVD | 前置:7.2 | 预计:40 分钟
一句话:只留前 个奇异值,得到的就是所有秩不超过 的矩阵里离 最近的那个——这不是启发式,是定理。
0. 场景引入
一家 SaaS 公司的支持团队有 20,000 篇历史工单和 50,000 个词构成的词表,想把新工单自动路由到 100 个主题队列,减少人工分拣。
工单-词矩阵 如果按稠密矩阵存,要 ;实际只有 0.5% 的非零( 个),稀疏存储约 40 MB。但稀疏矩阵不能直接算「主题相似度」,于是用截断 SVD 取前 个主题:,因子只占 个数,fp32 约 28 MB。
现在的决定是 取 100 还是 300:100 个主题人看得过来,但会把「某型号电池鼓包」这种只有几百篇的稀有故障并进「其他」;300 个主题分得更细,标注和运维成本翻三倍。代价是:路由错了,工单在队列之间转手,用户等更久;而离线重构误差可能完全看不出这个问题。
他们准备了 2,000 篇人工标注,要求路由准确率不低于 90% 才上线;这个指标和 Frobenius 误差不是一回事。
读完你能回答三个问题:
- 为什么「只留前 个奇异值」在所有秩 的矩阵里最优?这个「最优」是对哪种误差说的?
- 按行范数或词频截断,为什么会丢掉低秩分解能看到的结构?
- 什么时候 仍然不够,该看什么指标?
1. 直觉
SVD 把 写成一层层秩 1 的「图案」叠加:
每一项 是一张「条纹图」(行方向一个模式、列方向一个模式), 是它的音量。 最大,所以第一层是画面的主体轮廓;越往后越是细节与噪声。
截断 SVD 就是只保留音量最大的前 层:
💡 一句话直觉: 是「用 张条纹图能拼出的最像 的图」,而 Eckart–Young 说没有更好的 层拼法。
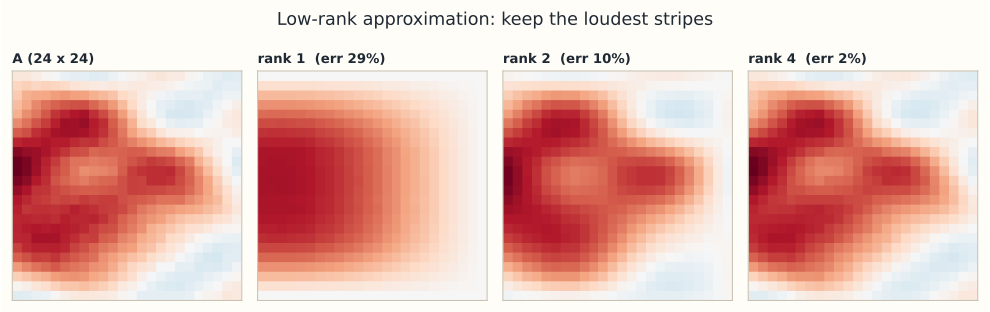
图:一个 的合成矩阵(3 个平滑秩 1 图案加小噪声)的截断 SVD。只保留前 1、2、4 层时,相对 Frobenius 误差分别约 29%、10%、2%。
1.1 它在现实世界里对应什么
把工单-词矩阵想成一张主题地图:每一行是一篇工单,每一列是一个词,SVD 找出 个「主题方向」:
| 数学对象 | 主题分析里的对应物 |
|---|---|
| () | 每行一篇工单、每列一个词的 TF-IDF 权重 |
| 第 个主题在语料里有多强 | |
| 第 个主题在 2 万篇工单上的得分 | |
| 第 个主题在 5 万个词上的权重 | |
| 只用前 个主题重建的工单-词矩阵 |
一篇新工单投影到这 个方向上,就得到它的「主题坐标」;坐标最接近哪个队列,就路由到哪。这和第 7.1 节的「条纹胶片」是同一件事,只是「胶片」的两边变成了词和文档。
1.2 这个类比在哪里失效
- 主题正交,名字不正交。「电池」和「充电」可能落在两个主题上,人却会把它们合成一个;SVD 不负责给主题起名。
- 小不等于主题没价值。一个只有 200 篇工单的稀有故障,能量占比可能不到 0.1%,但业务价值最高。
- TF-IDF 本身是一个选择。词干化、停用词、n-gram 都会改变矩阵;SVD 只对给它的矩阵做最优,不对「原始文本」做最优。
- 词袋丢掉语序和否定。「不充电」和「充电」在矩阵里可能共享大部分词,主题方向分不开。
1.3 量级直觉
时,因子 ()、(100)、()一共 个数,fp32 约 28 MB;稠密原矩阵是 4 GB,稀疏存储约 40 MB。也就是说,因子比稀疏矩阵还小一些,比稠密矩阵小两个数量级。
能量方面,若谱按 衰减,则
这个式子说的是:按 衰减时,100 个主题就占了约 99.4% 的 Frobenius 能量。真实语料的谱可能衰减更快(主题集中)也可能更慢(长尾故障多),必须实测。
2. 定义
2.1 截断 SVD(truncated SVD)
设 是瘦 SVD,秩为 。对 定义
其中 、、。 的秩恰为 (若 )。
存储量: 个数,而不是 ;压缩比 。这条「低秩近似(low-rank approximation)」的路子,误差由下面两个等式精确给出。
2.2 两种误差
第一式是 Frobenius 误差:剩余全部奇异值的平方和。第二式是谱误差:最大的那个剩余奇异值。两者都是精确等式,不是估计。
2.3 能量比
把 当总能量,前 项占比
常用来选 :取最小的 使 。注意这是一个约定,不是定理;它成立与否取决于你的任务能否容忍剩余 1% 的能量。
3. 为什么这样定义
为什么不直接用「前 行」或「前 列」? 那只是把矩阵切成方块,剩下的部分完全不管;而截断 SVD 让每一个保留的方向都尽量对齐 的主要结构。
为什么「保留最大的 」是自然的? 因为误差公式已经告诉你:丢掉 就贡献 的平方误差。要最小化总误差,当然先丢最小的那些。Eckart–Young 把这句直觉变成了最优性定理:在秩不超过 的所有矩阵中, 使 Frobenius 误差与谱误差同时达到最小。
和最小二乘什么关系? 都在做「约束下的最近点」。最小二乘约束 在列空间里,这里约束 的秩不超过 。区别是:秩不超过 的矩阵集合不是子空间(两个秩 矩阵相加可能秩 ),所以 是「到非凸集合的最近点」,不能写成投影矩阵。
3.1 反事实:按行范数截断会坏在哪
假设有人觉得「低秩就是留最重要的几行」,于是按行范数从大到小,只保留前 行、其余置零。取一个本来就是秩 1 的矩阵:
三行的范数分别是 、、。保留范数最大的第 3 行,得到
而 本身秩就是 1,最优的 ,误差 0。按行范数截断把误差从 0 抬到 ,相对误差 ——一个已经低秩的矩阵,被「低秩压缩」丢掉了近六成能量。
坏在哪:行范数只回答「这一行有多长」,不回答「这些行是不是朝着同一个方向」。 的三行其实共线,这正是低秩结构;按行截断看不见它。按列范数、按元素绝对值保留前 个,犯的是同一类错误:它们优化的是「保留多少原始条目」,不是「用 个方向重建」。
3.2 Eckart–Young 的边界:Frobenius 最优 ≠ 下游最优
定理的结论必须带着范数读。取
两个秩 1 的候选:
- ,Frobenius 误差 ;
- ,Frobenius 误差 。
Eckart–Young 保证 是 Frobenius 意义下最好的秩 1 近似。但如果下游指标是「第 2 个特征(比如那件稀有商品)还能不能被召回」, 把它直接置零,得分 0; 保住了它,得分 1。Frobenius 最优的选择,在排序/召回指标上可以是最差的。
所以定理的正确读法是:在所有秩 的矩阵中, 最小化 Frobenius 范数与谱范数(更一般地,所有单位不变范数);它不管逐元素 0-1 损失、AUC/NDCG、主题可解释性,也不管下游模型能不能用。 把「SVD 最优」泛化成「对所有误差度量最优」,是这一节最常见的误读。
4. 性质与推导
4.1 Eckart–Young 定理
设 ,秩为 ,奇异值 。对任意满足 的 :
且 时两个等号同时成立。
4.2 谱范数(spectral norm)部分的证明(三行)
意味着零空间维数 。取子空间 ,维数 。两个子空间维数之和 ,故必有非零单位向量
对它,,且 。于是
这就是 。等号在 时取到,因为 的最大奇异值正是 。
Frobenius 版本用 Weyl 不等式 逐项比较,再平方求和即可;思路相同,只是把「一个方向」换成「所有剩余方向」。Mirsky 证明同一最优性对所有单位不变范数成立,Frobenius 只是其中一例。
4.3 三条推论
- 单调: 增大,误差不增(多留一个非负项)。
- 时误差为零; 时 ,误差 。
- 相对误差:,可直接用能量比换算。
5. 例子
5.1 手算: 的最优近似
取 7.1 的矩阵 ,已知 、,、。
误差:
Frobenius 平方 ✓,所以 ,谱误差也是 (只剩一项)。
能量比:,即保留了 90% 能量,相对误差 。
验证最优性:随便挑一个秩 1 的对手,比如 ,则 ,。换成 (也是秩 1),,Frobenius 误差 ,仍大于 的 。Eckart–Young 保证:无论怎么试,都赢不了 。
5.2 场景:主题分析的账与 LoRA 的秩预算
主题分析: 的工单-词矩阵, 时因子共 个数,fp32 约 28 MB;稠密原矩阵 4 GB,压缩约 143 倍。但相对稀疏存储的 40 MB,它只小 30%——低秩压缩的对手不是「零」,而是「稀疏」。误差不是猜的,是 ,跑一次截断 SVD 就能画出「误差 vs 」曲线(Trefethen 与 Bau 第 5 讲用同一套公式讨论低秩近似)。
LoRA:一个 的权重()若只允许秩 的更新,参数是 而不是 。 时 对 ,相差 128 倍。Eckart–Young 告诉你:如果真实需要的更新确实是 且它的谱快速衰减,那么秩 16 的参数化能抓住其中 的「能量」——前提是谱真的衰减,这要用数据验证。
5.3 场景闭环:2 万篇工单、100 个主题
输入: 的 TF-IDF 矩阵,非零元 个(密度 0.5%)。稀疏存储按每非零 8 B(4 B 值 + 4 B 索引)估约 40 MB;稠密存储要 4 GB。
计算:随机化截断 SVD,。每轮的主要开销是 与一个 的块相乘,约 FLOP;按 4 轮幂迭代估约 FLOP,单核 10 GFLOP/s 约 0.4 s。作为对照,完整 SVD 约 FLOP,单核要半个多小时。
输出:100 个主题方向,加上每篇工单的 100 维主题坐标;新工单取坐标最大的队列,决策是 还是 。单篇投影的成本是 FLOP,约 0.5 ms。
成本:因子共 个数,fp32 约 28 MB;比稠密矩阵小 143 倍,但只比稀疏矩阵小 30%。存储不是主要瓶颈,训练与调参的人力才是:300 个主题意味着 300 份主题命名与标注。
失败条件:
- 稀有主题被能量门槛丢掉:只有 200 篇工单的故障, 可能排到第 500 位;按 选 ,它一定被截掉。兜底:对已知稀有类单独保留方向,或训练一个监督分类器兜底。
- Frobenius 误差好,路由准确率差: 最小化的是重构误差,不是「工单该进哪个队列」。兜底:用人工标注的路由准确率验收,不看 。
- 词表漂移:新产品带来新词,旧 里没有这些方向,投影全落在老主题上。兜底:定期重训、给新词留 OOV 桶。
6. 常见误区
- 误区:截断 SVD 就是「把小的矩阵元素置零」。 纠正:它丢的是小奇异方向, 的每个元素通常都变了。元素级稀疏化和低秩是两种完全不同的结构。
- 误区: 就是 的前 行/列。 纠正: 是 个秩 1 外积之和,行和列都被整体改写。
- 误区: 与 差不多。 纠正:前者是剩余奇异值的「整体长度」,后者只是最大的一个。若谱衰减慢,两者能差 倍。
- 误区: 小就一定能丢。 纠正:小奇异值可能对应任务最需要的细节(高频边缘、罕见类别)。误差上「小」≠ 语义上「不重要」。
7. 概念网络
- 前置:7.2 SVD 的计算与性质 —— 误差公式来自 。
- 前置:2.6 秩 —— 「秩不超过 」这个约束的含义。
- 后续:7.4 伪逆与数值秩 —— 用截断处理病态与数值秩。
- 后续:7.5 SVD 应用 —— PCA、推荐、LoRA 都建立在这一节上。
- 关联:9.3 PCA —— 只保留主成分,就是截断 SVD 的统计版本。
8. 通往大模型:低秩是一种预算
出现位置:LoRA 的秩约束、模型/激活压缩、KV Cache 压缩、以及「这个权重到底需要多少秩」的诊断。
LoRA 的形状:,、,参数量 。 时为 ,占全参数 。训练完可以再对 做一次 SVD:若前 个奇异值已占 99% 能量,就能把 换成秩 的版本,参数量再降 ,且由 Eckart–Young 这是该秩下的最优近似。
KV Cache:每层每个头缓存 ,共 个数( 层、)。若对 做低秩近似 (、),存储变成 ,误差由 控制。收益条件是 ,即 ; 时近似为 。所以压的是「每头维度」,不是「序列长度」。
谱范数/条件数视角:截断后 ,所以「丢掉第 个奇异值」的直接代价是对该方向的最坏误差。若 与 同量级,截断就是灾难;若 ,截断基本无损。
可检验结论:压缩后必须验证 是否等于 (浮点误差内),这是检查实现是否真的做了截断 SVD 的最快办法。
算错时下游看到什么:若只按 选 ,稀有主题的 小,会在压缩时被丢掉;工单路由把它们送进错误队列,用户看到的是转人工、等待时间变长,而离线重构误差仍然很漂亮。兜底是对长尾类单独保留方向、用路由准确率而非 Frobenius 误差做验收。
9. 练习
- 概念:为什么「秩不超过 的矩阵集合」不是子空间?举一个 的例子。
- 计算:,写出 ,算 、 与能量比 。
- 计算: 的图, 时存多少个数?压缩比多少?若要求误差 ,你能只凭压缩比判断可行吗?
- 场景:LoRA 训练出的 奇异值为 ,取 会损失多少能量?这个损失合理吗?
- 开放:能量比 99% 一定「够用」吗?举一个能量比很高但视觉/语义损失明显的场景。
参考答案
- 取 、,两者秩都是 1,但 秩 2,超出集合,故对加法不封闭( 也在集合里,所以它对加法几乎什么都不封闭)。
- ,(加一行零);,,。
- 个数,压缩比 。不能:压缩比只由 决定,误差由该图的奇异值谱决定,必须实测 。
- 保留能量 ;总量约 ,,损失约 18% 的 Frobenius 能量——对「保结构」的任务可能过大,应看下游指标而非只看能量。
- 高对比度的细线条图:能量集中在低频,但去掉高频后边缘模糊、文字不可读。医学影像的微小病灶同理——能量占比极低,语义却关键。
10. 一页速记
- ,秩恰为 (),存储 。
- ,,都是精确等式。
- Eckart–Young:所有秩 的矩阵里, 同时最小化 Frobenius 与谱误差;能量比 用来选 ,但它是约定不是定理,也不保证下游指标。
- 物理意义 / 现实对应: 是「用 个正交主题方向重建的矩阵」; 是主题强度, 是文档上的得分, 是词上的权重。
- LoRA 的 与 KV Cache 的低秩压缩,都是这一节公式的直接应用。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、定理名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- Eckart 与 Young(Carl Eckart & Gale Young, 1936):The Approximation of One Matrix by Another of Lower Rank。证明在所有秩 的矩阵中,截断 SVD 同时最小化谱误差与 Frobenius 误差,即本页第 4.1 节的 Eckart–Young 定理。Psychometrika 1(3)
- Mirsky(L. Mirsky, 1960):Symmetric Gauge Functions and Unitarily Invariant Norms。把 Eckart–Young 的最优性从谱范数、Frobenius 范数推广到所有单位不变范数,本页第 4.2 节补 Frobenius 版本时用的正是这条路线。Quart. J. Math. 11(1)
- Trefethen 与 Bau(Lloyd N. Trefethen & David Bau III, 1997):Numerical Linear Algebra。第 5 讲专门讲 2-范数与 Frobenius 范数下的低秩近似,并提到它在图像压缩里的用途,对应本页第 2.2 节的两个误差等式。SIAM, 1997
下一篇 → 7.4 伪逆、数值秩与条件数
随堂测 · 5 题
源文件:07-SVD/03-低秩近似.md