10.3 BLAS 与 GEMM:GPU 为什么快
本节位置:模块 10 · 数值线性代数 | 前置:3.3 矩阵乘法、10.2 矩阵范数与条件数 | 预计:40 分钟
一句话:GPU 不是「所有运算都快」,而是「每个字节被复用很多次时特别快」;GEMM 正好是这种运算的极端代表。
0. 场景引入
训练一个 7B 模型,一步要过 个 token。按 估算,一步约
按 300 TFLOPS(bf16 张量核量级)算,一步 分钟;若 GEMM 只跑出峰值的 ,同样一步要 分钟——一天差出 15 小时。
同一块卡上,一层 FFN 的 GEMM 是 ,算术强度约 – FLOP/byte,远在拐点右侧;解码时 的同一层只有约 FLOP/byte,被带宽卡死。
这里的 300 TFLOPS 与 2 TB/s 都是 Roofline 的上界,不是实测值;估算的意义在于判断瓶颈落在哪一侧,而不是预测毫秒数。 里的 是训练 token 数、 是参数量,系数 6 已把前向与反向都算进去。
决定:把 micro-batch 从 4 提到 16 换取更高算术强度,还是保持 4、用梯度累积?
注意 只占 FLOPs 的一个因子,却决定算术强度: 从 掉到 ,AI 从约 掉到约 ,跌破拐点,同一批 FLOPs 要多花几倍时间。
代价:显存只剩 18 GB 余量,提到 16 可能 OOM;降回去则 GPU 空转,机时按小时计费。
问题:为什么同样一次矩阵乘, 时算力受限、 时带宽受限?分块到底在省什么?
读完本节,你应该能回答三件事:
- 算术强度怎么算,Roofline 拐点为什么等于「峰值算力 ÷ 带宽」?
- 分块把算术强度提高多少,为什么 tile 不能无限大?
- 什么时候该怀疑「FLOPs 更高所以更慢」这句话?
1. 直觉
1.1 厨房类比:切菜 vs 取菜
把计算想成厨房:算力是厨师切菜的速度,带宽是跑腿从仓库取食材的速度。
- 如果每切一刀都要跑一趟仓库,厨师再快也没用——这是访存受限(memory-bound)。
- 如果一次取回一大筐菜,切很多刀才需要再取——这是计算受限(compute-bound)。
算术强度(arithmetic intensity) 就是「每从仓库取 1 字节,能切多少刀」:FLOPs / Bytes。
💡 一句话直觉:算术强度高的运算,GPU 才快;GEMM 的强度随分块尺寸增长。
类比边界:厨房类比忽略了并行度与延迟。GPU 有上万个线程,延迟靠切换隐藏,不只是「带宽够不够」。
1.2 Roofline:两个天花板取较小者
一个 kernel 的时间至少是
把算术强度画在横轴、性能画在纵轴,就是Roofline 模型:低强度段是斜线(带宽决定),高强度段是平台(算力决定)。两条线的交点叫拐点(ridge point),其横坐标是「峰值算力 / 带宽」。
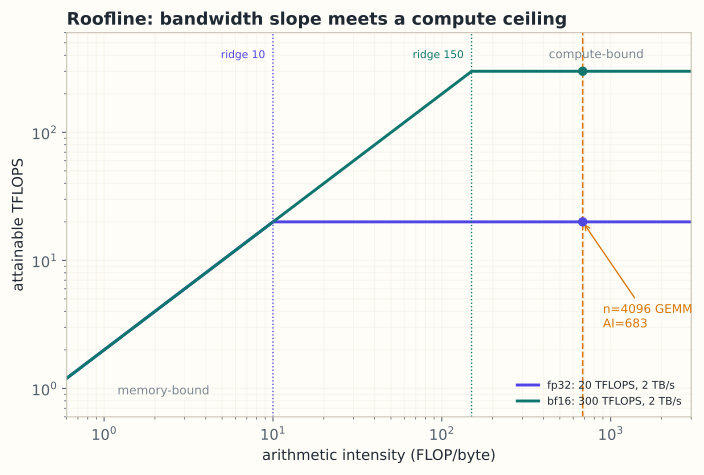
图:fp32(20 TFLOPS / 2 TB/s)与 bf16(300 TFLOPS / 2 TB/s)的两条 Roofline;拐点分别是 10 和 150 FLOP/byte。 的 GEMM 算术强度约 683,落在计算受限区。
1.3 它在现实世界里对应什么
一次 GEMM 对应一座工厂的「每公斤原料的加工工时」:HBM 是原料仓库,带宽是叉车速度(字节/秒),寄存器与共享内存是工位旁的料箱,算术强度就是「每取 1 公斤原料,能加工多少工时」。
Roofline 的拐点因此有明确单位:峰值算力 ÷ 带宽,量纲 FLOP/byte。
| 精度 | 峰值算力(按量级估) | 带宽 | 拐点 |
|---|---|---|---|
| fp32 CUDA 核 | TFLOPS | TB/s | FLOP/byte |
| bf16 张量核 | TFLOPS | TB/s | FLOP/byte |
的方阵 GEMM 算术强度是 ,在两种拐点右侧,都是计算受限——但**「离拐点多远」随精度变了 15 倍**。拿 fp32 的拐点去论证 bf16 kernel 的余量,会把安全边际估大一个数量级。
1.4 这个类比在哪里失效
厨房类比假设「取一次菜只按字节计费」。真实 GPU 还有延迟、occupancy、bank conflict、尾块浪费:一个 block 的线程可能因为一次 bank 冲突全部排队,带宽和算力都没变,吞吐却掉一半。
更根本的失效点:拐点假设「峰值算力」是常数。实际可达峰值随 tile 尺寸、寄存器压力、指令组合变化,Roofline 给的是上界,不是预测值。
2. 定义
2.1 GEMM 的形状
GEMM(general matrix multiply) 是 BLAS 的 Level-3 原语:
其中 是标量。形状记成 [M, K] @ [K, N] -> [M, N];一次乘加算 2 个 FLOP(1 次乘、1 次加),所以总运算量是 。
2.2 BLAS 的三个层级
BLAS(Basic Linear Algebra Subprograms) 是一组标准接口,按运算量分三层:
| 层级 | 典型函数 | 运算 | 复杂度 | 算术强度 |
|---|---|---|---|---|
| Level 1 | axpy、dot、nrm2 | 向量-向量 | 很低(约 1/4–1) | |
| Level 2 | gemv、trsv | 矩阵-向量 | 低(约 1) | |
| Level 3 | gemm、trsm、syrk | 矩阵-矩阵 | 高(可随分块增长) |
Level 3 的运算量按 涨、数据量按 涨,所以 越大,每个字节被复用得越多。
2.3 算术强度
对 GEMM,若只统计必须从显存读入的数据( 各一遍):
时 。 时是 FLOP/byte。这个数远大于拐点,所以大 GEMM 是计算受限。
2.4 内存层次
GPU 的存储不是一块,而是一套层次:
| 层次 | 典型容量 | 带宽量级 | 谁在用 |
|---|---|---|---|
| 寄存器(register) | 每 SM 数百 KB | 极高 | 每个线程的累加器 |
| 共享内存/L1 | 每 SM 约 100–200 KB | 高 | 一个 block 共享的 tile |
| L2 | 数十 MB | 中 | 多个 block 复用 |
| HBM(显存) | 数十 GB | 1.5–3 TB/s | 全局读写 |
分块(tiling/blocking)就是把大矩阵切成能塞进上一层的 tile,让数据在寄存器/共享内存里被多次使用。
3. 为什么这样定义
为什么 BLAS 要分层? 因为不同层级的瓶颈不同。Level 1/2 的每个浮点运算只伴随少量甚至一次数据搬运,优化空间在「少读一次」;Level 3 有 的复用潜力,优化空间在「让复用发生」。把接口标准化,硬件厂商就能为每一层写专用 kernel。
为什么 GEMM 是深度学习的核心原语? 线性层、卷积(im2col 后)、注意力的 与 都能写成 GEMM。只要 GEMM 快,模型的绝大部分 FLOPs 就快。
为什么列主序会出现? BLAS 源自 Fortran,按列连续存储;NumPy 默认行主序,调用 cuBLAS 时会用转置标志适配。这解释了为什么同一个矩阵在不同库里的「连续维度」可能不同。
为什么不用一个「万能 kernel」? 形状差异太大: 的 GEMV 与 的 GEMM 瓶颈完全不同,前者访存受限、后者计算受限,必须用不同策略。
3.1 反事实:换一种乘法顺序会坏在哪
矩阵乘法在实数上满足结合律,在代价上完全不满足。取
要算 (一个 维向量):
- :先算 , FLOPs,还要存一个 的中间矩阵(fp32 MB),再乘 花 ;
- :先算 , FLOPs,再乘 花 。
对 ,差 2000 倍。 精确算术下两个结果相等;工程上一个要 MB 显存,另一个只要 KB。Transformer 推理里 的顺序、LoRA 的 与 ,选的都是便宜的那个。
第二个反事实:把 GEMM 拆成 次 GEMV。 的每一列都可以看成一次 Level-2 的 GEMV, 时每列都要把整个 读一遍( MB),4096 列共 GB 流量;按 TB/s 是 ms,而分块 GEMM 只要 GB、 ms。同样的 FLOPs,换个组织方式差 60 倍——这正是 BLAS 分层的意义。
第三个反事实:换循环顺序。三重循环 i,k,j 里 的一整行能在寄存器与缓存里被复用;换成 i,j,k 后, 的访问步长是 KB,每读一个元素就换一条 cache line。一条 64 B 的 line 只装 16 个连续 ,如果 方向不做 16 的分块,同一行的下次复用要等「下一轮 」——中间隔着 次访问、约 KB 的 line 集,超过 L1,只能指望 L2。按经验,这会让同一个 kernel 慢 2–5 倍。
4. 性质与推导
4.1 FLOPs 与访存量
GEMM 有 个输出元素,每个元素要做 次乘加,所以
按 ()计, 各读一次、 写一次,访存量是 字节(fp32)。 时:
4.2 不分块时为什么慢
最朴素的三重循环,每做一次乘加都要取 与 各 4 字节,即 8 字节换 2 FLOP,算术强度只有 。若完全不靠缓存, FLOP 要搬 字节——按 TB/s 需要 s。
真实硬件有缓存,不会这么惨;但这个极端说明:不复用就必然访存受限。
4.3 分块把强度提高
把输出切成 的 tile。每个 tile 需要 的一条 面板和 的一条 面板,共 个元素;tile 的个数是 。因此总访存量是
与 §4.1 的 FLOPs 相除,得
读作:tile 越大,每个字节被复用得越多。 时 AI 为 ; 时为 。当然,tile 不能无限大——它必须塞进共享内存/寄存器,且要留够并行度。
4.4 Roofline 的判据
以 A100 量级为例:fp32 峰值约 TFLOPS、显存带宽约 TB/s,拐点约 FLOP/byte。 的 GEMM AI 约 ,远在拐点右侧,计算受限; 的 GEMV AI 约 (bf16 权重、忽略输出读写),远在左侧,访存受限。
5. 例子
5.1 手算: 的 GEMM
按 TFLOPS(bf16 张量核量级)算: ms。按 TB/s 搬 MB: ms。计算时间是访存时间的 4.5 倍,所以优化重点是让张量核别闲着。
若不分块、按 FLOP/byte 估算,访存时间会变成约 s;分块 后访存量降到 GB,时间约 ms——仍然比「理想一遍」的 ms 大,但已经从「百毫秒级」回到「毫秒级」。
5.2 手算:batch=1 时为什么反过来
解码时一次只处理一个 token:、。此时
权重 用 bf16 存是 MB。忽略 与输出 的读写,算术强度约
按 TB/s 读权重需要 µs;按 TFLOPS 算只要 µs。访存是瓶颈,差了两个数量级。把 batch 提到 ,FLOPs 变 倍、权重仍读一遍,AI 升到约 ,依然在拐点左侧;直到 batch 足够大,才会重新变成计算受限。
5.3 场景:cuBLAS 在做什么
cublasSgemm 不会只跑一个 kernel。它根据 、数据类型、转置标志选择:
- tile 尺寸与线程块形状:如 ,匹配共享内存与寄存器预算;
- split-K: 很大而 很小时,把 切给多个 block 并行,再原子累加;
- stream-K:把 tile 工作重新分配到固定数量的 CTA,减少尾效应;
- 张量核指令:bf16/fp16 输入、fp32 累加,一条 MMA 指令完成一个小矩阵块。
CUTLASS 把这些策略写成模板;cuBLAS 则是闭源的高度调优版本。FlashAttention 的思路类似:把 的注意力矩阵切块,在片上完成 softmax,避免把中间矩阵写回显存。
5.4 场景闭环:一步训练怎么被 GEMM 决定
输入:7B 模型、,micro-batch 取 个 token,bf16 权重、fp32 累加。
计算(只数一层 FFN,):
两个 GEMM 各 。算术强度按 bf16 计约 FLOP/byte,远在拐点 右侧,所以「算」是瓶颈:按 TFLOPS 约 ms。
输出:这一层的吞吐约 token/s。全模型每 token 约 FLOPs,量级相同,这里不展开。
成本:显存大头是激活: 的中间张量 bf16 就是 GB,每个 FFN 都要留一份给反向。micro-batch 翻倍,激活翻倍——这就是 80 GB 卡上「只能开 4 个 micro-batch」的算术来源。
失败条件:若某个 micro-batch 只剩 个 token(不整除的尾批),同一层 GEMM 的算术强度掉到约 ,跌破拐点 ,同样的 FLOPs 要付带宽时间。兜底是让 micro-batch 整除、或把尾批 pad 到固定形状。
6. 常见误区
- 误区:FLOPs 越高的运算越慢。 纠正:GEMM 的 FLOPs 是 ,但每个字节复用 次,实际吞吐可以接近峰值;GEMV 的 FLOPs 少,却被带宽卡死。
- 误区:GPU 快是因为核心多。 纠正:核心多只提供峰值算力;能否达到峰值取决于算术强度、分块、寄存器占用与内存合并访问。
- 误区:分块越大越好。 纠正:tile 受共享内存、寄存器数量、occupancy 限制;过大 tile 会让并行度不足、边界浪费增加。
- 误区:batch 越大,推理一定越快(每秒 token 数)。 纠正:增大 batch 提高 AI,但也会增加每步延迟与显存占用;吞吐与延迟是两条曲线。
7. 概念网络
- 前置:3.3 矩阵乘法 —— GEMM 就是批量矩阵乘法。
- 前置:10.2 矩阵范数与条件数 —— 数值稳定性和精度决定能不能用低精度张量核。
- 后续:10.5 稀疏矩阵 —— 当大部分乘数是 0 时,GEMM 的「高复用」假设失效。
- 关联:11.2 线性层 —— 每个线性层都是一次 GEMM。
- 关联:11.7 KV Cache —— 解码的瓶颈从算力转向带宽。
- 关联:11.4 Attention —— 与 是 batched GEMM。
8. 通往大模型:prefill 与 decode 是两种负载
出现位置一:线性层。 一个 token 的隐藏状态是 ,一层 FFN 是 、。把 个 token 堆成 ,就是两次 GEMM: 与 。、 时,单次 GEMM 的 FLOPs 是 。
出现位置二:prefill 是计算受限。 、、 时 ,矩阵足够「胖」,AI 远高于拐点,GPU 能跑满张量核。这时提升吞吐靠更大的 batch、更快的卡、更低的精度(bf16/fp8)。
出现位置三:decode 是访存受限。 每生成一个 token,,要读完整层权重。7B 模型 bf16 约 GB,按 TB/s 读一遍是 ms,理论上限约 token/s;按 TB/s 则约 token/s。这就是「decode 速度 ≈ 带宽 / 模型字节数」的由来。 KV Cache 也要读:、、、 时每 token 的 KV 约 KB,长上下文下它甚至超过权重流量。
出现位置四:张量核与精度。 bf16/fp16 的 MMA 指令以 fp32 累加,吞吐通常是 fp32 CUDA 核心的数倍到十几倍。代价是输入先被舍入(第 10.1 节);若某层 很大,低精度的误差会被放大(第 10.2 节)。这就是混合精度要保留 fp32 主权重的原因。
可检验结论:对固定模型,decode 的 token/s 上界近似为「显存带宽 ÷ 每步需读字节数」,与峰值 FLOPs 基本无关;prefill 的吞吐则随 增大而上升,直到计算受限。你可以在 lab10 里用不同 的 GEMM 计时看到这条曲线: 从 1 增到 1024,GFLOPS 从「带宽限制」爬升到「算力平台」。
如果这一步算错,用户会看到什么。 训练侧:GPU 利用率忽高忽低(同一个 step 有时跑满张量核、有时只有峰值的一小部分),扩 batch 后吞吐不升反降,或者 OOM 出现在「形状不能被 tile 整除」的最后一个 micro-batch。推理侧:首 token 延迟正常(prefill 计算受限),但每秒 token 数远低于「带宽 ÷ 模型字节数」的估算,说明 decode 被切成了太多小 kernel,或 KV Cache 的读写没有合并。这些都是形状与分块的问题,不是「GPU 不够快」。
9. 练习
- 概念:为什么 BLAS Level 3 比 Level 2 更容易跑满峰值?用算术强度解释。
- 计算: 的 fp32 GEMM,FLOPs、最小访存字节数、算术强度各是多少?在 TFLOPS/ TB/s 的机器上,理论时间是算力还是带宽决定?
- 计算:解码时 、,权重 bf16。算术强度约多少?若带宽 TB/s,读一遍权重最少多少时间?
- 场景:、、 的一层 FFN(),两次 GEMM 共多少 FLOPs?若 GPU 峰值 TFLOPS,理论最短时间是多少?
- 开放:分块尺寸 越大,AI 越高,但为什么不能一直增大?列出至少三个限制,并说明它们如何影响实际 kernel。
参考答案
- Level 2 每读一个矩阵元素只做 次乘加,AI 约 1;Level 3 的每个元素可被 个输出复用,分块后 AI 为 。AI 越高,越容易越过 Roofline 拐点、进入算力受限区。
- FLOPs ;字节 ;AI FLOP/byte。拐点约 ,所以计算受限。算力时间 ms,带宽时间 µs。
- FLOPs ;权重字节 ;AI 约 。带宽时间 µs。
- 第一次 ,第二次形状对称、FLOPs 相同,共约 。按 TFLOPS 理论 ms(实际还受访存、softmax、归一化等影响)。
- 共享内存/寄存器容量限制 tile 大小;occupancy 与并行度会随 tile 增大而下降;边界 tile 在 不能被 整除时浪费算力;此外还有 L2 容量、银行冲突、指令级并行等。实际 kernel 要在这些约束下搜索 tile 与流水线深度。
10. 一页速记
- GEMM:,、、,FLOPs 。
- BLAS L1/L2/L3 分别对应向量、矩阵-向量、矩阵-矩阵;只有 L3 有高复用。
- 算术强度 = FLOPs / Bytes;Roofline 时间取「算力」与「带宽」两个上界的较大者。
- 分块让 AI 从 升到 ; 时约 FLOP/byte。
- prefill 计算受限、decode 访存受限;decode 速度上界约为带宽除以每步读取字节数。
- 物理意义 / 现实对应:算术强度 = 每搬 1 字节能换多少次浮点运算;拐点 = 峰值算力 ÷ 带宽,是「算得动」与「搬得动」的分界线。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、定理名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- Lawson 等(1979):Basic Linear Algebra Subprograms for Fortran Usage。BLAS 的原始接口规范,本页 §2.2 的 Level 1/2/3 分层由此而来。ACM Transactions on Mathematical Software
- Dongarra 等(1990):A Set of Level 3 Basic Linear Algebra Subprograms。Level-3 BLAS(GEMM 一族)的标准化,让厂商可以针对矩阵-矩阵乘写专用 kernel。ACM Transactions on Mathematical Software
- Williams, Waterman & Patterson(2009):Roofline: An Insightful Visual Performance Model for Multicore Architectures。Roofline 模型与「拐点」的出处,本页 §1.2 直接使用。Communications of the ACM
- Strassen(1969):Gaussian Elimination Is Not Optimal。矩阵乘法可以少于 次标量乘,说明 GEMM 的「计算量」本身也是可优化的对象。Numerische Mathematik
下一篇 → 10.4 迭代法与共轭梯度
随堂测 · 5 题
源文件:10-数值线性代数/03-BLAS与GEMM.md