11.5 位置编码与 RoPE 的旋转矩阵
本节位置:模块 11 · 大模型专题 | 前置:1.6 | 预计:35 分钟
一句话:attention 本身不知道词的顺序;RoPE 用「按位置旋转 Q/K」的方式把相对位置写进点积里,而且不增加任何参数。
0. 场景引入
「猫追狗」和「狗追猫」的 token 集合相同,attention 只看内容时输出一样——顺序信息必须由外部注入。早期 Transformer 把位置向量直接加到 embedding 上(Vaswani 等, 2017):( 是位置向量),而 RoPE 换成了旋转。
现在有一个具体现场:一个代码助手要给整个仓库做问答,仓库是 3.2 万 token 的源码加文档;模型训练时的上下文只有 8000,,,32 层。
上线前要拍板:把位置 0 到 31999 直接喂进去(裸外推),还是先把位置除以 4(位置插值 PI),还是把 base 从 1 万调到 4 万(NTK-aware 缩放)?
裸外推的代价可以算出来。最低频那一对的角速度是 rad/token;训练最长 8000,它只转过 rad。推理到 32000,同一维要转到 rad——模型从没见过这个角度,注意力打分会系统性偏移。表现不是报错,而是复读:助手在 2 万 token 之后开始反复输出同一行 import。
位置插值把角度压回 rad,代价是相邻 token 的角差也缩小 4 倍,代码缩进这类短距离线索先变模糊。重训一个 32k 上下文的模型,按 8 张卡跑两周、每卡每小时 8 元估算,约 2.1 万元——这才是绕不开的成本。
问题:为什么旋转能让点积只依赖相对位置?插值到底改了什么、没改什么?
读完本节,你能回答的三个问题是:
- RoPE 用旋转代替相加,换来了什么代数性质;
- 相对位置性质怎么从 推出来;
- 长上下文外推时,插值、调 base、重训各自的代价与失效边界。
1. 直觉
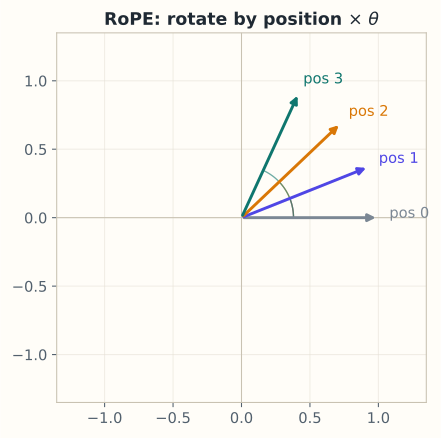
想象每个 token 的 Q/K 是一根指针。位置 0 不旋转,位置 1 转 ,位置 2 转 ……
当位置 的 query 与位置 的 key 做点积时,两者的夹角里包含 。绝对位置被旋转「抵消」了,只剩相对差。
💡 一句话直觉:RoPE = 按位置旋转 Q/K;点积自动变成「相对位置的函数」。
类比边界:旋转是正交变换,保长度、保夹角;它不改变向量的「内容」,只改变方向。不同维度对(频率)可以有不同的 。
1.1 它在现实世界里对应什么
RoPE 像一排转速不同的表盘:每一对维度是一只指针,位置是时间,第 只表盘的角速度是 ;token 在位置 时,指针转过 。两个 token 的匹配分数只看两只指针的夹角,而夹角只由「时间差」 决定。
量级上,、base 时,最快的表盘 rad/token,转一圈只要 个 token;最慢的 ,转一圈要约 个 token。快表盘分辨相邻词序,慢表盘分辨段落级远近——这就是「多尺度」的具体含义。
这个类比在哪里失效:表盘可以无限精确地读数,而 fp32 存 时, 大、 小,相位分辨率会被尾数吃掉;更重要的是,模型只在训练见过的角度区间里学过「怎么读表」,转到新角度并不自动正确。
2. 定义
2.1 二维旋转
性质:,,。
2.2 RoPE 的频率
把 维分成 个二维对。第 对的旋转角:
位置 的总旋转:
对 query/key:
2.3 相对位置性质
右边只依赖 ,不依赖绝对位置 。
2.4 实现形式
对每一对 :
通常只对 Q、K 应用,不对 V 应用。
3. 为什么这样定义
为什么旋转而不是相加?
- 旋转是正交变换,不改变向量长度,数值更稳定;
- 点积自然产生相对位置项,不需要额外的相对位置表;
- 没有可学习参数,不增加模型大小;
- 不同频率的对可以编码不同尺度的位置(类似傅里叶特征)。
相对位置不是 RoPE 的首创:Shaw 等, 2018 已经给注意力打分加上可学习的相对位置向量;区别在于那是「加一张表」,RoPE 是「乘一个旋转」,不需要额外的位置参数。
为什么只对 Q/K? 位置影响的是「谁该关注谁」,即匹配分数;V 是内容,不需要旋转。若旋转 V,输出会被位置「污染」。
3.1 反事实:用「加绝对位置」代替旋转
假设不用旋转,而是给 Q/K 加上位置向量:,。展开内积:
后三项分别依赖 、 和 ,没有一项能写成 的函数。取最简单的 、,分数就是 。
手算两组「相对距离都是 1」的位置: 得 ; 得 。同一个相对距离,分数差了 1700 多倍;而且分数随绝对位置平方增长,两个位置相差几十,logit 就差出几千,softmax 直接饱和成 one-hot;若再省掉减最大值, 还会溢出成 nan。
这就是「相加」和「旋转」的分水岭:加法把位置混进内容,内积里多出 、 的交叉项;旋转是正交变换, 把交叉项结构性地消掉,且 ,分数不会随位置膨胀。
代价也要承认:要真正做到「只依赖相对位置」,Q 和 K 必须转同样的角度、用同一组频率;只转 Q 不转 K, 单独留在内积里,性质立刻失效(见练习 4)。
4. 性质与推导
4.1 正交性
,所以 。RoPE 不改变 Q/K 的范数,只改变方向。
4.2 相对位置
上面的推导:
因此内积只依赖 。
4.3 远程衰减
不同频率的旋转叠加,使远距离位置的内积倾向于更小(类似「相对位置越远,相关性越弱」的先验)。这不是硬约束,而是频率设计带来的偏好。
4.4 外推与插值
训练长度之外, 与 的组合可能超出训练分布。常见做法:位置插值(把 缩放)、NTK-aware 调整 base、YaRN 等。它们改的是频率/位置映射,不改变 RoPE 的代数结构。
4.5 计算
对每个 token、每个 pair 做一次 2×2 旋转:,相比 attention 的 可忽略。
5. 例子
5.1 手算:二维旋转
设 ,位置 ,:
设 ,位置 ,则 。
用相对位置公式:,,一致。
5.2 手算:两个频率
,:
位置 :第一对转 rad(约 ),第二对转 rad。 高频对区分近距离,低频对区分远距离——这就是「多尺度」。
5.3 场景:为什么 RoPE 不增加参数
位置编码若用可学习表,长度 个参数,且无法外推。RoPE 只有固定的三角函数,参数量为 0,长度由 与位置计算决定。
5.4 场景闭环:8k 训练、32k 推理,位置怎么映射
回到第 0 节的代码助手。 层, 个头,,训练长度 8000,推理 ,fp16。
输入:,,base ,,。
计算:
- RoPE 本身的乘加:每 token 每对 4 次乘法加 2 次加法(约 6 FLOP),Q、K 各一遍: FLOP,约 0.8 GFLOP。
- 同一次前向的 attention: FLOP,约 540 TFLOP。RoPE 只占约 。
- 角度检查:最低频 ,位置 32000 时转 rad,训练最多只到 rad;位置插值取 ,,角度正好回到 rad。
- KV Cache:。
输出决策:选位置插值 加少量继续训练,而不是裸外推;若 16 GiB KV 仍放不下,先上 GQA 或 KV 量化,再考虑缩短上下文。
成本:PI 把相邻 token 的角差压缩 4 倍,最快那维从 1 rad/token 变成 0.25 rad/token,「相邻两词」的分辨率下降,短距离语序(缩进、括号配对)最先受影响;继续训练 2000 步的算力,按 8 卡跑 2 天、每卡每小时 8 元估算约 3000 元。
失败条件与兜底:PI 只保证角度落在训练区间,不保证 attention 在新长度上仍然锐利;超过 4 倍(如 64k)时低频维又出界。兜底有两条:NTK-aware 按频率分配缩放(高频少缩、低频多缩),或改成检索式选段——先用 BM25/向量召回挑出 8k 相关片段,从根本上不让位置出界。
6. 常见误区
-
误区:RoPE 是把位置向量加到 embedding 上。 纠正:RoPE 是旋转 Q/K,不是相加;相加式位置编码是另一类方法。
-
误区:RoPE 对 V 也旋转。 纠正:通常只旋转 Q、K;旋转 V 会改变内容表示,破坏「value 传递内容」的语义。
-
误区:RoPE 编码的是绝对位置。 纠正:虽然旋转角由绝对位置决定,但点积只依赖相对位置;这正是它的设计目的。
-
误区:RoPE 可以无限外推。 纠正:代数上相对位置仍成立,但频率与训练分布不匹配会导致性能下降;需要插值/调整 base 等方法。
7. 概念网络
- 前置:1.6 正交与投影 —— 旋转保长度。
- 前置:6.4 谱定理 —— 正交矩阵的结构。
- 后续:11.7 KV Cache —— 缓存的是旋转后的 K。
- 关联:11.3 Attention —— RoPE 作用于 Q/K。
8. 通往大模型:形状与实现
形状:RoPE 不改变形状,只改变数值:
实现(成对旋转):
def rope(x, positions, base=10000.0):
    # x: [..., T, d_k]
    d = x.shape[-1]
    i = np.arange(0, d, 2)
    theta = base ** (-i / d)             # [d/2]
    ang = positions[..., None] * theta   # [..., T, d/2]
    cos, sin = np.cos(ang), np.sin(ang)
    x1, x2 = x[..., 0::2], x[..., 1::2]
    out = np.empty_like(x)
    out[..., 0::2] = x1 * cos - x2 * sin
    out[..., 1::2] = x1 * sin + x2 * cos
return out可检验结论:对任意位置 , 只依赖 。可固定 ,改变 但保持差不变,验证内积不变。
算错时用户看到什么:只旋转 Q 不旋转 K,相对位置性质失效,长文里代词指代会错乱,用户看到「它」指到了错误的段落;把 base 从 写成 或 ,各频段的角速度整体错位,短文本还正常、一到几千 token 就开始复读;cos/sin 表按训练长度预计算并缓存,推理超过该长度却复用旧表,超出部分会被静默截断成同一个位置——不报错,只是所有长距离信息都消失了;用 fp16 存大位置的相位, 的有效位数不够,远距离 token 几乎无法区分。
9. 练习
- 概念:RoPE 为什么不增加参数?它和可学习位置编码的本质区别是什么?
- 计算: 作用于 ,结果是什么?
- 计算:验证 (用 矩阵乘法)。
- 场景:如果只对 Q 旋转、不对 K 旋转,相对位置性质还成立吗?
- 开放:长上下文外推时,为什么「调整 base」可能有效?它改变了什么?
参考答案
- 角度由位置和固定频率算出,无学习参数;可学习编码有一张 表,且不能自然外推。
- 。
- 用和角公式展开即可;几何上先转 再转 ,净旋转 。
- 不成立; 只作用于 Q,内积会依赖 和 的绝对位置组合。
- base 控制频率间隔;增大 base 让低频变化更慢,使训练长度外的位置角变化更平缓,从而缓解分布外推问题,但不改变 RoPE 的代数形式。
10. 一页速记
- RoPE:对 Q/K 按位置旋转,。
- ,点积只依赖相对位置。
- 正交、保范数、零参数、只作用于 Q/K;形状不变,按二维对旋转。
- 外推需插值/调 base,代数性质不保证泛化。
- 物理意义 / 现实对应:每对维度是一只匀速转动的表盘,位置是时间,相对位置是两只表盘的夹角。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、定理名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- Su 等(2021):RoFormer: Enhanced Transformer with Rotary Position Embedding。RoPE 的原始论文:用二维旋转矩阵按绝对位置旋转 Q/K,使内积只依赖相对位置 ,且不引入可学习参数。arXiv:2104.09864
- Shaw 等(2018):Self-Attention with Relative Position Representations。让相对位置进入自注意力的早期方案:给 key 加上可学习的相对位置向量(等价于在注意力打分上加位置偏置);本页的旋转是同一目标的另一种(乘法)实现。arXiv:1803.02155
- Vaswani 等(2017):Attention Is All You Need。原始 Transformer 用正弦/余弦函数把绝对位置加到 embedding 上,正是第 0 节所说「相加式位置编码」的出处。arXiv:1706.03762
下一篇 → 11.6 LayerNorm 与 RMSNorm 的几何
随堂测 · 3 题
源文件:11-大模型专题/05-位置编码与RoPE.md