9.4 白化:去相关与尺度归一
本节位置:模块 9 · 概率与统计 | 前置:9.3 PCA | 预计:35 分钟
一句话:白化 = 先旋转到主成分方向,再把每个方向缩放到方差 1;它把协方差矩阵变成单位阵,而不只是把每一维除以自己的标准差。
0. 场景引入
手机修图 App 的「一键油画」在晚上 8 点迎来高峰,每分钟有 1 200 次导出。中端机上从点「开始」到出图只有 150 ms 预算,而一次网络前向就要 75 ms——留给「把内容变风格」的只剩一半。
做法是从一个轻量 VGG 的 relu3_3 取特征:256 个通道、32×32 个位置,记成 。要传的不只是颜色,还有笔触的方向性——它藏在通道两两之间的协方差里。协方差是 ,65 536 个数,fp32 占 256 KiB。
两条路摆在这里:
- AdaIN:每个通道减均值、除标准差, 次运算;
- WCT:估协方差,用 白化,再用风格图的 上色;一层要做 3 次 的矩阵乘(估协方差、白化、上色),约 次乘加,按中端机有效 20 GFLOP/s 估约 20 ms。
四层全做 WCT 是 80 ms,加上前向正好越过 150 ms;只做一层,输出是「上了色的模糊照片」,笔触的斜向相关传不过去。
决策:哪几层用 WCT、哪几层退回 AdaIN?代价很具体:超时,用户划走,这次推理白算;省过头,差评里全是「不像油画」。还有一层风险:白化矩阵 只在 估得足够好时靠谱,估错了,画面会冒出彩色噪点。
读完本节,你能回答的三个问题是:
- 为什么「每维除以标准差」不够,协方差还会斜?
- PCA 白化与 ZCA 白化都得到 ,什么时候该用哪个?
- 白化为什么在大模型里换成了 LayerNorm?
1. 直觉
白化分两步:先用 PCA 把坐标轴转到特征向量方向(此时各维不相关),再把每个方向除以自己的标准差 ,让方差都变成 1。
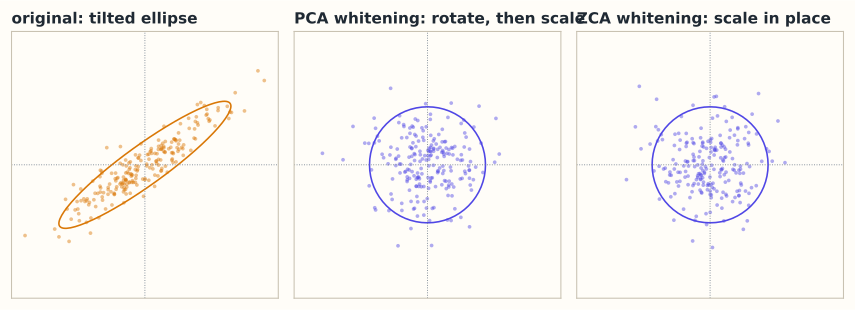
图:PCA 白化先旋转再缩放;ZCA 白化只缩放,尽量少动原坐标方向。
PCA 白化先把椭圆转正再压圆;ZCA 白化不转,直接把椭圆「揉」成圆,所以输出还保留原来的方向感。
💡 一句话直觉:白化是「把协方差矩阵变成 」的线性变换;PCA 白化负责转正,ZCA 白化负责少动原坐标。
1.1 它在现实世界里对应什么
回到那个油画功能。白化在这里不是抽象的预处理,它是把内容的「纹理配方」倒掉、换成风格的配方:
| 数学对象 | 风格迁移里的对应物 |
|---|---|
| 特征图 | 一张图在 relu3_3 的响应: 种纹理模板, 个位置 |
| 协方差 | 「哪些纹理同时出现」——比如斜笔触总伴着暖色 |
| 特征向量 | 一组总是一起变强、一起变弱的通道组合;对应特征值大 = 这个模式占的方差多 |
| 白化 | 把每种模式的强度拉平:只留「有没有这个方向」,不留「有多猛」 |
| 上色 | 把风格图的相关结构贴回内容图的位置上 |
| 只标准化(AdaIN) | 只对齐每个通道的均值和方差,通道之间怎么一起变,不管 |
图中那条从斜椭圆到正圆的变换,就是这里的 :内容的通道 1 变强时通道 2 也跟着变强,白化把这个「一起」拆掉,剩下两个各自独立、方差为 1 的方向。
1.2 这个类比在哪里失效
白化只对齐二阶统计,不管位置。 协方差把 个位置压成一个 矩阵,空间布局在这步全丢了。所以纯 WCT 的结果会「纹理对了、脸糊了」;工程上要保留 skip connection,或只在深层做白化。
相关不等于风格。 白化保证「通道一起变的程度」和风格图一致,但笔触的相位、笔画走向、留白节奏都在高阶统计里。两个人用同样的协方差,画出来的东西可以完全不同。
白化不保证独立。 只有数据本身是高斯时,不相关才等价于独立;对一般分布,白化后仍可能有高阶依赖。
1.3 量级直觉
时协方差有 个数(256 KiB), 时是 个数(64 MiB)——协方差的规模是通道数的平方,这是白化所有成本问题的源头。估计误差方面,单个相关系数的标准误约 : 时约 3%,还算能忍;若换到大模型那种 、每个 batch 只有 1000 个 token 的情形,样本数比参数个数少两个数量级, 直接奇异,白化矩阵根本估不出来。
2. 定义
2.1 目标
给定 ,均值 、协方差 。白化(whitening) 是找可逆矩阵 ,使
读法:变换后每个分量方差为 1,且两两协方差为 0。
2.2 PCA 白化
对 ,令 ,即先旋转到主成分轴、再按 缩放。输出坐标的含义是「沿第 个主成分走了几个标准差」。
2.3 ZCA 白化
,即 的对称逆平方根。它同样把协方差变成 ,但输出仍在原坐标系方向。两者只差一个旋转:,。
2.4 只标准化
标准化(standardization) 是只把每一维除以自己的标准差:,。得到的是相关系数矩阵,不是单位阵:
非对角的相关性原封不动,这是白化与标准化最关键的区别。
2.5 正则化
若 奇异或接近奇异,用正则化(regularization) ,特征值变为 。这避免除以接近 0 的数,代价是低方差方向不再被完全压平。
3. 为什么这样定义
为什么要求协方差为单位阵? 许多算法的最优性分析假设各向同性:最小二乘误差、梯度下降曲率、高斯似然、距离度量。若协方差是 ,欧氏距离就是「标准差单位」下的距离,各方向权重相同。
为什么有两种白化? 白化的解不唯一:任何 左乘正交矩阵 , 仍成立。PCA 白化选 让输出轴对齐主成分;ZCA 白化选 ,让 对称、且离单位阵最近。
为什么 ZCA 保留更多原方向? 在所有白化矩阵中, 使 最小(可以证明,直观上它不额外旋转)。所以图像预处理、卷积网络可视化常用 ZCA:白化后的图还像原图,只是对比度被拉平。
为什么大模型不直接白化? 是 , 时 1677 万个数,求逆/特征分解 ,每 token 还要 矩阵乘法。LayerNorm 只算标量均值和方差,,便宜三个数量级;白化还依赖 batch 统计,训练/推理分布不一致时不稳定。
3.1 反事实:只除以方差不去相关,椭圆仍斜
「各维除以自己的标准差」听起来已经很像归一化了。用 5.1 那个 走一遍,看它到底做了什么。
两维方差都是 2,所以 ——它就是一个整体缩放,把整个椭圆缩小 倍,形状、倾角、条件数一个都没变。验证一下协方差:
非对角项 原样留着,相关系数还是 。这个矩阵的特征值是 与 ,在这个等方差例子里条件数仍是 3;它的 等高线还是沿 的斜椭圆,半轴 与 。
手算两个点就更清楚。原椭圆长轴上的 点 ,标准化后是 ,长度 ;短轴上的 ,标准化后是 ,长度 。两个同在 等高线上的点,标准化后一个落在 1.22、一个落在 0.71——椭圆只是被按比例缩了,斜还是斜的。这就是只标准化最典型的错觉:你以为在把椭圆压成圆,其实只是把画面整体调暗了一点。
反事实 B:把 当成白化矩阵。 白化因子是 次方,不是 次方。对同一个 ,取 ,则
它的特征值是 与 :长轴方向的方差从 3 变成 ,短轴方向反而保持 1。方差没被拉平,只是把长短轴倒过来,条件数还是 3。 是「除以协方差」, 才是「除以标准差」。
两个反例合起来说明:白化要同时做两件事——旋转去相关、按平方根缩放到方差 1;少一件,椭圆就还在。
4. 性质与推导
4.1 PCA 白化确实得到单位阵
,中间用到 。只要 ,白化就成立。
4.2 ZCA 是白化且对称
,且 。对称性意味着它不引入额外旋转。
4.3 条件数变为 1
协方差的条件数(condition number) 衡量「最胖方向比最瘦方向胖多少」。白化后所有特征值都是 1,;二次型 的等高线从椭圆变成圆,梯度下降不再被狭长方向拖慢。
4.4 噪声与高斯
可逆,理论上不丢信息。但数值上, 很小时 很大,会把该方向噪声放大:若 ,噪声被放大 1000 倍。这就是实践中要加 、或干脆不做全白化的原因。
若 ,白化后的 。这正是 9.2 中「把椭圆变回标准圆」的操作,也是生成模型「从标准正态采样、再乘 变回数据分布」的逆过程。
5. 例子
5.1 手算:
特征值 ,特征向量 、。
PCA 白化:
对 :。点在长轴上,所以第二坐标为 0。
ZCA 白化:,故 。方向仍是 ,只是长度从 缩到 1——这就是「ZCA 保留原方向」的具体含义。
只标准化:除以 得 ,协方差变为 ,相关性还在。
5.2 场景:WCT 的两步——先白化内容,再上色
假设某一层只有两个通道。内容特征图的协方差是 ;风格图那一层的两个通道几乎独立,协方差是 。取内容特征图上的一个点 ,它正好在内容的长轴上。
第一步,白化:。用 5.1 的 算得
第二步,上色:。
读法:内容里那个「两通道一起变强」的模式,被整个搬到了风格的第 1 通道上,因为风格的第 1 通道方差大(3),是它的主笔触方向。上色后协方差正好是风格协方差:
如果只做 AdaIN:逐通道除以 , 变成 ,协方差仍是 。风格图里「第 1 通道强、第 2 通道弱」的结构根本没传过去——这就是「颜色像、笔触不像」的数学原因。
5.3 场景闭环:150 ms 里放几层白化
输入:512×512 照片,主干是 stride-16 的轻量 VGG,四层特征中最贵的 relu3_3 是 、。一张特征图 fp32 占
四层合计约 4 MiB——白化要处理的,就是这些 的矩阵。
计算:一层 WCT 有三笔 的乘法——估协方差、白化、上色,各 次乘加,共 ;特征分解 ,只占 8%。按有效 20 GFLOP/s,一层约 20 ms。AdaIN 一层约 次乘加,可以忽略。
输出:决策是「哪几层用 WCT」。前两层 WCT、后两层 AdaIN: ms,加前向 75 ms 共 115 ms,落在 150 ms 内。四层全 WCT 是 ms,超预算 5 ms——为了这 5 ms,要么砍掉一层白化,要么降到 448×448。
成本:每层多 256 KiB 协方差和一次 特征分解,峰值内存多约 1 MiB,中端机扛得住。真正的代价是 40 ms 的墙钟时间,它把「边拍边转」变成「拍完再等 0.1 秒」。
失败条件与兜底:
- 纯色区域(天空、白墙):某些通道方差接近 0, 把传感器噪声放大成彩色斑点。兜底:, 取 ,或截断 的方向。
- 位置太少:在 的特征图上估 256 维协方差,只有 64 个样本, 的秩最多 63,必奇异。兜底:只在大特征图上做白化,小特征图退回 AdaIN。
- 对称性被浮点破坏: 轻微不对称时
eigh仍能跑,但特征向量会成对翻转,相邻两帧的白化结果抖动。兜底:分解前先做 。 - 风格图本身接近纯色: 近似奇异,「上色」这一步会把内容压扁。兜底: 也加 ,或在前端检测到风格图方差过低时直接拒绝该风格。
6. 常见误区
- 误区:白化就是把每维除以标准差。纠正:那只是标准化,协方差仍是相关系数矩阵;白化还必须旋转去相关,需要特征分解。
- 误区:白化后各维独立。纠正:只保证不相关;非高斯数据白化后仍可能有高阶依赖。
- 误区:PCA 白化和 ZCA 白化结果一样。纠正:协方差都变成 ,但输出相差旋转 ;PCA 轴对齐主成分,ZCA 保留原方向。
- 误区:白化总能加速训练。纠正:它改善条件数,但放大低方差方向的噪声、增加 开销、依赖 batch 统计。
7. 概念网络
- 前置:9.3 PCA —— 特征分解给出旋转与缩放两个因子。
- 前置:9.2 多元高斯 —— 白化把 变成 。
- 前置:7.2 SVD 的计算与性质 —— 可用 SVD 稳定计算。
- 关联:8.7 梯度下降与牛顿法 —— 条件数决定收敛速度。
- 关联:11.6 LayerNorm 与 RMSNorm —— 更便宜的部分归一化。
- 易混:BatchNorm —— 按特征维统计 batch,仍不做去相关。
8. 通往大模型:为什么是 LayerNorm 而不是全白化
出现位置:激活归一化。LayerNorm 在每个 token 的 维向量上算一个标量均值和一个标量方差,再逐元素缩放;白化则要在整个数据集上估计 协方差并做矩阵乘法。
形状:一个 token 的激活 ,LayerNorm 为
是标量,成本 ,与 batch 无关。全白化需要 与 ,每 token 矩阵乘法 ; 时每 token 约 1677 万次乘加,而 LayerNorm 约 4096 次。
为什么需要:深层网络里激活尺度会漂移,LayerNorm 把每个 token 拉回单位尺度,稳定训练;它不消除特征间相关,但去掉了「整体过大/过小」这个最主要的病态来源。RMSNorm进一步省掉均值,只除以均方根。
可检验结论:对 个样本做白化,经验协方差的单个元素与 的偏差量级约为 。、 时样本协方差严重欠采样,白化矩阵估计不可靠;这也是全白化在大模型里不实用的原因之一。
import numpy as np
rng = np.random.default_rng(0)
D, N = 8, 20000
A = rng.normal(size=(D, D))
Sigma = A @ A.T + 0.1 * np.eye(D)
X = rng.multivariate_normal(np.zeros(D), Sigma, size=N)   # [N, D]
lam, V = np.linalg.eigh(Sigma)
W = V @ np.diag(1 / np.sqrt(lam)) @ V.T                   # ZCA
Z = (X - X.mean(0)) @ W.T
print(np.cov(Z, rowvar=False).round(2)) # 接近 I与条件数的联系:若激活协方差的条件数是 ,梯度下降在峡谷里要走很多步;LayerNorm 只能把整体尺度拉回 1,不能改变方向间的比例,所以条件数仍可能很大。真正把条件数变成 1 的是白化,代价是 与统计估计误差。
如果这一步算错,下游看到什么现象:白化不是一个会报错的步骤,它只会让下游的表现「说不上哪里不对」。
- 只做了标准化,却以为做了白化:协方差里那 0.5 的相关还在,下游如果假设特征独立(比如朴素贝叶斯、对角协方差的高斯),它的概率估计会系统性偏;训练侧则表现为 loss 一路在抖,调小学习率能压住,但收敛慢一半。
- 用了 而不是 :长轴方向被压过头(上面例子里方差从 3 变成 ),短轴却保持 1,各向异性没消掉、只是方向反了;下游的距离度量被扭曲,长轴方向的标准差被缩小 3 倍,微调时这部分特征基本「死掉」,验证集上看不出错,只是效果上不去。
- 太小或没截断: 时放大 1000 倍,输出里出现成片的彩色噪点;如果 在数值上算成负数, 直接得 NaN,整批激活污染。
- 训练用 batch 统计、推理用滑动平均:两边分布对不上,线上激活的尺度和训练时差一截,表现为离线指标漂亮、一上线就掉点。兜底是推理时用固定的 ,或干脆退回 LayerNorm。
9. 练习
- 概念:白化与标准化都能「让方差变成 1」,区别在哪?各适合什么场景?
- 计算:,求 、,并把 白化。
- 计算:,求 与 ,验证 。
- 场景: 的激活,比较 LayerNorm 与全白化的单 token 计算量与参数量。
- 开放:为什么白化会放大噪声?如果 ,你会怎么处理?
参考答案
- 标准化只除以各维标准差,得到相关系数矩阵,非对角相关仍在;白化还要旋转去相关,得到单位阵。标准化便宜、逐维、适合单位不同但相关性不强的特征;白化昂贵、需要协方差估计,适合确实需要各向同性的算法。
- 特征值 ,方向为标准基。;。
- 特征值 ,方向 、。;。直接乘可验证 。
- LayerNorm:每 token 约 次运算、 个参数();全白化:每 token 次乘加、 个参数(16.7M),约是 LayerNorm 的 4000 倍。
- 白化把每个方向除以 ; 很小时因子巨大,该方向的观测噪声被同等放大。处理:加 (–)、截断小特征值(只保留 )、或改用对角近似/LayerNorm。
10. 一页速记
- 白化:,即 ;PCA 白化 ,ZCA 白化 。
- 两者只差一个旋转 :PCA 输出轴对齐主成分,ZCA 输出更接近原坐标,且 对称、离 最近。
- 标准化只除 ,留下相关系数矩阵;在 这个等方差例子里,它只是把椭圆整体缩到 ,条件数仍是 3;一般情形下标准化只把 换成相关系数矩阵的条件数。用 当白化矩阵则会把长短轴倒过来。
- 代价: 存储、 分解、低方差方向放大噪声;大模型用 的 LayerNorm/RMSNorm 兜底。
- 物理意义 / 现实对应:白化是「把椭圆形的噪声云揉成圆」;在风格迁移里, 倒掉内容图的纹理相关性, 再把风格图的笔触相关性贴回去。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、定理名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- Bell 与 Sejnowski(Anthony J. Bell & Terrence J. Sejnowski, 1997):The “independent components” of natural scenes are edge filters。在 ICA 预处理中提出零相位白化(ZCA),即本页 这种不额外旋转的对称白化。Vision Research(DOI)
- Ba 等(Jimmy Lei Ba, Jamie Ryan Kiros & Geoffrey E. Hinton, 2016):Layer Normalization。提出在每个样本的特征维上做 归一化、不依赖 batch;本页第 8 节的 LayerNorm 公式与成本分析出自这里。arXiv:1607.06450
- Ioffe 与 Szegedy(Sergey Ioffe & Christian Szegedy, 2015):Batch Normalization: Accelerating Deep Network Training by Reducing Internal Covariate Shift。按 batch 统计逐特征归一化,本页把它作为「仍然不去相关」的对照;它依赖 batch 统计,正是训练/推理不一致的来源。arXiv:1502.03167
- Zhang 与 Sennrich(Biao Zhang & Rico Sennrich, 2019):Root Mean Square Layer Normalization。去掉 LayerNorm 的均值项、只除以均方根,本页提到的 RMSNorm 就是它,省掉一次 的均值计算。arXiv:1910.07467
下一篇 → 9.5 马尔可夫链
随堂测 · 5 题
源文件:09-概率与统计/04-白化.md