3.3 矩阵乘法:四种视角
本节位置:模块 3 · 矩阵与线性映射 | 前置:3.2 | 预计:40 分钟
一句话:矩阵乘法是「复合两个线性映射」,行乘列、列组合、行组合、外积和只是同一笔账的四种记法。
0. 场景引入
一个 5G 基站的基带板,每个时隙 0.5 ms 就要重算一次等效信道。链路是串起来的:
是发射预编码(64 根天线、8 层数据), 是空口信道(终端 4 根天线), 是接收合并(4 根天线合成 2 个基带流)。三者相乘得 的等效信道——它决定这 8 层数据能不能被分开。
一个 100 MHz 载波有 3276 个子载波(273 个资源块 × 12),每个都要算一遍 。基带 DSP 的预算是每时隙约 30 MFLOP,折合 60 GFLOP/s。
决定:先算 还是先算 ?两者数学上完全一样(结合律保证),但一个要 次复数乘加,另一个要 次,少 27%;中间矩阵一个 128 个复数、一个 32 个复数,差 4 倍。
代价:等效信道算错,基站会误以为 8 层数据互不干扰,而实际层间干扰有 -10 dB。终端解调误块率从 1% 飙到 30%,用户看到的是视频一直转圈、信号满格却不走流量。
问题:为什么「先乘哪两个」不影响结果,却影响代价?为什么两个矩阵相乘必须是行乘列,而不能逐元素?
读完本节,你应该能回答三件事:
- 四种视角(行乘列、列组合、行组合、外积和)各自回答什么问题;
- 为什么结合律允许你自由加括号,而交换律不允许你换顺序;
- 一次矩阵链乘的 FLOPs 与中间内存怎么估,为什么两者会指向不同的最优括号。
1. 直觉
1.1 四种读法
矩阵乘法有四种读法,它们回答四个不同的问题:
- 行乘列(row times column): 是 第 行与 第 列的点积——「第 个输出对第 个输入通道的总响应」。
- 列组合(columns): 的第 列是 乘 的第 列——「 的第 个输入方向经过 后去哪」。
- 行组合(rows): 的第 行是 的第 行乘 ——「 的第 个输出方向如何混合 的行」。
- 外积和(sum of outer products):——「 个秩 1 矩阵叠加」。
💡 一句话直觉:矩阵乘法 = 先做 再做 ;四种视角是四种「按什么顺序加」的记账方式。
类比边界:这个「复合」解释只对线性映射成立。若中间夹了非线性(ReLU、softmax),就不能合并成一个矩阵;这也正是深度网络不能塌缩成单层的原因。
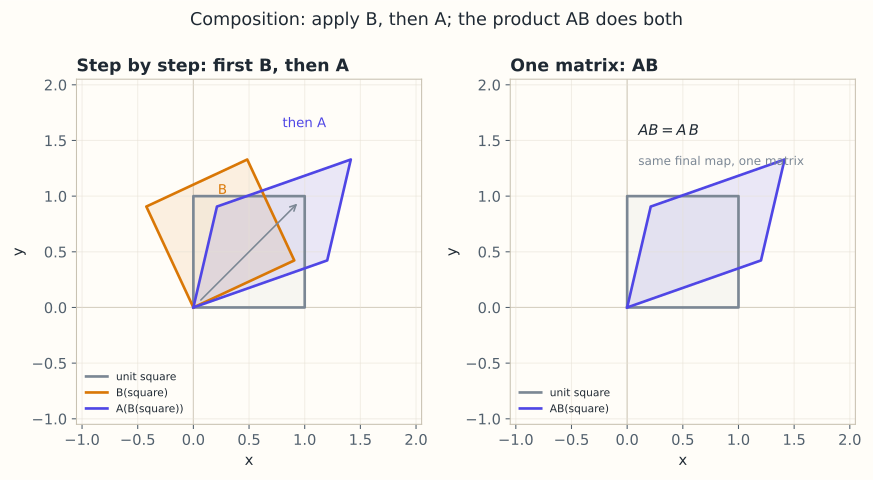
图:为便于画图,这里用 矩阵演示;先作用 再作用 ,与直接乘 得到同一个正方形的像。正文的 与 复合同理。
1.2 现实对应:一条串联的流水线
最简单的复合是两个小矩阵。第一层 把 2 维变成 3 维,第二层 再变回 2 维。输入 先过 再过 ,结果是 。如果有 100 万个 token 要一次算完,你希望有一个矩阵 直接表示「先 后 」,让 对所有 成立——这个 就是 ,形状 。
现实里的每一级都有物理含义。以开头的 5G 链路为例:
- :把 8 层数据「铺」到 64 根天线上(预编码);
- :空口传播,每根发射天线到每根接收天线一条路径;
- :把 4 根天线的信号「压」成 2 个基带流。
乘积 是整条链路的等效映射:给 8 层输入,直接得 2 个基带输出,中间的 64 维、4 维全部被消掉。这也解释了为什么中间维会在形状里消失——。
这个类比在哪里失效:流水线的每一级必须是线性的,才能合并成一个矩阵。实际链路里功率放大器会饱和、ADC 会量化(取整)、相位噪声让 随时间漂移。这些一旦进来,「三级合并成一个矩阵」就不再成立——这也是实际系统必须在每一级留观测点(耦合器、参考信号)的原因。
1.3 量级直觉
一次 乘 的 GEMM,FLOPs 是 ,而参与的三块矩阵按 fp16 存一共 MB。计算/访存比约 FLOP/B——这个数字越大,GPU 越「吃得饱」。
对比矩阵乘向量: 乘一个向量只有 FLOPs,却要读 33 MB 的矩阵,比值只有 FLOP/B。同一个矩阵,乘矩阵比乘向量「划算」一千倍——这就是批处理存在的理由。
2. 定义
2.1 矩阵乘法(matrix multiplication)
设 ,,则 ,其元素为
逐项读法: 的第 个元素,是 第 行与 第 列的长度 点积。形状:,中间维 必须相等,且会在结果里消失。
2.2 四种视角的公式
行乘列:,其中 是 的第 行, 是 的第 列。
列组合:把 按列分块 ,则 的每一列是 ()。
行组合:把 按行分块,则 的每一行是 ()。
外积和:把 按列分块、 按行分块,则 ,其中 是 的第 列, 是 的第 行;每一项 是 的秩 1 矩阵。
3. 为什么这样定义
因为矩阵代表线性映射,而映射可以复合。设 对应 , 对应 ,则复合映射 仍是线性的,必然对应某个矩阵 。这个 就是 。这个「乘法 = 复合」的定义来自 Cayley 1858:他把矩阵乘法写成线性替换的复合,并指出它结合、但一般不可交换。
如果定义成逐元素乘,复合就做不到了:逐元素乘只对同形状矩阵有意义,而且 。矩阵乘法的每个元素都等于「一行 × 一列」,正是为了让 对所有 成立。§4.1 会证明这一点。
为什么中间维必须相等?因为复合要求 的输出维()等于 的输入维()。形状不匹配,映射根本接不上。
3.1 反事实:如果定义成逐元素相乘
取两个 :
行乘列:,,,,即
逐元素:。
现在看复合。取输入 (只开第一层):
用逐元素矩阵作用在同一个 上,取它的第 1 列:
对 , 对 ——差了将近 4 倍和 2 倍,而且偏差随 变(换个 比例就变),不能靠乘一个常数修正。
结论:逐元素乘只在一种情形下等于复合——两个矩阵都是对角的。对角矩阵的复合确实就是逐元素乘(对应位置的比例相乘)。一旦出现非对角项(也就是「不同通道之间的混合」),逐元素乘就把混合关系全部丢掉。这也解释了工程上的分工:缩放可以用逐元素,线性层不行。
4. 性质与推导
4.1 定义是被复合逼出来的
我们希望 。看第 个分量:
把 换成任何别的公式,这一步都走不通。取 还能直接看出: 的第 列必须是 。所以「行乘列再求和」不是任意约定,而是复合映射的唯一矩阵表示。
4.2 四种视角为什么一致
- 列组合与行乘列: 的第 个分量就是 。
- 行组合与行乘列: 的第 个分量也是 。
- 外积和: 的 元素是 。
四种视角只是把同一个三重循环按不同轴分组,结果必然相同。
4.3 运算性质
| 性质 | 式子 | 注意 |
|---|---|---|
| 结合律 | 形状接得上就成立 | |
| 分配律 | 形状必须匹配 | |
| 单位阵 | 左右单位阵尺寸可不同 | |
| 转置 | 顺序反转 | |
| 幂 | 只对方阵 | |
| 不可交换 | 一般 | 甚至可能 无定义 |
FLOPs: 乘 需要 次乘法与 次加法,共 次浮点运算。 乘 是 FLOPs。这个计数不是下界:Strassen 1969 用 7 次乘法完成 分块乘法,把渐近指数降到 。
4.4 零因子的存在
不要求 或 。例如 非零,但 是零矩阵。这说明矩阵乘法没有「消去律」: 不能直接推出 。
用零空间的语言说: 意味着 的每一列都落在 的零空间里,乘积的秩因此被乘掉。秩是刻画「哪些信息被压掉」的不变量,第 3.7 节会用四个子空间把它讲完。
5. 例子
5.1 手算:四种视角算同一个
取
行乘列:,,,。所以
列组合: 的两列是 、,
两列拼起来正是 。
行组合: 的两行乘 :,。反过来, 的第 行也是 的行的加权和,权重是 的第 行:。
外积和:
四种视角完全一致。
5.2 手算:复合映射与 FLOPs
再取 。复合 ,形状 。先算 再乘 结果相同: 的第一行是 ,再乘 得 。这就是结合律。
整个 的计算量约 (先 )加 (再乘 ),共 48 FLOPs;若先算 再乘 ,则要 FLOPs。结合律保证结果相同,但括号化顺序会改变计算量——这就是矩阵链乘顺序优化的入口。
5.3 场景闭环:0.5 ms 里的三次矩阵乘
输入:每个子载波一组 ,形状 、、,复数 fp16(每个复数 4 字节)。共 3276 个子载波。一帧的原始数据 个复数 MB。
计算:两种括号,以复数乘加计:
- : 是 次,再乘 是 次,共 1536;
- : 是 次,再乘 是 次,共 2112。
比值 。乘上 3276 个子载波、2000 个时隙/秒,前者 次复数乘加/秒,后者 。
输出:每个子载波一个 的等效矩阵,送进 MIMO 检测器算后处理信干噪比(SINR),再据此查表选调制编码档位(MCS):SINR 高就上 256QAM,低就退回 QPSK。
成本:一次复数乘加折成 4 次实数乘 + 2 次实数加, 次/秒约合 60 GFLOP/s——正好卡在基带 DSP 的预算线上。省下的那 27% 不是「慢一点」,是「要不要砍掉四分之一子载波、改用插值」。中间内存也指相反: 是 个复数, 只有 个,前者要多占 4 倍片上缓存。FLOPs 最少和内存最少,在这里不是同一个括号——这才是真正的取舍。
失败条件与兜底:
- 信道过期: 是 0.5 ms 前估的。终端以 30 km/h 移动(8.3 m/s),0.5 ms 走 4.2 mm;28 GHz 下波长约 10.7 mm,相位就转了 rad。等效信道已经不对。兜底:退回更保守的 MCS,并加密参考信号。
- 秩塌陷:终端在电梯里,8 层里只有 2 层有能量, 的奇异值从大到小差 30 dB,等效信道接近秩 2。此时按 8 层算出的 SINR 是虚高的,选高档位会大量误块。兜底:用秩指示(RI)反馈,按 的阈值砍层数。
- 预编码量化: 是从码本里选的,不是精确的奇异向量,实际 会偏离设计值几个 dB。兜底:外环链路自适应——根据 ACK/NACK 统计慢慢下调 MCS,用「事后」补「事前」的偏差。
6. 常见误区
-
误区:矩阵乘法可交换。 纠正:取 、,则 ,,不同。
-
误区: 就是对应元素相乘。 纠正:那是 Hadamard 积 ;矩阵乘法的内维会被求和掉。
-
误区: 则 或 。 纠正:§4.4 的反例即可说明;矩阵没有消去律。
-
误区:。 纠正:顺序必须反转,,否则形状常常接不上。
7. 概念网络
- 前置:3.2 矩阵乘向量 —— 是列组合。
- 前置:1.3 点积 —— 行乘列是一次点积。
- 后续:3.4 逆矩阵与可逆性 —— 复合的逆是逆的反序复合。
- 后续:3.5 高斯消元与 LU —— 把矩阵分解成简单矩阵的乘积。
- 后续:3.6 转置、对称与分块 —— 分块乘法与转置。
- 后续:3.7 四个基本子空间 —— 的秩不会超过任一因子。
- 关联:10.3 BLAS 与 GEMM —— 为什么 GPU 为矩阵乘法而生。
8. 通往大模型:GEMM 是训练的计量单位
出现位置:线性层、注意力打分、FFN、输出投影,全部是批量矩阵乘法(batched matrix multiplication),底层调用 GEMM(general matrix multiply)。
形状:一个 batch 的隐藏状态 ,展平成 后与 相乘,得到一个 的中间结果。注意力打分则是 与 相乘,得到 的分数矩阵。
为什么需要:GEMM 的 FLOPs 是 ,而显存访问是 (这套计数与分块实现见 Golub & Van Loan 第 1 章)。矩阵越大,计算/访存比越高,GPU 越能被喂饱。这解释了为什么训练要凑大 batch、为什么推理要合并请求:小矩阵的 GEMM 会被内存带宽卡住。
可检验结论: 的 FFN 升维(),FLOPs 为 ,即约 1.1 TFLOP;若把 batch 减半,FLOPs 减半,但权重读取量不变,所以单位算力的能耗反而上升。大 batch 不只是快,是更省。
如果这一步算错,用户会看到什么现象:括号选错只费电、发热、掉续航,结果完全正确;真正的错是把 当成 ——发射端会误以为各层正交,实际层间干扰压不下去,终端表现为「信号满格但网速很慢」、重传率飙升。最隐蔽的一种是 写成 :顺序一反,等效信道成了它的转置,检测器解出的符号全错,现象不是「有点慢」而是「完全解不出」,此时终端会一直停在搜网状态。
9. 练习
- 概念:用复合映射解释为什么 ,并说明为什么 不影响结合律。
- 计算:,,用行乘列求 ,再用外积和验证。
- 计算:接上题,求 ,比较形状与数值,说明不可交换。
- 计算:、、,求 与 的 FLOPs,哪个更省?
- 开放:为什么 GPU 上的矩阵乘法通常要把矩阵分块(tiling)?分块与「四种视角」中的哪一种最接近?
参考答案
- 复合映射满足 ,而矩阵乘法正是复合的表示,所以结合律成立。 是「先 后 」与「先 后 」不同,不涉及三个映射的结合顺序。
- 。外积和:。
- ,是 ;与 形状就不同,谈不上相等。
- :;:。先算 更省。一般应让中间矩阵尽量小。
- 分块把大矩阵拆成能塞进片上缓存的小块,提高数据复用、减少显存往返;它与「外积和/列组合」最接近——每次取一块 的列块与 的行块做外积累加。
10. 一页速记
- ;形状 。
- 物理意义 / 现实对应:矩阵乘法是「两台机器串联」;现实里就是一条流水线的总传递函数,中间维是流水线的工位数,中间维在结果里消失。
- 四种视角:行乘列、列组合 、行组合 、外积和 。
- 矩阵乘法 = 复合映射:。
- 不可交换、无消去律、。
- FLOPs ;GEMM 是训练算力的基本计量单位。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、定理名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- 凯莱(Arthur Cayley, 1858):A Memoir on the Theory of Matrices。把矩阵乘法定义为线性替换的复合,并指出它结合但一般不可交换;本页 §2.1 的「行乘列」是它的现代写法。Phil. Trans. R. Soc. (1858)
- Golub & Van Loan(2013):Matrix Computations(第 4 版)。第 1 章给出 GEMM 的 计数、分块算法与快速乘法的适用边界,本页 §4.3 与 §8 的算力账以它为准。Johns Hopkins University Press
- 施特拉森(Volker Strassen, 1969):Gaussian Elimination Is Not Optimal。用 7 次乘法完成 分块乘法,证明 不是矩阵乘法的下界。Numerische Mathematik
下一篇 → 3.4 逆矩阵与可逆性
随堂测 · 4 题
源文件:03-矩阵与线性映射/03-矩阵乘法.md