1.4 范数与距离:大小、误差与正则化
本节位置:模块 1 · 向量与几何 | 前置:1.3 | 预计:30 分钟
一句话:范数是「向量有多长」的推广;不同范数定义不同的「长度观」,也塑造不同的机器学习行为。
0. 场景引入
一台 6 轴工业机械臂在装配线上拧螺丝,位置公差 0.5 mm。编码器分辨率 0.001°,在 0.5 m 臂长上折合末端位移 ——单轴精度远远够用,误差主要来自热变形与负载挠曲。
控制器每 1 ms 读一次 6 个关节的偏差向量 ,要立刻决定:继续、减速,还是急停。这里有一个必须做的选择:用哪种范数当「总误差」?
- 用 L2,6 个关节各偏 0.45 mm 时总额是 ,超公差,报警;
- 用 L∞,最大偏差 0.45 mm,没超,继续。
同一条产线,两种判据给出相反的决定。押错的代价:误停一次损失 15 分钟产能;漏判一次可能撞坏夹具,停机 4 小时。
更麻烦的是,控制器不能「两种都算再取严」:L2 在均匀小偏差上过度报警,L∞ 对整体缓慢漂移反应迟钝。选哪个,等于选「宁可误停还是宁可漏判」——这是工艺决策,不是数学决策。
读完本节,你应该能回答三个问题:
- 同一个误差向量在 L1/L2/L∞ 下大小不同,哪个才是「真实误差」?
- 梯度裁剪为什么按全局 L2 范数缩放,而不是逐元素截断?
- L1 为什么能把参数压成精确的 0?
1. 直觉
范数是「长度」这个概念的公理化。在二维平面上,长度就是欧氏距离;但在不同场景下,「长」可以有不同定义:
- L2:直线距离(圆形的等距线);
- L1:沿坐标轴走的总路程(菱形);
- L∞:最大的那个分量(正方形)。
| 范数 | 单位球形状 | 一句话几何 |
|---|---|---|
| L2 | 圆 | 两点之间的直线距离 |
| L1 | 菱形 | 只能沿坐标轴走时的总路程 |
| L∞ | 正方形 | 所有分量里最大的那一个 |
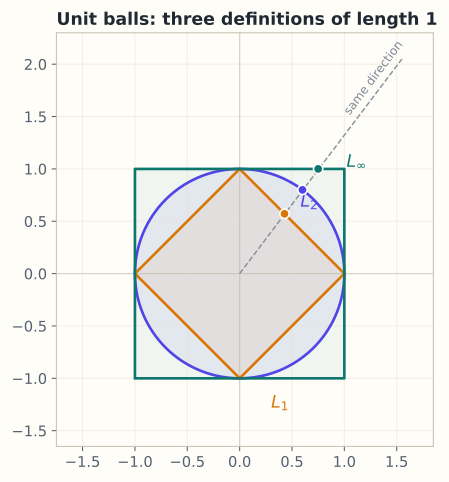
图:同一个方向 与三个单位球相交的位置不同。它的 L2 范数是 、L1 范数是 、L∞ 范数是 ,所以「长度 1」的边界在三种范数下是三种形状。
💡 一句话直觉:范数回答「这个向量有多大」;选哪种范数,等于选哪种「大」的定义。
类比边界:范数只度量大小,不度量方向;方向要用夹角/余弦。
1.1 它在现实世界里对应什么
三种范数是三种「误差包络」:
- L∞ 是立方体:任取一个轴,偏差都不能超过 0.5 mm——这是安全包络,任何一个关节都不许出这个盒子;
- L2 是球:6 个关节偏差的平方和,等价于整体 RMS 抖动,物理上是能量;
- L1 是菱形:各关节偏差绝对值之和,物理上是总行程、总磨损。
量级:0.5 mm 公差在 6 维误差空间里是一个边长 1 mm 的立方体;同一个立方体按 L2 度量,最远的角点长 。所以「L2 报警」与「L∞ 报警」在最坏角点上差 1.22 倍,不是小数点后的差别。
这个类比在哪里失效?范数只给一个数,不告诉你是哪个关节坏了。 与 的 L∞ 都是 0.5,但前者可能是手腕到位、后者可能是底座歪了。要定位,必须回到分量本身。
2. 定义
2.1 范数的公理
映射 是范数,若对任意 和标量 :
- 非负:,且 ;
- 齐次:;
- 三角不等式:。
满足这三条的空间叫赋范空间(normed space),这个概念在巴拿赫 1922 年的论文中成型。
2.2 -范数
对 :
- :;
- :(欧氏范数,默认);
- :。
2.3 距离
范数诱导距离:
它满足非负、对称、三角不等式。L2 距离是直线距离,L1 距离是「曼哈顿距离」。
2.4 矩阵的 Frobenius 范数
就是把矩阵拉直成向量后的 L2 范数。它衡量「矩阵整体有多大」,但不反映矩阵作为变换的放大能力;后者要用谱范数(第 10.2 节)。
3. 为什么这样定义
如果没有「齐次性」,把向量放大 2 倍,长度可能不是 2 倍,就没法用长度做尺度分析。 如果没有「三角不等式」,两点之间走直线可能比绕路更远,「距离」就失去意义。
不同 的选择是建模选择:
- L2 处处可导(除原点),优化平滑,对应高斯先验;
- L1 在 0 点不可导,但会把小分量压成精确的 0,产生稀疏,对应拉普拉斯先验;
- L∞ 只关心最大偏差,适合「最坏情况」约束。
最常见的用法是权重衰减:在损失里加 ,等价于每一步把权重往原点收缩一点。
3.1 反事实:去掉绝对值,或去掉齐次性
反事实 A:直接把分量相加,不取绝对值。 有人会说「总误差不就是加起来吗」:
判据宣布「零误差,完美到位」。实际是 6 个关节各偏 0.4 mm,已经用掉 0.5 mm 公差的 80%,任何一轴再偏一点就超差。荒谬之处一眼可见:一组正负抵消的误差被当成没有误差——这正是公理 1(非负性)要排除的情形。
反事实 B:忘记齐次性。 取 (把平方漏了)。6 个分量各偏 0.1 mm 时 ;恶化 5 倍、各偏 0.5 mm 时 ——读数只涨 2.2 倍。趋势判断全错:磨损在加速,监控曲线却看起来很平。齐次性 保证「放大 5 倍,读数就放大 5 倍」,否则不同量级的误差没法比较。
4. 性质与推导
4.1 柯西–施瓦茨与三角不等式
证明思路:展开 ,用柯西–施瓦茨放缩。
4.2 L2 平方的梯度
这个结论在权重衰减、最小二乘里反复出现。注意 (原点除外)。
4.3 L1 的次梯度
在 处不可导,其次梯度是区间 。这导致 L1 正则化会把参数精确推到 0,而 L2 只会让参数变小、不会精确为零。
4.4 有限维范数等价
在 中,任意两种范数都等价:存在常数 使
例如 。这是数值线性代数讨论误差界的前提,Trefethen 与 Bau 开篇就建立这套范数语言。所以「收敛性」不受范数选择影响,但收敛速度、正则化效果会受影响。
5. 例子
5.1 手算:三种范数
:
5.2 手算:距离
,:
5.3 场景:梯度裁剪
设梯度向量 ,。裁剪到 max_norm=1:
方向不变,长度变为 1。裁剪只改步长,不改方向——这是它比「逐元素截断」更常用的原因。
5.4 场景:RMSNorm
RMSNorm 对每个 token 的隐藏向量 做:
分母是「均方根」(root mean square),即 L2 范数除以 。它不减去均值,比 LayerNorm 少一次统计,计算更省(第 11.6 节)。RMSNorm 由 Zhang 与 Sennrich 提出,动机正是省掉 LayerNorm 的均值统计。
5.5 场景闭环:1 kHz 的关节误差监控
输入:6 维误差向量,1 kHz 采样,8 小时一班共 次判定;每次只碰 6 个 float。
计算:L2 要 6 次乘加 + 1 次开方,L∞ 要 6 次比较,都在几十个时钟周期内算完。算力从来不是瓶颈,瓶颈是判据选错带来的误报与漏报。
输出:每毫秒一个三态决定——继续、减速、急停;急停信号直接进安全 PLC。
成本:以 0.5 mm 为阈值,L2 判据在「6 个关节各偏 0.45 mm」时报 1.10 mm 并急停,L∞ 判 0.45 mm 继续。这类均匀小偏差每班出现 3 次,L2 每天就多停 45 分钟。反过来,单个关节偏 0.9 mm 时两种判据都会报——真正会漏判的是「多个方向同时略超」,而这恰是 L2 的强项。所以工程上常同时算两个:L∞ 管安全,L2 管趋势。
失败条件:
- 单点尖峰:编码器受电磁干扰跳一下,L∞ 瞬间爆表、误急停。兜底:中值滤波 + 连续 3 帧确认。
- 零向量:读数全为 0,或 NaN 被填成 0,L2=0 判「完美」,实际是传感器掉线。兜底:把「全零/NaN」当成独立状态监控,不要混进范数判据。
- 量纲混用:5 个关节是角度(rad)、1 个是直线位移(mm),直接算 L2 等于把 1 rad 和 1 mm 相加。兜底:先用雅可比矩阵把关节误差换到末端笛卡尔空间,再取范数。
6. 常见误区
-
误区: 和 是一回事。 纠正:前者是平方,数值和梯度都不同;优化里常用平方是为了去掉根号,但正则项系数要相应调整。
-
误区:L1 和 L2 只是计算方式不同,效果差不多。 纠正:L1 产生稀疏解,L2 产生小幅收缩;几何上 L1 单位球有尖角,最优解容易落在坐标轴上。
-
误区:归一化(除以范数)对零向量也适用。 纠正:零向量范数为 0,除法无定义;实现里要加 。
-
误区:矩阵的 Frobenius 范数能衡量「矩阵把向量放大多少」。 纠正:Frobenius 是元素层面的整体大小;放大能力要用谱范数 (第 10.2 节)。
7. 概念网络
- 前置:1.3 点积 —— L2 范数由点积诱导。
- 后续:1.5 余弦相似度 —— 用范数做归一化。
- 后续:1.6 正交与投影 —— 用范数度量残差。
- 后续:8.7 梯度下降 —— 步长与范数。
- 后续:10.2 矩阵范数 —— 从向量范数到算子范数。
8. 通往大模型:三个高频出现的地方
1. 梯度裁剪:把所有参数梯度拼成一个大向量,算全局 L2 范数,超过阈值就整体缩放。它防止单个坏 batch 把参数带飞。
2. 权重衰减:AdamW 的 decoupled weight decay 等价于每步做
即把权重向原点收缩,对应 L2 正则。
3. 归一化层:RMSNorm 用均方根代替标准差;LayerNorm 先中心化再除以标准差。二者都让表示落在「尺度受控」的区域,避免深层网络数值爆炸。
可检验结论:对 ,RMSNorm(,忽略 )输出 ,其 L2 范数为 ,而不是 1——因为 RMSNorm 归一化的是「每个分量的均方根」,不是向量长度。
如果这一步算错,用户会看到什么:梯度裁剪若按 per-tensor 而不是全局范数,训练会在长尾 batch 上反复出现 loss 尖峰,用户侧表现为「模型时而答非所问、重试一次又好了」。RMSNorm 若把 放到根号外(),小范数 token 的缩放会突然放大,长文本生成时偶发 NaN,用户看到的是答到一半变成一串重复标点。
9. 练习
- 概念:用自己的话解释为什么 L1 正则化能产生稀疏解,而 L2 不能。
- 计算:,求 。
- 计算:,裁剪到 L2 范数 2,结果是多少?
- 场景:为什么梯度裁剪通常按全局范数缩放,而不是逐元素截断到 ?
- 开放:RMSNorm 不减去均值,会带来什么好处和潜在代价?
参考答案
- L1 的等值线是菱形,与损失等高线相切处容易落在坐标轴上,使某些分量为 0;L2 是圆形,切点一般不在轴上。
- L1=5,L2=3,L∞=2。
- 原范数 13,缩放因子 ,结果 。
- 全局缩放保持梯度方向,只控制步长;逐元素截断会改变方向,可能破坏更新的一致性。
- 好处:少一次均值计算、不假设特征中心化、实现简单;代价:对整体偏移不敏感,可能保留较大的公共分量。
10. 一页速记
- 范数 = 长度公理化:非负、齐次、三角不等式。
- L2 欧氏、L1 稀疏、L∞ 最大分量;有限维下等价但几何不同。
- 距离 。
- 梯度裁剪按全局范数缩放,保方向、改步长。
- RMSNorm 除以均方根;LayerNorm 先减均值再除以标准差。
- 物理意义 / 现实对应:L∞ = 最坏关节的立方体安全包络;L2 = 整体 RMS 抖动(能量);L1 = 总行程与磨损。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、定理名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- 柯西(Augustin-Louis Cauchy, 1821):Cauchy’s Cours d’analyse: An Annotated Translation(原著 Cours d’analyse de l’École royale polytechnique,1821)。柯西–施瓦茨不等式最早的有限和形式出现在这部讲义里,本页 §4.1 用它推出三角不等式。英译注本(Springer, 2009)
- 巴拿赫(Stefan Banach, 1922):Sur les opérations dans les ensembles abstraits et leur application aux équations intégrales。把非负、齐次、三角不等式提炼成赋范空间的定义,本页 §2.1 的三条公理正是这个定义的核心。Fundamenta Mathematicae 3
- Zhang 与 Sennrich(2019):Root Mean Square Layer Normalization。提出 RMSNorm,用均方根代替 LayerNorm 的标准差,本页 §5.4 的公式与「省一次统计」的说法出自此文。arXiv:1910.07467
- Trefethen 与 Bau(1997):Numerical Linear Algebra。用范数语言统一讨论误差与稳定性,本页 §4.4 的有限维范数等价是这套语言的前提。SIAM
下一篇 → 1.5 夹角与余弦相似度
随堂测 · 4 题
源文件:01-向量与几何/04-范数与距离.md