11.9 量化:缩放因子与矩阵误差
本节位置:模块 11 · 大模型专题 | 前置:10.1 | 预计:35 分钟
一句话:量化用「整数 + 缩放因子」近似浮点数,把每个参数的存储从 16 位降到 8 位甚至 4 位,代价是舍入误差。
0. 场景引入
一家做车载座舱的团队,要把一个 7B 参数的中文对话模型塞进 8 GB 内存、有效带宽 50 GB/s 的边缘盒子,首字延迟要求 300 ms 以内、吐字速度不低于 5 token/s。
同样的算术在数据中心是另一个量级:70B 模型 fp16 要 GB,一张 80 GB 卡放不下,int4 后 35 GB 才装得进去;端侧只是把数字缩小一号。
先算账:fp16 权重 GB,装不下;int8 是 7 GB,装得下,但只剩 1 GB 留给 2K 上下文的 KV Cache 和激活,对话稍长就 OOM;int4 只要 3.5 GB,能空出 4 GB 给缓存,代价是每个权重只剩 16 个刻度。
更麻烦的是速度。decode 阶段每生成一个 token 都要把全部权重从内存读一遍:14 GB 在 50 GB/s 下至少 s 一个 token,也就是 3.5 token/s;int4 的 3.5 GB 理论上是 14 token/s。位宽同时决定了装不装得下和吐字快不快,省下的每一位都要从数值精度里扣。
端侧没有机房空调,盒子发热降频后带宽可能从 50 GB/s 掉到 30 GB/s,同一份 int4 权重立刻从 14 token/s 变成 8 token/s。所以「量化到几位」不是压缩率问题,而是在内存、带宽、精度之间买一个能长期稳定工作的点。
团队必须做决定:int8 权重保精度、接受短上下文,还是 int4 权重换长上下文和 4 倍速度、接受精度风险?选错的代价很直接——前者在长对话里闪退,后者在回答里出现重复和事实漂移。
读完本节,你能回答的三个问题是:
- 仿射量化的 和 怎么定,为什么少了零点,0 就不再精确?
- 同一个矩阵,per-tensor 和 per-channel 的误差差多少,怎么手算?
- 端侧该选 int8 还是 int4,什么情况下量化会把模型「算坏」?
1. 直觉
把浮点数想成「带小数的尺子」,量化就是「只保留整数刻度」:
- 原来的值:;
- 选一个缩放因子 ;
- 量化:;
- 反量化:。
误差 ,最大不超过 。
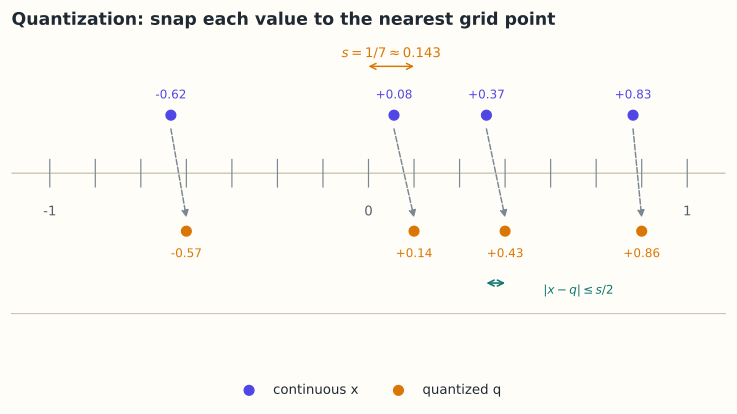
图:蓝色是原始值,橙色是量化后落在网格上的值,虚线表示「就近吸附」。步长 时,任何未截断的值的误差都不超过 。
💡 一句话直觉:量化 = 用「步长 」把连续值映射到整数网格;反量化 = 乘回步长。
类比边界:整数网格的间距固定,所以大值和小值共用同一个绝对误差;这就是为什么 outlier 会挤压其它值的精度。
1.1 它在现实世界里对应什么:一把刻度固定的尺子
工程对应:量化就是给权重发一把量程和刻度都固定的尺子,读数只能落在整数刻度上;反量化是把刻度读数换算回原来的单位。
量级算式:int8 对称量化、权重最大值 时,,一把尺子用 255 个刻度覆盖 。若某个 outlier 把量程撑到 ,,原本 的权重只剩 个刻度,四舍五入后直接变成 0。量程放大 8 倍,小值的有效位数就少了 位。
这个类比在哪里失效:尺子的刻度是均匀的,浮点数的「刻度」却按指数分布。量化把非均匀的浮点网格压成均匀网格,所以误差不是「少读一位小数」那么简单——大值的绝对误差大,小值的相对误差大,同一个 对两类值的伤害完全不同。
2. 定义
2.1 仿射量化
反量化:
- :缩放因子(step size);
- :零点(zero point),让实数 0 能精确表示;
- :整数范围,如 int8 为 。
2.2 对称量化
令 ,范围对称:
(对称量化把 映射到 ;若取 则正侧会越界,需要 clamp)。权重常用对称量化。
2.3 粒度
- Per-tensor:整个矩阵一个 ;
- Per-channel:每行/每列一个 ;
- Per-group:每 个元素一个 (如 )。
粒度越细,越能适应局部数值范围,但元数据开销越大。
2.4 量化误差
对未截断的值:
相对误差约为 ,小值相对误差更大。
3. 为什么这样定义
浮点数的指数位让大值和小值都有合适精度;定点网格没有指数,只有统一步长。因此:
- 动态范围大(有 outlier)时, 被最大值撑大,小值精度被牺牲;
- 这就是为什么 LLM 权重/激活的 outlier 是量化的主要敌人。
量化用「更少的位」换「更少的显存/带宽」,在推理时往往收益巨大,因为 decode 阶段是带宽受限(第 11.7 节)。
3.1 反事实:扔掉零点,0 就不再是 0
仿射量化的 和 由校准范围 与整数范围 一起决定:
这个式子说的是:步长由范围宽度决定,零点把 对齐到 ,从而让 落在某个整数刻度上——前提是 0 确实落在校准范围 里。
取 4-bit 无符号整数 ,某层激活校准出来是 :
反量化 :,。真实的 0 被还原成 0.12。原因是校准范围没包含 0,零点被推到 ,网格上第一个可表示的值变成了 。
注意:对称量化 ,0 永远落在刻度 0 上;这个坑只存在于带零点的非对称量化。
修正只需把 0 纳入范围,取 :,, 精确落在网格上。代价是最大值附近的步长从 变成 ,误差上界从 变成 ——用一点点精度换 0 的精确表示,这笔交易几乎总是划算的。
3.2 反事实:整个矩阵共用一个 ,小的那一行被抹平
取一个 权重矩阵,做 4-bit 对称量化(整数范围 ,):
- 第 1 行:;
- 第 2 行:。
Per-tensor:。第 2 行最大的 只有 个刻度,四舍五入全变 0;整行输出为 0,相对误差 100%。而 比第 2 行所有值都大——误差上界已经超过信号本身。
Per-channel:第 2 行用自己的 :
- ,误差 0;
- ,误差 ;
- ,误差 ;
- ,误差 。
最大误差从 降到 ,约 17 倍。代价是每行多存一个 fp16 的 :在这个 的玩具矩阵上,8 个权重只摊到 4 字节元数据,实际码率从 4 bit 涨到 8 bit;换成真实的 矩阵,每行一个缩放因子只摊到 bit/权重,几乎可以忽略。粒度是否划算,取决于通道有多宽。
4. 性质与推导
4.1 位宽与压缩比
| 格式 | 位数 | 相对 fp16 压缩 |
|---|---|---|
| fp16 | 16 | 1× |
| int8 | 8 | 2× |
| int4 | 4 | 4× |
| int4 + 双重量化 | ~4.1 | 约 3.9× |
实际还要加上缩放因子/零点的元数据,压缩比略低于理论值。
4.2 误差传播
对线性层 ,若 ,则
误差被输入 放大;若 与 同阶,输出相对误差可能很大。逐层累积、经过非线性后可能放大或抵消。
4.3 为什么 per-channel 有效
若某一行权重的动态范围远大于其它行,per-tensor 的 会被这一行撑大,其它行精度下降。per-channel 给每行独立 ,缓解这个问题。
4.4 量化感知训练 vs 训练后量化
- PTQ:训练后直接量化,简单,但可能有精度损失;
- QAT:训练时用假量化节点模拟量化误差(量化感知训练),效果更好,成本更高。
5. 例子
5.1 手算:对称 int8
设权重范围 ,取 。
:
反量化:,误差 。
:,反量化 ,相对误差 100%。小值被完全抹掉。
5.2 手算:per-group 的差异
两组权重:第一组范围 ,第二组范围 。
- per-tensor :第二组所有值都量化到 0 附近,精度全失;
- per-group:第二组 ,能保留细节。
5.3 场景:为什么 4-bit 还能用
LLM 权重近似低秩、且对噪声有一定鲁棒性;per-group 量化 + 校准可以保留大部分信息。但 4-bit 通常需要更精细的算法,不能简单 round:如 GPTQ 用二阶信息逐列补偿误差,LLM.int8() 则把 outlier 通道单独留在 fp16。AWQ 等同类方法细节不同,这里不展开。
5.4 场景闭环:8 GB 盒子上跑 7B
输入:7B 参数模型,32 层,hidden ,32 个 head、head_dim 128;上下文 ,batch 1;权重 int4、group size 128;KV Cache 用 int8。
计算:
- 权重: 字节 GB。
- 量化元数据:每组 128 个权重配一个 fp16 的 和一个 4-bit 的 ,约 字节 GB。
- KV Cache:每 token 每层 个数,fp16 是 16 KB,32 层共 512 KB/token;int8 减半为 256 KB/token, 个 token 约 GB。
- 合计 GB,8 GB 里还剩约 3.8 GB 给框架、激活和内存碎片。
带宽与算力:
- decode 每 token 要把权重和 KV 读一遍: s,理论上限约 12 token/s。
- FLOPs:每 token 约 ;按 NPU 有效算力 10 TFLOP/s 只要 ms。慢了约 60 倍的是搬运,不是计算。
输出决策:选 int4 权重 + int8 KV,显存预算 4.2 GB,端侧保留 2K 上下文,目标 10 token/s;int8 权重方案( GB)加上激活会挤爆 8 GB,直接出局。
成本与失败条件:
- 每 token 83 ms,生成 500 个 token 约 42 秒;用户能感知,但还能接受。
- 校准集与线上分布不符(校准用新闻、线上是口语)时,outlier 会把 per-tensor 的 撑大,回答开始复读;兜底是退回 per-group,并把 outlier 通道留在 fp16。
- 忘记把 0 纳入激活校准范围时,§3.1 的零点偏移会把本应为 0 的激活变成 0.12,表现为答非所问;兜底是校准后检查 与 是否自洽。
- 显存估算漏掉 KV 或元数据时,长对话直接 OOM 闪退;兜底是给 KV 设上限,超长时截断上下文。
6. 常见误区
-
误区:量化就是把小数四舍五入到更少位数。 纠正:需要缩放因子、零点、范围截断;粒度和校准策略决定效果。
-
误区:int4 一定比 int8 小 2 倍且效果一样。 纠正:位宽减半,但误差更大、需要更复杂的算法;效果取决于模型/任务/粒度。
-
误区:量化误差对所有值一视同仁。 纠正:绝对误差有上界 ,但相对误差对小值更大。
-
误区:量化只省显存,不影响速度。 纠正:还能减少带宽、提升吞吐;但反量化有计算开销,低比特矩阵乘需要硬件支持。
7. 概念网络
- 前置:10.1 浮点数 —— 精度与舍入。
- 前置:11.2 线性层 —— 被量化的矩阵。
- 后续:11.7 KV Cache —— 缓存量化。
- 关联:7.3 低秩近似 —— 低秩与低精度是两种压缩。
8. 通往大模型:量化对象与取舍
| 对象 | 常见精度 | 难点 |
|---|---|---|
| 权重 | int8/int4 | outlier、分组 |
| 激活 | int8/fp8 | 动态范围随 token 变化 |
| KV Cache | int8/fp8 | 长序列误差累积 |
| 梯度 | fp16/bf16 | 训练稳定性 |
可检验结论:int8 对称量化的最大绝对误差为 。若 ,误差上界约 。
注意:不同量化算法(GPTQ、AWQ、GGUF 等)的具体细节不同;这里只讲共同的线性代数结构:用缩放因子把浮点矩阵映射到整数矩阵。
8.1 算错时用户看到什么
- 的粒度用错(对多尺度矩阵用 per-tensor,或 group 设得过大):小权重被抹平,输出退化成高频套话、复读同一句,长回答尤其明显。
- 零点丢了:本应为 0 的激活(padding、mask 位置)被还原成非零常数,整层激活带固定偏移,表现为答非所问、指令跟随变差。
- KV Cache 量化误差累积:短对话正常,超过 1–2K token 后开始指代错乱、重复前文,像是「忘了刚才说什么」。
- 显存估算漏项:不是精度问题,是 App 直接闪退;端侧用户看到的是白屏或「模型加载失败」。
这些都是定性症状,阈值因模型和校准集而异;能不能接受,只能在你自己的校准集和任务上测,不能照搬别人的结论。
9. 练习
- 概念:为什么 outlier 会严重损害 per-tensor 量化?
- 计算:权重范围 ,int8 对称量化,求 ; 的量化值与反量化误差。
- 计算:一个 的权重矩阵,fp16 占多少 MiB?int4(忽略元数据)占多少?
- 场景:为什么 decode 阶段量化收益比 prefill 更明显?
- 开放:如果只量化权重、不量化激活,误差主要来自哪里?为什么这种方案更常见?
参考答案
- 由最大值决定,一个很大的 outlier 会增大步长,使其余小值落在同一个粗网格上,相对误差剧增。
- ;;,误差 。
- fp16: 字节 MiB;int4: 字节 MiB。
- Decode 是带宽受限,权重和 KV Cache 的读取量是瓶颈;量化直接减少字节数,提升吞吐。
- 主要来自权重舍入与 outlier;激活动态范围大、量化更难,且权重静态、可离线校准,所以 weight-only 更常见。
10. 一页速记
- 量化:;反量化 。
- 误差上界 ;小值相对误差大。
- 粒度:per-tensor / per-channel / per-group。
- outlier 是主要敌人;per-group 缓解。
- 量化省显存与带宽,代价是精度。
- 物理意义 / 现实对应:量化是一把刻度均匀的尺子——位宽是刻度数, 是刻度间距,outlier 把尺子拉长,小值就只剩几个刻度。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、定理名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- Jacob 等(2018):Quantization and Training of Neural Networks for Efficient Integer-Arithmetic-Only Inference。本页的仿射量化 、per-channel 缩放因子,以及用假量化节点模拟舍入误差的量化感知训练(QAT),都出自这篇 CVPR 论文。CVPR 2018(DOI)
- Dettmers 等(2022):LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale。用混合精度分解把少数 outlier 特征维度单独留在 fp16、其余走 int8,是本页反复强调「outlier 是量化主要敌人」的实测依据。arXiv:2208.07339
- Frantar 等(2022):GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers。借逐层 Hessian 的二阶信息按列补偿权重量化误差,说明 4-bit 不能只靠 round,对应本页 §5.3 的结论。arXiv:2210.17323
- Dettmers 等(2023):QLoRA: Efficient Finetuning of Quantized LLMs。分块(blocksize)量化与其上再做一次量化的「双重量化」,正是本页 §4.1 表格里那行 int4 + 双重量化的元数据开销来源。arXiv:2305.14314
下一篇 → 11.10 MoE 路由与专家矩阵
随堂测 · 3 题
源文件:11-大模型专题/09-量化.md