1.3 点积:相似度的来源
本节位置:模块 1 · 向量与几何 | 前置:1.2 | 预计:35 分钟
一句话:点积把两个向量压成一个数,这个数同时告诉你「方向有多一致」和「在对方身上投影有多长」。
0. 场景引入
晚上 8 点,电商 App 的首页要 refresh。推荐系统必须在 8 毫秒内,从 12 万个候选商品里挑出 200 个放进首屏。它用的是业界常见的「双塔召回」:
- 用户塔把「最近点过什么、买过什么」压成一个 维向量 ;
- 商品塔把每个商品的标题、类目、价格也压成 维向量 ;
- 打分只做一件事:,取分数最高的 200 个。
粗算一下: 个候选 × 维 × 每维一次乘加(2 FLOP),约 次浮点运算。这个量级单核几毫秒能跑完,所以 8 ms 的预算里,真正紧张的不是算力,而是把 12 万个向量从内存搬进 CPU 的带宽。
但工程师很快发现两个怪现象:
- 某些「大牌旗舰店」的商品几乎霸榜——不是因为它更相关,而是因为它的向量更长;
- 把用户向量整体乘 2,排序居然全变了。
现在要定一件事:直接按点积排序,还是先做归一化再排?选错,首页会被「长向量」的大牌霸榜,点击率掉几个百分点;归一化又要多一次 12 万次除法,8 ms 预算里得把这点时间挤出来。
问题:为什么「相关性」恰好能用一个点积表示?点积到底在量什么?它和欧氏距离、余弦相似度差在哪?什么时候它会骗你?
读完本节,你应该能回答三件事:
- 点积的几何含义,以及它为什么能当相似度;
- 为什么工程上偏爱点积,而不是欧氏距离或逐元素相乘;
- 点积在什么情况下必须换成余弦或做归一化。
1. 直觉
1.1 投影视角:影子有多长
正午的太阳下,一根杆子在地面上的影子,长度等于杆长乘上「太阳角度」的余弦。把 投影到 的方向上,投影长度就是 。点积等于:
也就是说,点积 = 的长度 × 在 方向上的投影长度。
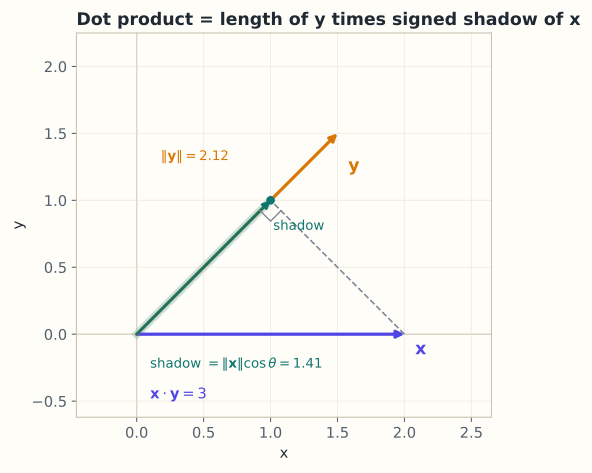
图: 的长度是 2.12, 在 方向上的影子长 1.41;两者相乘正好是 。影子落在反方向时长度为负,点积也为负。
1.2 物理视角:力做了多少功
这是点积在物理里最原始的样子。你推一个箱子,力 与位移 夹 角,真正让箱子前进的只有沿位移方向的分力 ,所以
如果力垂直于位移(比如你向上提箱子、箱子水平移动),点积为 0——你累得满头汗,但对箱子前进没做功。点积为负,则表示这个力在「拖后腿」。
同样的式子出现在功率 、三相电路的瞬时功率 、以及信号处理里的相关运算中。点积就是「一个量在另一个量的方向上,实际起了多少作用」。
1.3 投票视角:每个维度是一个评委
把 和 的每个分量看成一对评委:第 维上,两人都打正分就加正分,一正一负就扣分。点积是这 个评委打分的总和。这个视角在推荐系统里特别自然:用户向量第 3 维是「偏好快充」,商品向量第 3 维是「支持快充」,两者都高,就在这一维上加分。
💡 一句话直觉:点积是「你在我的方向上贡献了多少」的度量;它把方向关系压缩成一个有符号的数。
1.4 量级直觉
在 维空间里随机取两个单位向量,它们的点积近似服从均值 0、标准差 的分布。 时标准差约 ——随机向量的点积几乎总是接近 0。而训练会把正样本对的点积推高到什么程度,取决于任务与损失函数。所以「点积 」在 128 维里可能已经是很强的信号,不要拿二维平面里「夹角 72°」的直觉去套。
类比边界:影子类比假设光平行、地面水平;功的类比要求力与位移在同一参考系。点积本身不区分「长度」和「方向」,这是它后面所有麻烦的根源。
2. 定义
2.1 代数定义
对 :
逐项读法:对应分量相乘,再全部相加。结果是一个标量。
2.2 几何定义
其中 是两个向量之间的夹角()。
两个定义等价,这一点在 §4.1 证明。
2.3 内积的抽象定义
在实向量空间 上,内积是一个二元函数 ,满足:
- 对称:;
- 线性(第一个位置):;
- 正定:,且等号只在 时成立。
这个抽象化可以追溯到 格拉斯曼 把内积当作独立代数对象的研究。标准点积是内积的一个特例(取标准基)。加权内积 ( 正定)也是内积,会诱导不同的几何(第 6.5 节)。
3. 为什么这样定义
为什么不是逐元素相乘?因为逐元素相乘 得到的是向量,没有把「整体方向关系」压缩成一个数。
为什么不是「对应分量相乘后取最大」?那会丢失其它维度的信息。
点积的定义有三个不可替代的性质:
- 双线性:对两个输入都线性,方便求导与分解;
- 坐标无关:换一组标准正交基,点积的值不变(第 2.7 节);
- 诱导范数:,把长度和角度统一在同一套代数里。
在几何上,点积是投影的代数化;在物理上,功 就是力在位移方向上的分量乘以位移。
3.1 反事实:换一种「相似度」会坏在哪
假设我们不用点积,改用下面四种常见写法,逐个算一个具体例子。取
与 方向几乎一致; 与 方向完全一致,但长了 10 倍; 很长,方向却偏了。
方案 A:逐元素相乘后取最大。 ,最大值 12;,最大值 16。看起来还行?换一组: 与 ,逐元素积为 ,最大值是 1,和 与自己比一模一样——方向完全相反却得了满分。这个方案还把 维压成了「某一维的最大值」,其余维度全被丢掉。
方案 B:欧氏距离。 ,而 。按距离排序, 更「近」。但注意展开式:
当所有向量长度都固定(比如都做了 L2 归一化),距离排序与点积排序完全等价——此时两者没有优劣,只差点积能直接写成一次矩阵乘法 ,而距离要先算范数再逐对相减。
方案 C:余弦相似度。 ,,。余弦把长度彻底除掉: 与 同向,得满分 1;而点积会给 打 300 分,远高于 的 24 分——点积认为「长而偏」的 比「短而准」的 更相关。这正是开头「大牌旗舰店霸榜」的数学原因。
但长度有时正是你要的信息:一个用户最近浏览了 300 个商品,另一个只浏览了 3 个,前者的向量天然更长,代表「兴趣更明确、更活跃」。很多双塔实现因此保留模长,或者把 作为一个特征单独喂给后面的排序模型。
方案 D:加权点积 。 其中 对称正定。它等价于先把空间「拉伸」再算点积,能学到「第 3 维比第 7 维更重要」。代价是要多学 个参数; 时约 8 千个,尚可接受, 时就变成 800 万,通常改用低秩的 。
四种写法的对比说明:点积是同时满足「双线性、可批量矩阵乘、保留长度信息」的最简形式。双线性这一点尤其关键——它让 12 万次打分变成一次 ,可以整体丢给 GPU 或向量检索库。
4. 性质与推导
4.1 两个定义为什么等价
由余弦定理,在由 构成的三角形中:
左边展开(用分量):
两式对比,得 。
4.2 基本性质
| 性质 | 式子 |
|---|---|
| 对称 | |
| 双线性 | |
| 正定 | ,等号仅当 |
| 与范数 | |
| 柯西–施瓦茨 |
柯西–施瓦茨不等式保证 ,因此夹角总有定义。
4.3 点积与投影
在 方向上的投影向量是
标量系数 就是「投影长度 ÷ 」。第 1.6 节详细推导。
5. 例子
5.1 手算:点积与夹角
,:
所以 。
再算 与 :点积 0,夹角 90°,正交。
与 :点积 ,夹角 180°,反向。
5.2 场景:四个维度上的偏好匹配
把商品 embedding 的四个维度先「命名」成可解释的方向(真实模型里维度是学出来的、通常不可读,这里只是为了看清计算):
| 维度 | 含义 |
|---|---|
| 1 | 快充 |
| 2 | 拍照 |
| 3 | 低价 |
| 4 | 游戏性能 |
用户 ,商品 A ,商品 B :
A 的匹配分更高。但等一下——B 的向量更长( 对 ),它靠「游戏性能」这一维把总分撑了起来,而用户其实并不在意游戏。
余弦把差距拉得更开:A 在「方向上」确实更像这个用户。如果业务目标是「猜他会不会买」,用点积;如果目标是「找同款」,用余弦。同一个数据,两种打分,两种业务含义。
5.3 场景闭环:12 万候选、8 毫秒
回到开头的召回请求,把整条链路算一遍。
输入: 个商品向量,每个 维 fp32,共
计算:矩阵-向量乘 , FLOP。在单核 GFLOP/s 下约 ms;而把这 61 MB 从内存读一遍,在 GB/s 带宽下也约 ms。两者同量级——这是一次既吃算力又吃带宽的操作,正好卡在 Roofline 的拐点附近(第 10.3 节)。
输出:分数排序,取 top-200 交给后面的精排模型。线上通常看 recall@200:这 200 个里覆盖了多少用户最终会点的商品。
成本:单请求 61 MB 访存;QPS 到 1000 时就是 GB/s 的持续带宽,一台机器扛不住,于是工程上会用 IVF/PQ 把向量压到原来的 ~,或者把候选先粗筛到 1 万。
失败条件:
- 模长霸榜:促销商品的 embedding 模长偏大,点积被长度主导,首屏全是爆款。兜底:打分前做 L2 归一化,或对 做惩罚。
- 高维近正交:128 维里随机向量的点积标准差只有 ,真实相关信号如果只有 ,会被噪声淹没。兜底:降维、或用更长的向量、更多训练数据。
- embedding 过期:商品下架、用户兴趣漂移,缓存里的向量不再代表现状。兜底:按时间衰减重算,并监控线上分布漂移。
5.4 场景:attention 打分
设 ,两个 key 、:
两者分数相同。若 ,则分数为 2,明显更高——说明 与 query 的方向最一致。
6. 常见误区
-
误区:点积就是逐元素相乘。 纠正:逐元素相乘得到向量(Hadamard 积 );点积还要把所有分量加起来,得到标量。
-
误区:点积大就代表「更相似」,与长度无关。 纠正:点积受长度影响。 很大时,即使夹角不小,点积也可能大。比较方向要用余弦相似度。
-
误区:点积为 0 说明两个向量「没关系」。 纠正:只说明线性意义下正交(夹角 90°),不说明统计独立或语义无关。
-
误区:几何定义里的夹角可以随便取。 纠正:夹角由两个向量唯一确定;公式中的 是它们尾对尾放置时的夹角。
7. 概念网络
- 前置:1.2 线性组合 —— 向量运算。
- 后续:1.4 范数 —— 点积诱导长度。
- 后续:1.5 余弦相似度 —— 去掉长度影响。
- 后续:1.6 正交与投影 —— 点积的几何应用。
- 后续:6.5 二次型 —— 是「加权点积」。
- 关联:11.3 Attention —— 点积作为相关性打分。
8. 通往大模型:为什么 attention 要除以
假设 query 和 key 的每个分量独立、均值 0、方差 1,则点积
的方差是 (每项方差为 1,独立相加)。标准差是 。
时,分数的典型波动约 。如果不缩放,softmax 的输入会非常大,导致:
- 输出接近 one-hot,梯度接近 0(softmax 饱和);
- 训练不稳定,对初始化敏感。
除以 后,方差回到 1,softmax 工作在梯度良好的区间。这不是玄学,是方差计算。
形状:,,;每一行是「一个 query 对所有 key 的分数」。
可检验结论:把 从 32 增到 512,未缩放点积的标准差会从约 5.7 增到约 22.6,softmax 熵显著下降。跑 lab11 可观察。
如果这一步算错,用户会看到什么:注意力分数被少数几个 token 垄断,模型对长句「记不住前文」,表现为复述、跑题、答非所问;训练侧则表现为 loss 早期尖峰、对学习率极其敏感。这些现象不一定是点积的 bug,但点积的尺度是它们最常见的物理来源。
9. 练习
- 概念:用投影语言解释「点积为负」意味着什么。
- 计算:,,求点积、两者范数、夹角余弦。
- 计算:求 在 和 方向上的投影长度。
- 场景:两个 4096 维向量的点积约为 12,能否判断它们「相似」?还需要什么信息?
- 开放:如果 attention 不除以 ,但把 query/key 初始化方差改成 ,效果是否等价?为什么?
参考答案
- 投影为负,说明 在 方向上的分量指向相反方向,夹角大于 90°。
- 点积 ;,;。
- 对 :投影长度 3;对 :。
- 不能。点积大小依赖长度;需要范数或归一化后比较余弦。
- 数学上等价(缩放被吸收进权重),但初始化方差会随 变化,影响优化动态;工程上仍显式缩放更稳定、更易调。
10. 一页速记
- 。
- 物理意义:力在位移方向做的功;现实里就是「一个量在另一个量方向上真正起了多少作用」。
- 点积 = 一个向量在另一个方向上的投影 × 对方长度;正为同向,零为垂直,负为反向。
- 点积受长度影响;比方向要用余弦,要保留「活跃度」就用原始点积。
- 量级: 维随机单位向量的点积标准差约 ,128 维时只有 。
- attention 除以 是为了把点积方差拉回 1。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、定理名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- 柯西(Augustin-Louis Cauchy, 1821):Cauchy’s Cours d’analyse: An Annotated Translation(原著 Cours d’analyse de l’École royale polytechnique,1821)。柯西–施瓦茨不等式最早的有限和形式出现在这部讲义里,它是点积与范数之间那道不等式的源头。英译注本(Springer, 2009)
- 格拉斯曼(Hermann Grassmann, 1844):Extension Theory(德文原著 Die lineare Ausdehnungslehre,1844)。把两个向量的乘积拆成「内积 + 外积」,内积由此成为独立的代数对象;本页的 是它在 中的坐标写法。AMS 英译本(2000)
- Vaswani 等(2017):Attention Is All You Need。缩放点积注意力,也就是本页开头那行 的出处;除以 的理由也在其中。arXiv:1706.03762
下一篇 → 1.4 范数与距离
随堂测 · 3 题
源文件:01-向量与几何/03-点积.md