10.5 稀疏矩阵与结构化计算
本节位置:模块 10 · 数值线性代数 | 前置:10.3 BLAS 与 GEMM | 预计:30 分钟
一句话:当矩阵里绝大多数元素是 0 时,「存下来再乘」是巨大的浪费;稀疏矩阵的全部技巧,就是只存非零元、只算非零元。
0. 场景引入
一个网页图:20 亿个节点、平均出度 20,共 条有向边。PageRank 每轮迭代就是一次 SpMV。CSR 存下来:列索引 int32 占 GB,行指针 int64 占 GB——光结构就 GB。
如果再存一份 fp32 的权重(每条边 ),要多 GB。每轮多读 GB:一轮 ms 变 ms, 轮就是 s 变 s。
GB 只是「结构」,还没算每轮要读写的向量: 与 各 B GB,相对 GB 可以忽略。这正是 SpMV 的特点:开销全在边上,不在点上。
决定:把均匀权重折进一个长度 的 invdeg 向量(省 GB),还是保留 values 数组(支持加权 PageRank)?
顺带一个迭代数的量级:误差按 衰减, 时每轮只降 ,要 位精度得跑 轮,要 得跑 轮。
代价:省下的是内存与带宽,换掉的是「个性化、加权」的表达能力;而直接法解 更不可能——消元会把图填成稠密, 个元素。
问题:怎么存?怎么乘?为什么「有很多 0」不等于「算得快」?
读完本节,你应该能回答三件事:
- COO 与 CSR 的差别不只是「省不省内存」,那么差在哪?
- 为什么「很多 0」不等于「算得快」,SpMV 的算术强度是多少?
- 消元顺序如何决定 fill-in,为什么它能把稀疏问题变成稠密问题?
1. 直觉
1.1 零是「不存在」
稠密矩阵把 0 也当成一个数:占内存、参与乘加、消耗带宽。稀疏矩阵换一个视角:0 表示「这条边不存在」。
把矩阵看成图:行和列是节点,非零元 是一条从 到 的带权边。 个非零元就是 条边,很多图算法只关心边,不关心「哪些位置没有边」。
💡 一句话直觉:稀疏矩阵 = 只记录存在的边;稀疏计算 = 只沿边传播。
类比边界:这个图视角只对「结构稀疏」有用。若零是算出来的(如 ReLU 后的激活),位置不固定,仍然要付出索引开销。
1.2 结构稀疏 vs 非结构稀疏
- 非结构稀疏(unstructured sparsity):零的位置任意,逐元素剪枝得到。压缩率高,但索引不规则。
- 结构稀疏(structured sparsity):零按块、按行、按固定模式出现。例如每 4 个元素保留 2 个(2:4 稀疏)、整行整列剪掉、 的块剪掉。压缩率低一些,但硬件能高效跳过。
GPU 喜欢规则:同样 50% 的零,按 模式排列能被张量核直接加速,随机排列则可能因为索引与负载不均而变慢。
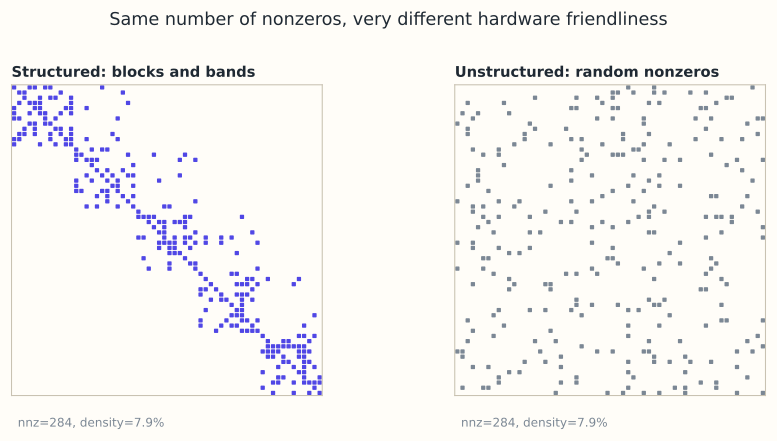
图:两个 矩阵的非零元位置,非零数相同(284,密度 7.9%)。左边按块/带排列,硬件能跳过整块;右边随机分布,索引不规则。
1.3 它在现实世界里对应什么
网页图是最标准的对应物:节点是页面,非零元是链接,值是链接权重。PageRank 的一轮迭代就是一次 SpMV:
其中 是列随机的转移矩阵,。 的每一列只有一个非零块(某个页面的所有出链),所以 SpMV 的代价是「沿着每条边传一次值」。
量级:、,只存结构的 SpMV 算术强度是
对比第 10.3 节 GEMM 的 FLOP/byte——差了三个数量级。稀疏计算的宿命是访存受限:每读 4 字节的列索引,只做 2 次浮点运算。
1.4 这个类比在哪里失效
图视角假设「零是结构性的、永远不变」。真实系统里零会变:剪枝后为零的权重,训练会把它长回来;ReLU 产生的激活零,每批数据位置都不同。结构性稀疏能省存储,动态稀疏只能省计算,且要付索引开销。
第二个失效点:GPU 的并行单位是 warp(32 个线程)。图的度分布是重尾的——少数节点有上百万条边,多数只有几条。同一个 warp 处理 32 行,行长差几个数量级,快的那 31 个只能等最慢的那个。平均每行 20 个非零元,不代表每次 SpMV 都按 20 计费。
2. 定义
2.1 稀疏度
设 有 个非零元。稀疏度(sparsity) 常定义为
有的文献把 叫密度(density)。读的时候看清定义:本文用「零的比例」。
2.2 COO:三元组列表
COO(coordinate format) 用三个等长数组描述矩阵:
row  = [0, 0, 1, 3, 3]
col  = [0, 3, 1, 0, 2]
data = [1, 2, 3, 4, 5]
第 个非零元在 (row[k], col[k]),值为 data[k]。优点是构造简单、可乱序、易合并重复项;缺点是每个元素都要存行列索引,且随机访问慢。
2.3 CSR:按行压缩
CSR(compressed sparse row) 用三个数组:
values:长度 ,按行优先排列的非零值;col_indices:长度 ,对应的列号;indptr:长度 ,第 行的数据在values[indptr[i]:indptr[i+1]]。
对上面的矩阵():
values  = [1, 2, 3, 4, 5]
col_idx = [0, 3, 1, 0, 2]
indptr  = [0, 2, 3, 3, 5]
第 0 行是 values[0:2],列 [0,3],值 [1,2];第 2 行是 values[3:3],空行。CSR 适合「按行遍历」,SpMV 与行切片都快。CSC(compressed sparse column) 把行与列对调,适合按列访问。
2.4 稀疏矩阵乘法
稀疏 的代价不是 ,而是「沿着 的每条非零边,把 的对应行按系数累加」:
读作: 第 行的每个非零元 ,都要把 的第 行整体加到 的第 行上。若 每行平均 个非零元,则代价约 ,而 ,所以约等于 ——当 时远小于稠密的 。
3. 为什么这样定义
为什么不直接存稠密矩阵、把 0 跳过? 跳过 0 需要先判断它是不是 0,这个判断本身就要读内存、花分支;在 GPU 上还会造成同一 warp 内线程走不同路径(warp divergence)。稀疏格式把这个判断提前到「存储结构」里,运行时不需要再判断。
为什么需要 COO 和 CSR 两种? 构造阶段用 COO 方便(可以直接 append、允许重复),计算阶段转成 CSR(按行连续、缓存友好)。这是「写时用 COO、算时用 CSR」的常见流水线。
为什么稀疏矩阵乘法可能不省时间? 若 的行很稠密( 接近 ), 接近 ,与稠密乘法同阶;而且索引开销、负载不均、无法用张量核,实际可能更慢。
为什么剪枝要看结构? 硬件的加速单位是「块/向量指令」,不是单个元素。非结构稀疏在 GPU 上很难获得与稀疏率成正比的加速;2:4 这类结构稀疏才有专用指令支持。
3.1 反事实:换一个消元顺序,稀疏问题会变成稠密问题
取一个「星形」图:1 个中心节点连 999 个叶子,共 1000 个节点、999 条边。两种消元顺序:
- 先消叶子:每个叶子的度是 1,消掉它只是删一条边,中心节点的度减 1,不产生任何新非零元。整个过程填充为 0。
- 先消中心:中心的度是 999。消掉它时,它的邻居两两相连,新增
条边——而 1000 个节点的对称矩阵一共才 个上三角位置。填充几乎把矩阵填满。
同一个矩阵、同一个算法(高斯消元),只换顺序,填充从 0 变成 。这就是稀疏直接法里「消元顺序」比「消元本身」更重要的原因,也是嵌套剖分、最小度排序值得单独研究的原因。
第二个反事实:用 COO 做 SpMV。COO 每个非零元要存行号、列号、值三个 4 字节(int32 + int32 + fp32),CSR 只存列号与值。、 时,COO 是 B GB,CSR 是 B GB。同样一次 SpMV,COO 多读 144 GB,慢 1.4 倍;若权重还能折进 invdeg,CSR 再省 160 GB(§5.4)。
第三个反事实:用 CSC 去算 。CSR 按行扫,列索引连续;CSC 按列扫,输出 的写入变成随机的——每写一个 都可能命中不同的 cache line,并行时还会写冲突。格式要匹配遍历方向,不能随便挑一个稀疏格式。
4. 性质与推导
4.1 CSR 的行切片的代价
访问第 行是 定位(读 indptr[i]、indptr[i+1]),遍历是 。这就是 CSR 适合 SpMV 的原因:每个输出 只扫一遍第 行的非零元。
SpMV()的总代价:
它是访存受限的:每读一个非零元只做 2 次浮点运算,算术强度约 。
4.2 存储量对比
以 、、int32 索引、fp32 数值为例:
| 格式 | 存储 | 说明 |
|---|---|---|
| 稠密 | B TB | 根本存不下 |
| COO | MB | 值、行、列各一份 |
| CSR | MB | 值、列索引、行指针 |
CSR 比 COO 省掉一整个行索引数组,代价是构造时要做一次排序/计数。
4.3 稀疏乘稀疏的填充
两个稀疏矩阵相乘,结果可能比输入稠密得多。极端例子: 是下三角(含对角线), 是上三角,则 一般是稠密矩阵。这叫填充(fill-in),也是稀疏直接法(如稀疏 LU/Cholesky)最头疼的问题——消元会不断产生新的非零元。
4.4 结构稀疏:2:4
2:4 稀疏指每 4 个连续元素中恰好保留 2 个非零元。它把稀疏率固定为 50%,硬件可以用固定模式的稀疏张量核,理论吞吐是稠密的两倍;代价是需要额外的元数据记录「哪两个位置被保留」,且精度恢复通常要靠再训练/蒸馏。
5. 例子
5.1 手算:CSR 构造与 SpMV
按行扫描,得到 values=[1,2,3,4,5]、col_idx=[0,3,1,0,2]、indptr=[0,2,3,3,5]。
逐行计算:
- 第 0 行:;
- 第 1 行:;
- 第 2 行:空行,结果 ;
- 第 3 行:。
所以 。用稠密乘法核对:第一行 ✓,最后一行 ✓。这个 矩阵只有 5 个非零元,存储反而不如稠密划算;稀疏的收益要到 很大、每行非零元远小于 时才显现。
5.2 手算:稀疏乘稀疏
按「 的每个非零元把 的对应行加到 」:
- 第 0 行有 :;
- 第 1 行有 :;
- 第 2 行全零:结果 。
,结果 。这个例子里没有填充;但若 的下三角与 的上三角「错位」相乘,非零元会迅速增多,这就是 §4.3 的填充。
5.3 场景:MoE 的「条件计算」
一个专家(expert)是一个两层 FFN:、。 时,单个专家每 token 的 FLOPs 是
若有 个专家、每个 token 只激活 top-2,则每 token 计算 FLOPs,而参数要存 份。计算量按「激活的专家数」增长,参数量按「专家总数」增长——这正是稀疏激活的核心 trade-off。
5.4 场景闭环:20 亿节点的 PageRank
输入:、、、目标相对残差 。
计算:
- 存储:CSR 的
col_idx(int32) GB +indptr(int64) GB GB;若再存values(fp32)则 GB。 - 迭代数:误差按 衰减,,取 轮。
- 每轮 SpMV:结构-only 版读 GB,在 TB/s 聚合带宽下约 ms。
输出: 轮约 s(结构-only)或 s(带 values)。dangling 节点的质量再分配与 L1 归一化各是 的向量扫描( B GB,约 ms),可以忽略。
决策:均匀 PageRank 用结构-only(省 GB、快一倍);一旦要个性化(每个用户一组 )或加权(按点击率给边权),values 就必须存在——省下来的内存是用表达能力换的。
失败条件与兜底:
- 悬挂节点(出度为 0): 的列不是随机的,质量会漏掉。兜底是把这些节点的质量均分全网,等价于给 加一个秩一修正。
- 收敛判据用错: 是最坏衰减率,实际谱隙可能更大,也可能因为双分结构(两个大站互相链接)更小。兜底是同时监控残差与相邻两轮的 L1 变化量。
- 单机放不下: GB 超过单卡,要按行分块(每台机器存一段
indptr区间),每轮做一次 all-to-all 交换边界向量——瓶颈从带宽变成网络。
6. 常见误区
- 误区:矩阵里有很多 0,用稀疏格式一定更快。 纠正:小矩阵或高密度矩阵,稠密 BLAS 更快;稀疏格式有索引开销、负载不均、无法用张量核。通常密度低于几个百分点才考虑稀疏。
- 误区:稀疏矩阵的乘法代价与 成正比。 纠正:SpMV 是 ,但稀疏乘稀疏是 , 是每行平均非零元数;结果还可能填充。
- 误区:COO 和 CSR 只是存储方式不同,性能一样。 纠正:COO 适合构造与合并,CSR 适合按行遍历与 SpMV;选错格式会让缓存命中率大幅下降。
- 误区:非结构剪枝 90% 就能让 GPU 快 10 倍。 纠正:GPU 的加速依赖规则模式。非结构稀疏的索引与负载不规则,实际加速往往远低于稀疏率;结构化稀疏(2:4、块稀疏)才有硬件支持。
7. 概念网络
- 前置:10.3 BLAS 与 GEMM —— 稠密 GEMM 的高复用假设在稀疏时失效。
- 前置:2.6 秩 —— 稀疏与低秩是两种不同的结构。
- 后续:无(本模块收束)。
- 关联:11.10 MoE 路由与专家矩阵 —— 条件计算是稀疏激活的工程实现。
- 关联:11.7 KV Cache —— 长上下文的稀疏注意力减少 项。
- 关联:11.9 量化 —— 剪枝与量化常一起用于压缩。
8. 通往大模型:稀疏激活与结构化剪枝
出现位置一:MoE 路由。 输入 ,门控 算出 ,每个 token 取 top- 个专家。被选中的 token 按专家分组,做 grouped GEMM:每个专家处理「分到自己的 token 子集」。、、 时,每 token 的 FFN FLOPs 是稠密的 倍,但参数量是 倍;显存必须容下所有专家,负载还可能不均(某些专家被更多 token 选中),需要 capacity factor 与丢弃/溢出机制。
出现位置二:2:4 结构化稀疏。 把权重 剪成每 4 个元素保留 2 个,配合稀疏张量核,矩阵乘的理论吞吐翻倍。代价是精度下降,通常要再训练恢复;而且「哪两个位置保留」的元数据也要存。与非结构剪枝相比,它牺牲了压缩率,换来了可预测的硬件加速。
出现位置三:稀疏注意力。 标准注意力矩阵是 , 时有 个元素。滑动窗口注意力只保留对角线附近 条带,每行 个非零元,总计算从 降到 ; 时约省 倍。块稀疏注意力(如按 块选择)更适合 GPU,因为块内仍是稠密 GEMM,块间才跳过。
出现位置四:Embedding 与稀疏梯度。 词表 、 的 embedding 表有 个参数;一个 batch 只碰几千行,梯度是稀疏的。稀疏 Adam 只更新被触碰的行,省掉对整表的读写;但稀疏优化器的状态管理与稠密实现不同,工程上要专门处理。
可检验结论:MoE 的「每 token 计算量」由 top- 决定,而「显存占用」由 决定; 时计算是稠密的 2 倍、参数是 8 倍。稀疏注意力的计算量约与窗口 成正比,而不是 。这两条都能用形状直接算出来,不依赖具体论文。
如果这一步算错,用户会看到什么。 搜索与推荐侧:排序结果「莫名其妙地抖动」,同一个 query 两次请求的 top-10 不一样(稀疏遍历顺序不确定 + 浮点累加顺序不同);或者冷门页面分数恒为零(悬挂节点没处理,质量没有回流)。训练侧:MoE 的某些专家长期空转(top- 在负载不均时把 token 集中到少数专家),表现为「参数很多但大部分没被训练」。这些都是稀疏结构的问题,不是模型容量的问题。
9. 练习
- 概念:COO 与 CSR 各自适合什么操作?为什么「构造用 COO、计算用 CSR」是常见组合?
- 计算:对 写出 CSR 的三个数组,并计算 ,其中 。
- 计算:设稀疏矩阵每行平均 个非零元、。SpMV 与稀疏乘稀疏的代价分别约为多少?与稠密 比较。
- 场景:、、top- 的 MoE 层,每 token 的 FFN FLOPs 是多少?参数量是单个专家的几倍?
- 开放:非结构剪枝能达到更高压缩率,为什么工业界仍偏爱 2:4 或块稀疏?从硬件、精度、部署三个角度说明。
参考答案
- COO 用三个等长数组,追加与合并重复项方便,适合从数据构造矩阵;CSR 按行连续存储,行切片与 SpMV 缓存友好,适合计算。构造时坐标是乱序的,CSR 需要先排序/计数;构造完转一次 CSR,之后的迭代都在 CSR 上跑。
values=[2,1,3]、col_idx=[0,2,1]、indptr=[0,2,2,3]。。- SpMV: FLOPs;稀疏乘稀疏约 次累加。稠密 SpMV 是 ,稀疏乘稀疏稠密版是 ,差距是数量级的。
- 单个专家每 token 是 FLOPs;top-2 是 。参数量是单个专家的 倍(每个专家 个权重,共 )。
- 硬件上只有结构化稀疏有张量核/块指令支持,非结构稀疏的索引与不规则访存很难转化为实际加速;精度上 2:4 通过再训练通常能恢复到接近稠密,块稀疏对大模型更友好;部署上结构化模式可预测、易做 kernel 与编译优化,非结构稀疏的负载均衡与元数据开销在服务端不划算。
10. 一页速记
- 稀疏度 = 零的比例;只存 个非零元,SpMV 代价 。
- COO = 行、列、值三个数组,适合构造;CSR = 值、列索引、行指针,适合按行计算。
- 稀疏乘稀疏的代价约 ,且结果可能填充(fill-in)。
- 结构稀疏(2:4、块)能被硬件加速;非结构稀疏的加速比通常远低于稀疏率。
- MoE 的计算随 top- 增长、显存随专家数 增长;稀疏注意力把 降到 。
- 物理意义 / 现实对应:稀疏矩阵是「图的邻接表」;SpMV 是沿每条边传一次值,算术强度约 FLOP/byte,注定访存受限。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、定理名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- Davis(2006):Direct Methods for Sparse Linear Systems。稀疏 LU/Cholesky、填充(fill-in)与消元顺序的系统教材,本页 §4.3 的填充问题直接相关。SIAM
- Davis & Hu(2011):The University of Florida Sparse Matrix Collection。真实稀疏矩阵的公共测试集,做稀疏算法实验时的标准数据源。ACM Transactions on Mathematical Software
- Mishra 等(2021):Accelerating Sparse Deep Neural Networks。2:4 结构化稀疏与硬件加速的代表性工作,对应本页 §1.2 的结构稀疏讨论。arXiv:2104.08378
下一篇 → 回到 模块导览
随堂测 · 5 题
源文件:10-数值线性代数/05-稀疏矩阵.md