11.6 LayerNorm 与 RMSNorm 的几何
本节位置:模块 11 · 大模型专题 | 前置:1.4 | 预计:30 分钟
一句话:归一化层把每个 token 的向量「摆正」到受控的尺度上,让深层网络不被数值漂移拖垮;LayerNorm 去均值再缩放,RMSNorm 只缩放。
0. 场景引入
一个 13 亿参数的模型在 8 张 A100 上做混合精度训练:24 层,隐藏维 2048,每步 400 万 token,激活用 fp16,权重留 fp32 主副本。梯度范数在崩溃前从 0.8 一路爬到 12,第 12000 步 loss 从 2.31 跳到 NaN。
复盘发现某一层残差流的范数漂到 量级。RMSNorm 要算平方和,而 fp16 的单次平方在 时溢出(),平方和变成 inf,归一化输出全 0,反传梯度随即变成 NaN。换成 bf16 确实不会溢出,但它只有 8 位二进制有效位, 附近的相对误差约 ——问题只是从「爆掉」变成「悄悄不准」。
团队要决定:把归一化的归约换成 fp32(只多几次寄存器转换),整体换 bf16(指数范围同 fp32,但尾数只有 8 位),还是加大 硬扛?三条路都能让 loss 不再 NaN,区别在于谁把问题藏起来。
代价是实打实的:一次 NaN 报废 3 天训练,按 8 张卡、每卡每小时 8 元估算约 4600 元,还要回滚到 6 小时前的 checkpoint。回滚本身还会让学习率调度错位,重跑的那 6 小时通常比原计划更慢。加大 最便宜,但它会把小范数 token 一起压平,等于让模型对稀疏激活失明。
问题:LayerNorm 和 RMSNorm 各自拿掉了哪个自由度?为什么「减均值」在残差流里可以省,在别处不行?
读完本节,你能回答的三个问题是:
- 归一化对哪个维度做、输出服从什么统计量;
- RMSNorm 省掉均值换来什么、失去什么;
- 混合精度训练里哪一步最容易溢出,怎么兜底。
1. 直觉
1.1 LayerNorm:把每个 token 的向量「标准化」
对一个 token 的 维向量 :
- 减去均值:让向量中心化,落在过原点的超平面上;
- 除以标准差:让各维尺度一致;
- 乘 加 :给模型保留「恢复原尺度/偏移」的自由。
几何上,归一化后的向量落在半径为 的球面上( 且忽略 )。
1.2 RMSNorm:只调音量,不挪中心
RMSNorm 只除以均方根,不减均值。它假设「中心已经在原点附近」,或者「均值携带信息,不该删」。
💡 一句话直觉:LayerNorm = 去均值 + 除以标准差;RMSNorm = 只除以均方根。
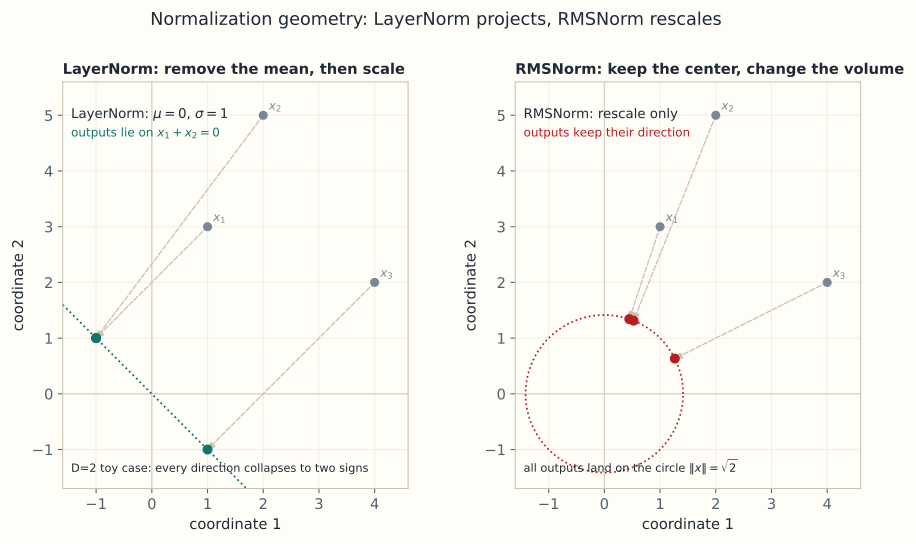
图: 的玩具情形。LayerNorm 先去均值再除标准差,输出被压到 与半径 的交点(两个方向);RMSNorm 只除以均方根,输出留在半径 的圆上,方向不变。 更大时,前者是零均值超平面与球的交,后者是整个球面。
类比边界:归一化不是「把信息变少」,而是把尺度这一自由度拿掉; 可以把尺度/偏移学回来。
1.3 它在现实世界里对应什么
LayerNorm 像相机的自动曝光:先减掉环境光的「平均亮度」(减均值,定黑位),再按对比度把画面拉到统一亮度(除标准差);RMSNorm 只做第二步,相当于只调增益、不动黑位。
量级上,、每个分量方差为 1 时,;归一化后范数被钉死在 45.3,无论输入是 还是 。但 fp16 里算平方和时,单项 在 就溢出(),2048 项累加更容易越界——所以归约必须在 fp32 里做。
这个类比在哪里失效:自动曝光对整张照片只用一个标量,而 LayerNorm 对每个 token 的 2048 维各算各的;曝光会把暗部噪声一起提亮,归一化也会把范数很小的 token 里的噪声放大到和正常 token 一样响,这与「降噪」正好相反。
2. 定义
2.1 LayerNorm
对 :
其中 是可学习参数, 防止除零。
逐 token、逐样本计算,不跨 batch。
2.2 RMSNorm
没有 ,没有 (多数实现)。
2.3 Pre-Norm 与 Post-Norm
- Post-Norm(原始 Transformer):;
- Pre-Norm(现代大模型常用;Xiong 等, 2020 分析了它与 Post-Norm 的梯度差异):。
Pre-Norm 让残差路径保持恒等,梯度更易直传,深层训练更稳。
3. 为什么这样定义
为什么减均值? 如果各维有一个很大的公共偏移(例如所有激活都加 100),后续线性层的输出会被这个偏移主导。中心化去掉这个「共模分量」。
为什么除以标准差? 让不同 token、不同层的尺度可比,避免某些维度数值过大导致 softmax/梯度饱和。
为什么 RMSNorm 可以省掉均值? 在 Transformer 的残差流里,很多信息编码在方向上,公共偏移可能不重要;而且省一次均值计算,速度更快。这是一个工程取舍,不是数学上等价。
为什么用 ? 归一化会限制表达(例如强制单位尺度)。仿射参数让模型可以学回需要的尺度与偏移,恢复表达能力。
3.1 反事实:不减均值、或不除方差
不减均值(RMSNorm 的极端): 归一化后是 ;把同一个向量整体加 100 变成 ,RMS 从 变成 ,输出成了 ——三个分量几乎相等,原本 的结构被压成 。而 LayerNorm 对这两个输入给出完全相同的 ,因为减均值把公共偏移 100 精确消掉了。
换句话说,不减均值时,一个与内容无关的共模偏移会吃掉动态范围:偏移越大,归一化后的差分越小,下一层线性层看到的信号越弱。RMSNorm 敢省这一步,前提是残差流里的共模分量确实小、且 能补回一部分;换成 embedding 输出或未归一化的激活,这个前提就不成立。
不除方差(只减均值):,而 。同一个方向、同一个「形状」,进入下一层后 logits 放大 1000 倍;取 ,点积从 变成 ,softmax 立刻饱和成 one-hot,梯度随之消失。方差归一化的作用就是把「形状」和「音量」解耦。
反过来,减均值也有代价: 与 在 LayerNorm 下不可区分,意味着「整体亮度」这个自由度被永久拿掉了; 只能补一个固定的偏移,补不回「随输入变化的共模分量」。对需要绝对尺度的任务(比如直接回归一个亮度值),这是真实的信息损失。
4. 性质与推导
4.1 LayerNorm 的输出统计量
忽略 与仿射:
即每个 token 的归一化向量均值为 0、方差为 1。
4.2 平移与缩放不变性
因为减均值去掉 ,除以标准差去掉 。RMSNorm 只对正缩放不变,对平移不不变。
4.3 RMSNorm 输出的范数
若 ,则
所以输出落在半径 的球面上。
4.4 梯度
LayerNorm 的 Jacobian 不是对角矩阵(均值/方差依赖所有维度),反向传播需要把梯度「投影」掉均值和径向分量。RMSNorm 的 Jacobian 也类似,但少了均值项。
4.5 参数量与计算
- LayerNorm: 参数;
- RMSNorm: 参数;
- 每 token 计算 ,相对矩阵乘可忽略,但推理时是内存带宽操作(第 11.7 节)。
5. 例子
5.1 手算:LayerNorm
,:
验证均值 0,方差 。
5.2 手算:RMSNorm
输出范数:。
5.3 场景:为什么大模型偏爱 Pre-Norm + RMSNorm
- Pre-Norm 让残差路径是「恒等 + 小扰动」,深层梯度不衰减;
- RMSNorm 比 LayerNorm 少一次均值、少一组参数,在数十亿次调用中节省可观;
- 代价是理论上表达略弱,但大规模训练中通常可接受。
5.4 场景闭环:400 万 token 的 batch,归一化到底花多少
回到第 0 节的 13 亿参数训练。, 层,每层两次归一化(attention 前、MLP 前),单卡 micro-batch 合计 个 token;梯度累积 16 次、8 张卡,才凑成一步 400 万 token。
输入:每张卡 个 fp16 激活,约 128 MiB()。
计算:
- 每次归一化的元素数:;每元素约 5 次浮点操作(求和、平方和、减、除、仿射),约 FLOP。
- 全模型 次调用:约 FLOP。相比之下,同一次前向的矩阵乘约 FLOP——归一化的算力占比约 。
- 带宽:每次读一遍、写一遍,;按 2 TB/s 估算约 6.5 ms。算力上可以忽略,带宽上不可忽略——这正是「低 FLOPs、高带宽」的含义。
- 溢出检查:fp16 下 时 溢出;2048 项平方和即使每项只有 1,累加也在 2048,看似安全,但只要有一项到 300 就整体
inf。改用 fp32 归约后上限是 ,余量约 。
输出决策:归一化的归约(均值、平方和)一律在 fp32 里做,结果再 cast 回 bf16/fp16 存储; 取 并参与 fp32 计算,而不是在 fp16 里加。
成本:fp32 归约只是在寄存器里多做几次转换,HBM 流量不变(读 fp16、写 fp16),实测开销通常只有个位数百分比;若把整个激活张量存成 fp32,显存直接翻倍(128 MiB → 256 MiB 每份),在长上下文训练里就是 OOM 与不 OOM 的区别。
失败条件与兜底: 太小(如 )挡不住方差接近 0 的 token, 会把噪声放大 倍; 太大(如 )又把小范数 token 压平,输出范数偏离 。兜底:把 放在 fp32、监控每层激活的最大绝对值(超过 256 就报警),并在 loss 尖峰时优先怀疑归一化而不是学习率。
6. 常见误区
-
误区:LayerNorm 是在 batch 维度上归一化。 纠正:那是 BatchNorm。LayerNorm 对每个样本的特征维归一化,与 batch 大小无关。
-
误区:RMSNorm 和 LayerNorm 只是写法不同,效果一样。 纠正:RMSNorm 不减均值,对平移敏感;两者在残差流中的行为不同。
-
误区:归一化会永久丢失信息。 纠正: 可以恢复尺度/偏移;且归一化只去掉「共模」与「整体尺度」两个自由度。
-
误区: 可以随便设。 纠正:太小会数值不稳,太大会扭曲小范数向量;通常 到 。
7. 概念网络
- 前置:1.4 范数 —— 均方根与 L2。
- 前置:11.2 线性层 —— 归一化后的变换。
- 后续:11.7 KV Cache —— 归一化是带宽瓶颈之一。
- 后续:11.12 训练稳定性 —— 归一化与梯度。
- 关联:9.4 白化 —— 去相关 vs 去尺度。
8. 通往大模型:形状与实现
形状不变:[B,T,D] → [B,T,D],逐 token 计算。
def rms_norm(x, gamma, eps=1e-6):
    # x: [..., D]
    rms = np.sqrt((x**2).mean(axis=-1, keepdims=True) + eps)
return gamma * x / rms为什么它是推理瓶颈:每个 token 都要读一遍 维向量、算平方和、再写回;在 decode 阶段,矩阵乘是「瘦」的,归一化/残差等逐元素操作的内存带宽占比反而很高。
可检验结论:RMSNorm 输出()的 L2 范数为 ,与输入尺度无关。若你的实现输出范数随输入增大,说明归一化写错了。
算错时用户看到什么: 漏加,全零向量归一化出 ,整批输出变成 nan,服务返回 500 或空字符串;归一化维度写错(对 batch 而不是特征),训练 loss 看着正常,推理 batch=1 时统计量失效,同一个问题在不同并发下答案不同; 忘了 cast 到与激活相同的 dtype,输出尺度差一个数量级,生成结果退化成重复标点;Pre-Norm 与 Post-Norm 接反,深层梯度衰减,loss 卡在一个平台不降,用户看到的是「模型好像没训练过」。
9. 练习
- 概念:LayerNorm 和 BatchNorm 的区别是什么?为什么 NLP 常用 LayerNorm?
- 计算:,求 LayerNorm(忽略 )和 RMSNorm 的输出。
- 计算:,LayerNorm 与 RMSNorm 各有多少参数?
- 场景:Pre-Norm 为什么比 Post-Norm 更容易训练深层网络?从残差路径解释。
- 开放:如果去掉所有归一化层,但把初始化尺度调得很小,能否替代归一化?可能有什么问题?
参考答案
- BatchNorm 跨 batch 统计,依赖 batch 大小、训练/推理不一致;LayerNorm 对每个样本独立,适合变长序列。
- ,,LN;RMS,RMSNorm。
- LayerNorm ;RMSNorm 。
- Pre-Norm 中残差主路径是恒等映射,梯度可以直接回传;Post-Norm 每层都经过归一化,深层连乘更易衰减/爆炸。
- 部分可以(如 Fixup 初始化),但训练动态对超参更敏感,且不同层尺度仍可能漂移;归一化提供了更鲁棒的尺度控制。
10. 一页速记
- LayerNorm:减均值、除标准差、仿射;输出均值 0 方差 1。
- RMSNorm:只除均方根; 时输出范数 。
- 都是逐 token、逐样本,不跨 batch;Pre-Norm 保残差恒等路径。
- 归一化是低 FLOPs、高带宽的操作;fp16 平方和在 时溢出,归约要用 fp32。
- 物理意义 / 现实对应:像自动曝光——先定黑位(减均值)再拉对比度(除标准差),只改尺度不改内容。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、定理名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- Ba 等(2016):Layer Normalization。LayerNorm 的原始论文:对单个样本的特征维计算均值与方差,再做仿射变换;本页 2.1 的公式与「逐 token、不跨 batch」都来自这里。arXiv:1607.06450
- Zhang & Sennrich(2019):Root Mean Square Layer Normalization。RMSNorm 的原始论文:去掉减均值与偏置,只除以均方根,并在多项任务上取得相当或更好的效果——本页 1.2 的「只调音量」说的就是它的几何含义。arXiv:1910.07467
- Xiong 等(2020):On Layer Normalization in the Transformer Architecture。分析 Pre-Norm 与 Post-Norm 的梯度尺度,说明 Pre-Norm 在初始化附近梯度更稳定,解释了本页 2.3 为何现代大模型偏爱 Pre-Norm。arXiv:2002.04745
下一篇 → 11.7 KV Cache:形状、显存与带宽
随堂测 · 3 题
源文件:11-大模型专题/06-LayerNorm与RMSNorm.md