9.1 概率与随机变量:从样本到分布
本节位置:模块 9 · 概率与统计 | 前置:1.4 范数与距离 | 预计:35 分钟
一句话:分布是生成数据的规则,样本是规则吐出的一张牌;期望和方差用两个数概括牌堆的中心与胖瘦。
0. 场景引入
一家电商的实验平台每周同时跑 40 个 A/B 实验。这周要判的是「一键下单」改版:210 万用户随机对半分,对照组 105 万人转化率 4.31%,实验组 105 万人转化率 4.34%。
差 0.03 个百分点,折算成订单是 315 单。可按二项分布估算,即使两组真实转化率完全相同,这个差值本身的波动(标准差)也有 0.028 个百分点,约 295 单——信号只比噪声高一点点, 约为 1.1。
产品经理要在 24 小时内决定:立刻全量上线,还是再等一周把样本翻倍?如果效应是真的,每天多 315 单、客单价 180 元,一年约 2 070 万元;如果它是噪声,上线后要回滚、发版、培训客服,代价远不止等一周少赚的 40 万元。
他手里只有一个数:两个转化率之差。要判断它是不是真的,先得把「一个用户会不会下单」看成随机变量,把 210 万次曝光看成样本,再用期望与方差说清楚「差多少才算不一样」。
读完你能回答的三个问题:
- 4.34% 与 4.31% 的差,正常波动有多大?
- 为什么能用 105 万个样本的方差,去代替「全体用户」的方差?
- 如果同时看转化率与客单价,协方差告诉你什么?
1. 直觉
一维直方图里,均值(mean) 是点云重心,方差(variance) 是绕重心的转动惯量。二维点云则多了一个「往哪斜」的信息:
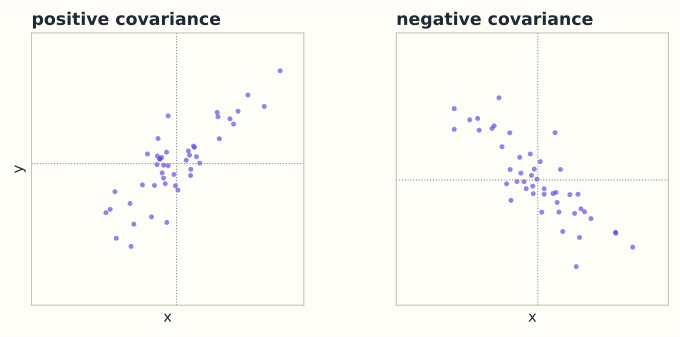
图:虚线是两维各自的均值。同向偏离时协方差为正,反向为负;点云接近正圆时接近 0。
同向偏离时协方差为正,反向为负,云团像正圆时接近 0。
💡 一句话直觉:方差量点云有多胖,协方差量点云往哪个斜方向胖。
1.1 它在现实世界里对应什么
回到实验平台。那些抽象符号在这里都有一张具体的脸:
| 数学对象 | A/B 实验里的对应物 |
|---|---|
| 随机变量 | 一个用户「是否下单」,取值 0 或 1 |
| 分布 | 全体用户的下单倾向,由真实转化率 决定 |
| 样本均值 | 105 万人的实测转化率 4.34% |
| 方差 | 用户之间的差异:伯努利变量的方差 |
| 标准误(standard error) | 这个 4.34% 自身的抖动,约 个百分点 |
| 协方差 | 「下单」与「客单价」是否同涨同落 |
均值是「这批人的典型表现」,方差是「个体之间的分歧有多大」,而样本量 决定「把分歧平均掉之后还剩多少抖动」。三者合起来,才构成「可信」这个词的数学内容。
量级直觉(经验值):、 时,标准误 个百分点。也就是说,转化率这个数字写到小数点后第二位就开始抖了;想分辨 0.01 个百分点的提升,样本量要再加一个数量级。
1.2 这个类比在哪里失效
均值和方差只描述前两阶信息。两个双峰分布可以有相同的均值和方差,形状却完全不同;完整描述需要整个概率函数。
第二个失效点更要紧:A/B 实验里「样本独立」这个前提常被破坏。同一台手机会下两单、同一个家庭的两个账号会一起收到优惠券、社交裂变会让实验组互相影响——这时真实的方差比二项公式大, 会把噪声低估,你算出的 就虚高。公式没错,是那条「独立同分布」的假设在这里断了。
2. 定义
2.1 随机变量与分布
随机变量(random variable) 是映射 。离散情形用概率质量函数(probability mass function, pmf) ,满足 、;连续情形用概率密度函数(probability density function, pdf) 、。注意 可以大于 1,只有积分才是概率。
2.2 期望、方差、标准差
期望(expectation) (离散)或 (连续);方差(variance) 。这里 是标准差(standard deviation),与 同单位;后一个等号是计算时最常用的形式。
2.3 协方差与相关系数
两个随机变量的协方差(covariance):
读法:各自减去均值再相乘求期望。相关系数(correlation coefficient) 去掉了量纲。
对随机向量 ,协方差矩阵(covariance matrix) ,其中 。对角元是各维方差,。
2.4 样本估计
式中前者是样本均值(sample mean),后者是样本协方差(sample covariance);分母 使 (无偏);除以 是最大似然估计,样本多时几乎一样。
2.5 大数定律
大数定律(law of large numbers):若 独立同分布、期望 、方差有限,则样本均值依概率收敛:。这就是「样本多时频率稳定」的数学版本,保证上面的估计在 变大时靠谱。
3. 为什么这样定义
协方差为什么减 ? 不减的话, 会把两个变量各自的整体水平算进去。身高体重都为正, 天然很大,却不说明相关;减去均值后只看「同时偏离中心」的部分。
为什么用平方而不是绝对值? 平方可导、与欧氏几何一致,还带来可加性:不相关时方差直接相加。绝对值是另一种风险度量,但在 0 点不可导。
为什么协方差矩阵半正定? 把中心化样本堆成 ,则 ,是 Gram 矩阵(第 2.7 节)。于是它半正定,且 。样本数少于维度时,协方差必然奇异——这条事实后面反复出现。
为什么除 ? 来自同一批数据,用掉一个自由度:离差满足 , 个离差只有 个自由。除以 正好补偿。
3.1 反事实:不减均值、或者不用平方,会坏在哪
反事实 A:直接用 当「关联度」,不减均值。
取 、(可以想成「价格档位」与「成交量档位」),比较三种搭配:
| 搭配 | 协方差 | ||
|---|---|---|---|
| 同向 各 | |||
| 独立四种组合各 | |||
| 反向 各 |
三个 只差 ,而 这个「整体水平」占了八成的份量。若 改用「分」而不是「元」, 整体放大 100 倍,差值也跟着放大——判读结果完全取决于量纲。减掉均值后, 才干净地只说出「同向、无关、反向」。
反事实 B:用绝对值的期望 代替协方差。
取 等概率、,则 、:
但绝对值版本给出
真相是 完全由 决定,协方差却报 0,绝对值版本报「有关联」。两个都不算错,各有各的用途:绝对值版本对非线性依赖更敏感,但它不再双线性,于是 这条可加性直接作废——而后者正是误差按平方和累加的全部基础。这就是协方差为什么必须是「乘起来再求期望」:只有双线性,才能被矩阵和矩阵分解接管,才有后面 9.2、9.3、9.4 的整条链。
4. 性质与推导
4.1 期望的线性性
。这条不需要独立性,是概率里最容易被低估的工具。
4.2 方差公式
。
4.3 协方差的双线性
,且 。于是 :只有不相关时方差才直接相加,这就是误差按平方和累加的来源。
4.4 协方差矩阵半正定
对任意 ,,它正是标量 的方差。等号成立当且仅当数据在 方向上没有波动。
4.5 相关系数的范围
对中心化变量用柯西–施瓦茨不等式(第 1.3 节):,故 。 表示 是 的正线性函数, 表示负线性函数;非线性依赖可以做到 。
4.6 无偏性与收敛
由 ,取期望得 。所以除以 后期望正好是 。又 ,切比雪夫不等式给出依概率收敛。
5. 例子
5.1 手算:一个联合分布
设 ,概率 ,令 :
| 0 | 1 | 2 | |
|---|---|---|---|
| 0.2 | 0.5 | 0.3 | |
| 0 | 1 | 4 |
的矩:,,故 。
的矩:,,故 。
协方差:
完全由 决定,相关系数却只有 : 不是线性函数, 只捕捉线性部分。
5.2 手算:样本方差为什么除
样本 :,离差 ,平方和 。于是 ,除以 则得 。比值 ; 时只差 0.1%。
5.3 场景:一层激活的协方差
、, 是 ,共 个数,fp32 下 64 MiB。对角元是各维方差(该特征活不活跃),非对角元是两维是否同涨同落。若 ,只有中等线性同步;相关不等于冗余,更不等于因果。
5.4 场景闭环:210 万人、一次上线决策
把开头那场实验从头算到尾。
输入:两组各 条曝光记录,每条只需 (group:int8, converted:int8, gmv:float32),共 。扫描一遍是 的,单核十几毫秒。
计算:两组转化率之差
标准误按两组独立、二项方差 估:
于是 ,95% 置信区间
这个式子说的是:真实效应可能为负——区间跨过了 0。
输出:决策是「不显著,不上线;把样本跑到下周」。下周每组样本翻倍, 按 降到约 个百分点;若真实效应真是 0.03 个百分点,届时 会升到约 1.5,还不够;要到每组 400 万人才比较稳(按 反解 )。
第二件事:同时看客单价 。若 元,读法是「下单的人客单价平均低了 12 元」——转化率涨 0.03 个百分点带来的人,可能被客单价的下滑抵消掉,这时该看的是 GMV 而不是转化率。
成本:12.6 MB 访存、一遍 求和,十几毫秒。若改用逐日 bootstrap 1000 次重采样来估 值,代价是 次抽样,分钟级——这也是为什么线上平台默认用解析公式而不是重采样。
失败条件与兜底:
- 用户不独立:同一人多设备、家庭共享账号、社交裂变,会让真实方差大于二项公式, 虚高。兜底:按用户聚类做 delta method,或用 cluster bootstrap。
- 多重比较:一周 40 个实验、每个看 3 个指标,就是 120 次检验;在 5% 水平下期望 6 个假阳性。兜底:Bonferroni 收紧阈值,或改用 FDR 控制。
- 偷看与早停:每天看一次、显著就停,会让假阳性率从 5% 涨到 20% 以上(可选停止偏差)。兜底:事先定样本量与检验时点。
- 指标不独立:转化率与客单价协方差非零时,单指标决策会漏掉另一边的损失。兜底:把 GMV 作为唯一主指标,或做多指标联合检验。
6. 常见误区
- 误区:协方差为 0 就是独立。纠正:只说明没有线性关系。取 在 均匀、,则 ,但 完全由 决定。只有联合高斯时,不相关才等价于独立。
- 误区:样本协方差就是真实协方差。纠正:它是估计量,本身有波动; 个样本的协方差秩不超过 , 时必然奇异。
- 误区:方差可以直接相加。纠正:,不相关时后一项才消失。
- 误区:相关系数 0.9 说明强因果或高度冗余。纠正:它只说明线性同向程度,可能有共同原因或数据泄漏。
7. 概念网络
- 前置:1.4 范数与距离 —— 方差是中心化向量长度平方的平均。
- 前置:6.5 二次型与正定 —— 是二次型,非负即半正定。
- 后续:9.2 多元高斯 —— 用 完整描述一类分布。
- 后续:9.3 PCA —— 对 做特征分解,找方差最大的方向。
- 后续:9.4 白化 —— 把 变成单位阵。
- 关联:11.11 logits、softmax、温度 —— 从 logits 到采样分布。
8. 通往大模型:激活统计与采样
出现位置:每层激活的协方差、LayerNorm 的均值/方差、参数初始化的方差推导,以及从 logits 采样下一个 token。
形状:隐藏状态 ,摊平成 个样本;,。 时 有 1677 万个数(fp32 64 MiB); 时它必然奇异。
为什么需要:线性层 在独立假设下 。取 、输入方差 1,输出方差约 1;若误用 , 时输出方差约 4096,深网络会指数爆炸。LayerNorm 则直接除以当前 token 的标准差。
可检验结论:用 个样本估计均值的误差量级是 ; 时约 3.2%,这解释了大 batch 的统计为什么更稳。
import numpy as np
rng = np.random.default_rng(0)
X = rng.normal(size=(8000, 4096))          # [N, D]
mu = X.mean(axis=0)                         # [D]
Xc = X - mu
Sigma = Xc.T @ Xc / (len(X) - 1)            # [D, D]
print(Sigma.shape, np.trace(Sigma) / 4096) # 平均方差 ≈ 1采样温度:。 退化为 one-hot(贪心), 趋于均匀。温度改变的是概率质量集中的范围,不是 logits 的方差;这正好接上 9.2 与 11.11。
如果这一步算错,下游看到什么现象:均值、方差这类统计量出错,通常不会报错,只会让下游悄悄变差。
- 忘记减均值直接算二阶矩 :PCA 的第一主成分会偏到「均值方向」,散点图上所有样本得分同号,看起来「结构很强」,其实是整体偏移。
- 初始化时把方差写成标准差(或漏掉 ): 的线性层输出方差会差 4 096 倍,深网络的 loss 在前几十步就出现尖峰或直接 NaN。
- 用 与 混用:解释方差比不受影响(比值的常数约掉了),但重建误差与似然阈值会差 倍,跨模型比较时会出现「同样的数据,两个脚本给出两个误差」。
这些错误的共同特征是:数值都有限、曲线都连续,只有指标在慢慢偏。所以排查时要先对齐统计量的定义,再怀疑模型。
9. 练习
- 概念:一句话区分「概率分布」与「样本」,并说明 3 个样本为什么估不出 4096 维协方差。
- 计算:,概率 ,令 。求 。
- 计算:样本 ,分别用 与 作分母求方差。
- 场景:、 时样本协方差的秩最多是多少?哪些下游计算会失效?
- 开放:举一个「协方差为 0 但明显不独立」的例子,并说明激活维度「不相关」为什么不能当作「信息不重叠」。
参考答案
- 分布是生成样本的规则,样本是按规则抽出的点。3 个样本的中心化矩阵秩最多 2,协方差秩也最多 2,远小于 4096。
- ,,;,。
- 均值 4,离差平方和 8;,除以 得 。前者无偏。
- 秩 。 不可逆,密度没有定义;PCA 最多 99 个非零方向;白化、马氏距离、高斯似然都失效。
- 在 均匀、。不相关只说明没有线性同步,仍可能通过非线性方式共享信息。
10. 一页速记
- 分布是规则,样本是抽样;用 从样本估计分布。
- 物理意义 / 现实对应:均值是点云重心,方差是绕重心的转动惯量;在实验平台上,它们就是「实测转化率」和「这个数字自身的抖动」,单位分别是「个」和「个²」。
- ,。
- 是 Gram 矩阵,半正定,秩 。
- 只测线性关系;不相关不等于独立。
- 大数定律:,误差量级 。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、定理名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- 柯尔莫哥洛夫(Andrey N. Kolmogorov, 1933):Grundbegriffe der Wahrscheinlichkeitsrechnung。把概率论建立在测度论公理之上,本页的随机变量 、期望与分布都在这个框架里定义。Springer(DOI)
- 皮尔逊(Karl Pearson, 1896):Mathematical Contributions to the Theory of Evolution. III. Regression, Heredity, and Panmixia。把相关系数与回归做成可计算的统计量,本页 的归一化定义沿用的就是这条线。Royal Society(DOI)
- 柯西(Augustin-Louis Cauchy, 1821):Cauchy’s Cours d’analyse: An Annotated Translation(原著 Cours d’analyse de l’École royale polytechnique,1821)。柯西–施瓦茨不等式的有限和形式出自这部讲义;本页用它证明 。英译注本(Springer, 2009)
下一篇 → 9.2 多元高斯
随堂测 · 4 题
源文件:09-概率与统计/01-概率与随机变量.md