8.8 拉格朗日乘子与约束优化
本节位置:模块 8 · 微积分与优化 | 前置:8.2 梯度下降、8.6 凸性 | 预计:35 分钟
一句话:在约束曲面上找最优点,梯度不再为零,而是与约束的梯度平行;乘子就是「放松一点约束,目标能改善多少」的价格。
0. 场景引入
一条钢板表面质检线,每分钟过 30 块 2 m² 的热轧板。视觉系统把每块板压成 512 维特征,要判「有缺陷 / 无缺陷」。训练集有 12 万 个标注样本,缺陷样本只占 3%,标注很贵。
你决定用线性 SVM:
它要在「分对」的前提下让间隔 尽量宽。约束有 12 万条,对应 12 万个乘子 。
上线时你发现:真正起作用的乘子只有约 8%,也就是 9600 个,其余 11 万个 ——它们的约束根本没顶住边界。如果误把所有样本都当支持向量,推理要从 9600 次内积变成 12 万次,慢 12.5 倍;如果反过来误删了真正起作用的样本,间隔被破坏,漏检率上升,漏掉一块 2 m² 的缺陷板,按 3000 元/块算,一条线一天就赔几千元。
哪些约束在顶住?哪些可以扔掉? 这不是工程技巧,而是 KKT 里的互补松弛 直接告诉你的。乘子 还有第二个读法:影子价格——把第 个样本的间隔要求放松 1 个单位,目标能改善多少。
同一个数学出现在 RLHF 里:把「KL 不超过 」写成约束,乘子就是那个 (§4.4、§8)。这就是约束优化(constrained optimization)要回答的问题。
读完本节,你应该能回答三件事:
- 为什么最优点处 一定与约束曲面垂直,乘子为什么是「价格」?
- 互补松弛说的是什么,它凭什么能让你扔掉 92% 的样本?
- SVM 的 和 RLHF 的 是同一件事吗?
1. 直觉
1.1 沿着约束曲线找最低点
在 的等高线图上,约束 是一条曲线。你要在曲线上找 的最低点。
沿着曲线走,如果还能让 下降,就继续走;走到某点,沿曲线的任何方向 都不再下降,就停。此时 的梯度必须垂直于曲线的切线——而 的梯度也垂直于切线。两个梯度只能平行。
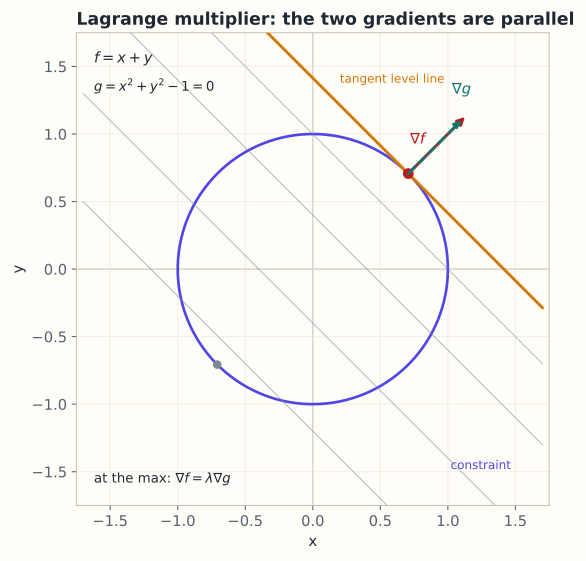
图:约束是单位圆 ,目标 的等值线是一族平行线。最优点处等值线与圆相切, 与 平行。
1.2 乘子是「价格」
约束 稍微放松成 ,最优值会改善多少?改善率就是乘子。
💡 一句话直觉:在最优点,目标函数的梯度被约束的梯度「顶住」了;乘子衡量这个顶住的力度。
类比边界:梯度平行是必要条件,不是充分条件;它也可能对应局部极大或鞍点。要确认最优,还要比较候选点或检查二阶条件。
1.3 它在现实世界里对应什么
在质检线这里,拉格朗日乘子有一个可以拿在手里的身份:
| 数学对象 | SVM 里的对应物 | 单位 |
|---|---|---|
| 目标 | 间隔的倒数平方(越小间隔越宽) | 1/特征单位² |
| 约束 | 「第 个样本必须分对且留出 1 单位边距」 | 无量纲 |
| 乘子 | 第 个样本把边界「顶住」的力度 | 1/特征单位² |
| 影子价格 | 放松第 个样本的边距,目标改善多少 | 同乘子 |
单位要小心:如果特征从「毫米」换成「米」,每个 缩小 1000 倍, 就要放大 1000 倍才能保持 不变;于是 放大 倍,乘子 相应缩小 倍。但支持向量的集合不变——「谁在边界上」是几何事实,与单位无关。这是一次很好的自检:换单位后支持向量变了,代码里一定有 bug。
量级直觉:12 万样本里约 8% 是支持向量。硬间隔下,支持向量恰好落在 上;其余样本的边距可能远大于 1(比如 3),它们的乘子必须为 0。
边界:硬间隔要求数据线性可分,钢板数据几乎不可能——缺陷与正常样本在 512 维里仍有重叠。这时要换成软间隔(约束放松为 ,乘子上界为 ),互补松弛的形式不变,但「顶住」的样本分成两类:边界上的()和被截断的()。 越大越接近硬间隔,也越容易过拟合。
这个类比在哪里失效:核 SVM 里 可能根本不存在于原始空间(无限维),乘子和支持向量的结论照样成立,但「 的单位」这种说法就失效了——只剩内积 有意义。
2. 定义
2.1 等式约束问题
考虑 ,约束 ()。拉格朗日函数(Lagrangian)定义为
称为拉格朗日乘子(Lagrange multiplier)。
2.2 一阶必要条件
在最优点 (且约束梯度线性无关)处,存在 使 ,且 。第一条说「目标梯度是约束梯度的线性组合」,第二条说「点必须可行」。
2.3 不等式与 KKT
对 s.t. ,构造 。KKT 条件(Karush–Kuhn–Tucker conditions)是:
最后一条叫互补松弛(complementary slackness):约束不起作用时(),乘子必须为 0;乘子为正时,约束一定取等号。
3. 为什么这样定义
无约束时,最优点要求「所有方向都不能下降」,即梯度为零。有约束时,可行方向变少了:只剩与约束曲面相切的方向。
只要沿可行方向不能下降就够了,不需要全空间梯度为零。于是梯度可以有一个「法向分量」,被约束的梯度抵消——这正是 。
为什么不直接把约束代入消元?有时可行(例如 解出 ),但很多时候约束是非线性的、多个的,解不出来。乘子法把「约束」变成「目标的一部分」,可以用无约束的方法处理,还能顺便得到乘子的经济含义。
3.1 反事实:不写互补松弛,会多留 92% 的样本
取一维硬间隔问题,三个点:
最优解可以直接看出来:、,间隔边界在 ,间隔宽 。第三个点稳稳在边界外。
对偶函数是
互补松弛要求 ,而括号里是 ,所以 。取 、:,,正好等于原问题最优值 。
反事实:不管互补松弛,给三个点都分配 。 那么
对偶是最大化 ,而 ——这组乘子离最优极远。换成原问题的语言: 从 涨到 (6.25 倍),规范间隔 从 掉到 。 这个本来对边界毫无影响的样本,把整个分类器往它那边拉了。
这就是互补松弛的作用:它是一张「谁在顶住」的名单。名单外的约束()乘子必须为 0,可以整条丢掉;名单内的()乘子才可能非零。12 万条约束里只有 8% 在名单上——扔掉 92% 不是近似,是精确的代数结论。
另一个反事实:去掉「约束梯度线性无关」这个前提。 考虑 s.t. 。可行集只有 ,它就是唯一最优解。但拉格朗日函数 的驻点条件是 ,在 处变成 ——根本不存在乘子。原因是约束的梯度 在最优点处为零,法空间退化了。这就是「约束品性(constraint qualification)」为什么要单独假设:它不是技术性凑数,而是乘子存在的门票。
4. 性质与推导
4.1 几何推导
设约束曲面 在 处的切空间为 。若 在 上有非零分量,沿该方向(或反方向)走一小步仍可行,且 会下降,矛盾。所以 必须与 正交,即 。
多个约束时,法空间由所有 张成,于是写成线性组合。
4.2 乘子作为敏感度
考虑扰动问题 ,最优值记为 。可以证明 。读法:约束右端每增加 1 个单位,最优值变化 。所以乘子也叫影子价格(shadow price)。这个解释在资源分配、RLHF 的 KL 预算里都成立。
4.3 对偶(duality)
定义对偶函数 。对任意可行 和任意 (不等式情形要求 ),有 ,所以 ,这叫弱对偶(weak duality)。
若原问题是凸的且满足约束品性(如 Slater 条件),则强对偶成立:。此时 KKT 不仅必要,而且充分。完整证明不展开,记住结论与适用条件即可。
4.4 KL 正则目标的闭式解
对 ,加上 的约束,构造
对 求偏导并令其为零,得 ,解出 。 越大,指数越平,策略越接近参考模型; 时退化为「只挑奖励最高的动作」。
5. 例子
5.1 手算:圆上离直线最近的点
s.t. 。,,条件 、,所以 。代入约束 ,得 ,,最优值 。
几何验证: 与 平行;原点(无约束最优)到直线 的距离是 ,平方正好是 。
5.2 手算:两动作的 KL 正则策略
设两个动作,,,。由 §4.4,,归一化得 。
KL 为 。目标值:。
对照:不约束时最优是 ,奖励 1,但 KL 无穷大; 时会更靠近 。β 就是「奖励」与「别走太远」之间的汇率。
5.3 场景闭环:12 万样本、9600 个支持向量、每分钟 30 块板
输入: 是 行、512 列(fp32 约 245 MB),外加标签。对偶问题里的核矩阵是 个元素、fp32 下 57.6 GB,存不下。
计算:用 SMO 分解,每步只更新两个 ,需要现算一列核。一次内积 ,一列 12 万个内积约 FLOP;一万步左右合计约 FLOP。
输出:,以及支持向量清单(约 9600 个)。上线时只保留这 9600 个:推理从 12 万次内积降到 9600 次,快 12.5 倍,模型从 245 MB 降到 19.6 MB。
成本:训练 FLOP,内存不存核矩阵(按列现算,只多 12 万个数);推理单样本 FLOP,在 30 块/分钟的节拍下绰绰有余。
失败条件与兜底:
- 数据不可分:硬间隔无解,SMO 不收敛。兜底:软间隔,加 并允许 , 用验证集选。
- 支持向量判定不稳: 在 附近时,浮点误差会让「是不是支持向量」抖动。兜底:阈值取 ,边界附近的样本按「保留」处理(多留不少删)。
- 特征尺度差 1000 倍:核矩阵条件数变差,SMO 收敛慢。兜底:标准化到单位方差。
6. 常见误区
-
误区:乘子 就是约束的值。 纠正: 是敏感度(影子价格),量纲是「目标 / 约束」。约束值在 里,不在 里。
-
误区:拉格朗日函数的驻点就是原问题的最优解。 纠正:驻点只是候选。要检查可行性、二阶条件;不等式问题还要检查互补松弛与 。
-
误区:KKT 总是充分条件。 纠正:一般问题里 KKT 只是必要条件(在约束品性下)。凸问题 + Slater 条件下才是充分必要条件。
-
误区:有约束就直接代入消元最省事。 纠正:消元会改变问题的几何、丢失乘子的敏感度信息,而且很多约束解不出显式表达式。乘子法保留了结构。
7. 概念网络
- 前置:8.2 梯度下降 —— 无约束时的「梯度为零」。
- 前置:8.6 凸性 —— 凸 + 约束品性 ⇒ 强对偶,KKT 充分。
- 后续:11.x RLHF 与对齐 —— KL 约束下的策略优化。
- 关联:8.5 矩阵求导 —— 对 求偏导用的是同一套规则。
- 关联:[3.2 矩阵乘向量] —— 约束 是线性等式约束。
8. 通往大模型:RLHF 里的 β 就是乘子
出现位置:RLHF/DPO 的目标函数。策略 是词表 上的分布(),序列级 KL 是对 个 token 的 KL 求和。
约束形式:把「KL 不超过 」写成硬约束,拉格朗日函数是 。由互补松弛,起作用的 KL 约束对应 ; 就是「每多花一单位 KL,能换多少奖励」的价格。工程上通常直接扫 (如 0.01–0.1),而不是扫 ,因为 更好调。
为什么需要:没有 KL 约束,策略会利用奖励模型的漏洞(reward hacking):奖励高但文本退化。KL 项把策略锚在参考模型附近,保住语言能力。
可检验结论:由 §4.4 的闭式解,,即隐式奖励 。DPO 正是把这个关系代回偏好损失,从而跳过显式奖励模型——这是「乘子/闭式解」直接变成一个训练算法的例子。
如果 选错,你会看到什么: 时奖励分数持续上涨,但人工抽检的文本质量下降——重复、谄媚、格式怪异,因为策略找到了奖励模型的漏洞(reward hacking); 太大时策略几乎不动,训练曲线平得像没训。这两种现象不需要外部 benchmark 就能观察到:前者看「奖励涨、人工评跌」的背离,后者看 KL 估计值贴着 0。
9. 练习
- 概念:为什么最优点处 要与约束曲面垂直?如果 有切向分量,会发生什么?
- 计算: s.t. ,求最优点、乘子与最优值。
- 计算: s.t. (),用拉格朗日乘子求解。
- 计算:两动作,,,,求最优 、KL 与目标值(保留三位小数)。
- 开放:如果把 RLHF 的 KL 约束去掉,只最大化奖励,会发生什么?为什么「奖励模型」本身会让问题更糟?
参考答案
- 若 有切向分量,沿该方向(或反方向)走一小步仍在约束曲面上,且 会变化;取下降的那个方向就得到更优的可行点,矛盾。因此 只能沿法向,即与 平行。
- ,,所以 ,;代入 ,得 ,,,。
- ,,得 ,,所以 ,。
- ,归一化得 。KL ,目标 。
- 策略会收敛到奖励模型的最高分点,通常是重复、谄媚或乱码——因为奖励模型只是人类偏好的近似,其误差在无约束优化下会被放大。奖励模型越强,越容易被找到对抗样本;KL 约束限制了搜索范围,但只是缓解,不能根治。
10. 一页速记
- 等式约束:,且 。
- 几何:最优点处 与约束法空间平行。
- 乘子 = 影子价格:。
- 不等式:KKT = 驻点 + 可行 + + 互补松弛。
- RLHF:KL 约束的乘子 给出 。
- 物理意义 / 现实对应:乘子是影子价格——SVM 里它是「每个样本把边界顶住多大力」,RLHF 里它是「每单位 KL 换多少奖励」的汇率;互补松弛则是一张「谁在顶住」的名单。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、定理名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- Lagrange(1788):Mécanique Analytique。拉格朗日乘子法的源头;本页 §2 的 Lagrangian 与驻点条件由此得名。Cambridge University Press 重印本
- Kuhn & Tucker(1951):Nonlinear Programming。KKT 条件的经典论文;本页 §2.2 的不等式约束与互补松弛条件直接来自这里。University of California Press
- Boyd & Vandenberghe(2004):Convex Optimization。对偶、Slater 条件与 KKT 充分性的开放教材,对应本页 §4 的强对偶讨论。Cambridge University Press
下一篇 → 模块 M09 概率与统计(尚未发布)
随堂测 · 5 题
源文件:08-微积分与优化/08-拉格朗日乘子.md