1.5 夹角与余弦相似度
本节位置:模块 1 · 向量与几何 | 前置:1.3、1.4 | 预计:30 分钟
一句话:余弦相似度只比较「方向」,丢掉「长度」,因此适合判断两段文本/两个向量在语义上是否指向同一件事。
0. 场景引入
一个单细胞实验室,一台测序仪一次跑 1 万个细胞 × 2 万个基因,共 2 亿个数。每个细胞是一个 20000 维向量,第 个分量是基因 在该细胞里被测到的读数(counts)。
麻烦在于:向量长度主要由测序深度决定。有的细胞被测到 2000 条 read,有的 20000 条,长度差 10 倍,可这只是「测得深」,不代表生物学差异。
决定:用欧氏距离还是余弦来给细胞分群、做类型注释?用欧氏距离,同一类型的细胞会因为测序深度不同被劈成两群,下游把技术噪声当成「新细胞类型」——一篇结论可能就此是假的;重跑一次测序要 3 万元和两周。
两种做法摆在桌上:先按总 counts 归一化再算余弦(便宜,但把「测得深」这件事也一起丢了);或者把 log 深度作为协变量放进下游模型(贵,但保留了置信度)。
读完本节,你应该能回答三个问题:
- 余弦丢掉了什么,为什么在单细胞数据里丢掉它反而是对的?
- 为什么归一化之后,欧氏距离排序与余弦排序完全一致?
- 什么情况下余弦会骗你(各向异性、长度本身带信息)?
1. 直觉
两个箭头夹角越小,方向越一致。把夹角变成 的数:
- :完全同向(语义相同);
- :正交(无关);
- :完全反向。
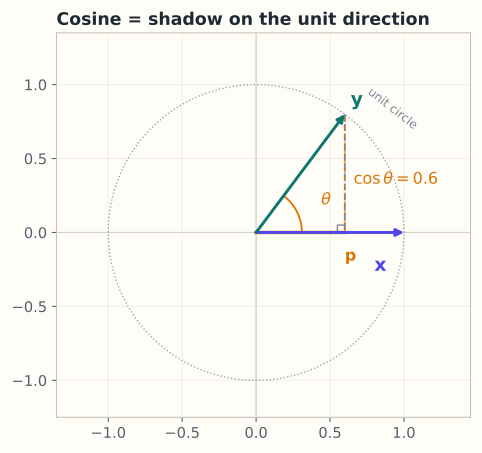
图:把 缩到单位圆上,它在 方向上的投影长度就是 。这里 ,投影是 ,所以 。
💡 一句话直觉:余弦相似度 = 把两个向量都缩到单位圆上,再看它们的点积。
类比边界:方向相同不等于含义相同。反义词在 embedding 里可能方向相反(负相关),也可能方向相近(常一起出现),取决于训练数据。
1.1 它在现实世界里对应什么
余弦像看风向:两支旗子指向同一方向,就是同一种天气形势,跟你站得远近、旗子大小无关。单细胞里,「方向」是各类基因的相对比例(表达谱的形状),「长度」是测序深度。
量级:两个随机 20000 维单位向量的余弦,标准差约 。所以余弦 0.1 已经偏离随机 14 个标准差——在 2 万维里这是很强的信号,不要拿二维平面里「夹角 84°」的直觉去套。
这个类比在哪里失效?风向有绝对参考系(北),embedding 没有。模型常把所有向量挤进一个窄锥,两两余弦都在 0.3–0.6,绝对数值失去意义,只能比相对排序。
2. 定义
2.1 余弦相似度
要求 。
2.2 余弦距离
注意它不是严格的距离(不满足三角不等式),但常被当作「不相似度」使用。
2.3 归一化向量
归一化后 ,于是 。 先把库里的向量全部归一化,检索时只需一次点积,这是向量数据库的常见优化。
3. 为什么这样定义
欧氏距离同时受方向和长度影响:
即使方向完全一致,只要长度不同,距离就不为零。文本 embedding 的长度常与词频、句子长度、模型置信度相关,这些不是我们想比较的语义。
除以两个范数,相当于把两个向量都投影到单位球面上,只保留角度信息。这与「语义相似度」的直觉一致:说的是不是同一件事,与说得多大声无关。
3.1 反事实:用点积或欧氏距离代替余弦
取两个表达谱完全相同的细胞,只是测序深度差 10 倍,再取一个表达谱相反的细胞:
与 是同一群, 是另一类。三种度量给出:
而 与 的欧氏距离只有 。按欧氏距离排序,同一群细胞之间的距离(40.2)是不同类之间(2.83)的 14 倍——聚类会把同一群劈成两半,把不同类并成一群。
荒谬之处一眼可见:分群结果完全由「这个细胞被测得多深」决定,而不是由它表达了什么决定。点积版本更糟:它连方向都不看,read 数越大的细胞与所有细胞的相似度都高,等于把「测序深度」直接当成「相似度」。
4. 性质与推导
4.1 与点积、欧氏距离的关系
- ;
- 若两者都已归一化,则 ,所以归一化后的欧氏距离与余弦相似度单调对应。
这解释了一个常见现象:对归一化向量,用内积检索和用欧氏距离检索结果排序相同。
4.2 取值范围与退化
由柯西–施瓦茨,,所以余弦在 。 若 ,分母为 0,余弦无定义;实现中通常返回 0 或跳过。
4.3 不是严格距离
不满足三角不等式。例:取三个向量, 可能大于 。因此基于余弦的最近邻检索不保证度量空间性质,某些索引结构(如 ball tree)不适用。
5. 例子
5.1 手算:三组向量
同向:,。
长度不同,但方向完全一致。
45°:,。
正交:,,点积 0,余弦 0。
5.2 场景:同一群细胞,深度差 5 倍
两个细胞的向量(为了看清计算,只保留 2 个基因):
细胞 A (测序深度浅), 细胞 B (同一群,深度是 A 的 5 倍)。
欧氏距离:——距离被深度撑大了。 余弦:两者都是 1。若 B 的表达谱略有偏差,比如 :
仍然很高。长度不再干扰排序——这正是我们想要的。
5.3 场景:为什么 embedding 常做归一化
「把文档表示成向量、用夹角排序」这套做法来自信息检索的向量空间模型,Salton 等在 1975 年把它写成可计算的索引模型。
向量数据库(FAISS 等)常用内积(IP)索引。若入库前把所有向量归一化,内积就等于余弦,既省去除法,又能用同一套矩阵乘法加速。今天说的 embedding 大多指 Mikolov 等 之后的可训练词向量;它们的长度随训练目标漂移,所以检索系统通常先把它们归一化。
5.4 场景闭环:1 万个细胞的类型注释
输入:1 万细胞 × 2 万基因的 counts 矩阵,按 5% 非零估算,非零元 个。稀疏存储(4 B 值 + 4 B 索引)约 80 MB;稠密 fp32 要 800 MB。
计算:与 30 类参考表达谱逐一算余弦, 次乘加,按 50 GFLOP/s 估算约 0.24 s。
输出:每个细胞一个类型标签与最高分;低于阈值的送人工复核。
成本:80 MB 与 800 MB 的差别,决定了它能不能在 8 GB 的笔记本上跑;0.24 s 的计算不是瓶颈,读矩阵的 I/O 才是。
失败条件:
- 空液滴:没抓到细胞的液滴 counts 全 0,是零向量,余弦无定义;实现里通常返回 0,于是它被分到「最不相似」的类,混进结果。兜底:先按总 counts < 500 过滤。
- 批次效应:两次测序的细胞各自成团,余弦再准也救不了。兜底:先做批次校正,再算余弦。
- 各向异性:所有细胞两两余弦都在 0.8 以上,阈值彻底失效。兜底:先减掉平均表达谱(中心化)再算。
6. 常见误区
-
误区:余弦相似度高就代表两段文本意思相同。 纠正:只代表在当前 embedding 模型的几何里方向接近;模型可能被词频、领域、模板句带偏。
-
误区:余弦相似度可以比较任意两个向量,包括零向量。 纠正:零向量没有方向,分母为 0;必须先处理。
-
误区:余弦相似度总是比欧氏距离好。 纠正:当长度本身携带信息(如「置信度」「重要性」)时,欧氏距离或内积可能更合适;取决于任务与 embedding 的训练目标。
-
误区:余弦值 0.8 一定比 0.7「更相关」。 纠正:不同模型、不同数据分布的分数不可直接比较;很多 embedding 存在「各向异性」,整体余弦偏高(第 9.3 节)。
7. 概念网络
- 前置:1.3 点积 —— 余弦的分子。
- 前置:1.4 范数 —— 余弦的分母。
- 后续:1.6 正交与投影 —— 余弦为 0 即正交。
- 后续:9.3 PCA —— 主方向与各向异性。
- 关联:11.3 Attention —— attention 用未归一化点积,与此不同。
8. 通往大模型:检索、对比学习与 attention 的区别
检索(RAG):把文档和 query 分别编码成向量,归一化后用余弦/内积找 top-k。这是「双塔」结构,两个向量独立编码,最后才比较。
对比学习:训练目标常写成
温度 控制分布的尖锐程度;归一化让相似度落在稳定区间。
attention 不是余弦:attention 打分是 (Vaswani 等),没有除以范数。所以 key 的范数也会影响注意力;模型可以通过增大某些 key 的范数来「让自己更容易被注意到」。这也是为什么有些工作研究 attention 的「范数病态」。
可检验结论:若把 的所有行乘以 2,softmax 前的分数整体乘以 2,注意力分布会变得更尖锐(温度效应),但 query-key 的夹角完全没变。说明 attention 对范数敏感,而余弦不敏感。
如果这一步算错,用户会看到什么:检索系统忘了归一化,用户搜「退订」却返回 5000 字的会员总览——长文档、模板句霸榜,因为长度参与了打分。对比学习里若温度 与余弦尺度不匹配( 太小,而余弦都挤在 0.9 附近),排序几乎随机,用户看到的是「结果全像、又全不像」。
9. 练习
- 概念:为什么文本检索常用余弦而不是欧氏距离?举一个反例说明欧氏距离的偏差。
- 计算:,,求余弦; 与 的余弦。
- 计算:把 归一化,并验证归一化后它与 的点积为 1。
- 场景:两个 embedding 的余弦为 0.95,能否断定它们语义相同?还需要什么证据?
- 开放:如果所有向量都被平移到第一象限(各分量加一个大常数),余弦相似度会怎样变化?这对 embedding 有什么启示?
参考答案
- 欧氏距离受向量长度影响,长文档/高频词向量可能更远或更近,干扰语义排序;余弦只看方向。
- (同向);。
- ,点积 。
- 不能;需看模型基线分布、是否同领域、是否有反例;高余弦可能只是「都常见」。
- 所有向量方向趋同,两两余弦整体升高,区分度下降——这就是各向异性/「表示锥」问题。
10. 一页速记
- ,范围 。
- 归一化后,余弦 = 点积;欧氏距离与余弦单调对应。
- 余弦只看方向,适合语义检索;长度有信息时未必适用。
- 零向量无方向,余弦无定义。
- attention 用未归一化点积,对 key 的范数敏感。
- 物理意义 / 现实对应:看风向——只比指向、不比远近;现实里「方向」是表达谱形状,「长度」是测序深度。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、定理名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- Salton 等(1975):A Vector Space Model for Automatic Indexing。把文档和 query 表示为向量、用余弦排序,本页检索场景与「余弦只看方向」的用法都源于这个模型。Communications of the ACM 18(11)
- Mikolov 等(2013):Efficient Estimation of Word Representations in Vector Space。word2vec 让词变成可训练的低维向量,本页讨论的 embedding 归一化与检索由此成为常规操作。arXiv:1301.3781
- Vaswani 等(2017):Attention Is All You Need。缩放点积注意力的出处;本页 §8 用它对比「attention 不除以范数」与余弦的差别。arXiv:1706.03762
下一篇 → 1.6 正交与投影
随堂测 · 4 题
源文件:01-向量与几何/05-余弦相似度.md