9.3 PCA:找方差最大的方向
本节位置:模块 9 · 概率与统计 | 前置:7.3 低秩近似、9.2 多元高斯 | 预计:40 分钟
一句话:PCA 先中心化,再旋转坐标系,让第一个轴对准方差最大的方向;它既是协方差的特征分解,也是中心化数据矩阵的 SVD。
0. 场景引入
门禁闸机要在 300 ms 内回答一个问题:这张脸是不是员工本人。摄像头给出 112×112 的灰度图,展平成 12 544 维向量;人脸库有 8 万张底图,fp32 存下来是
闸机只有 512 MB 内存,而且必须离线跑。
不降维的代价算得出来:一次比对 12 544 次乘加,8 万次比对就是 次乘加,300 ms 内跑不完,4 GB 也塞不进内存。那直接对 12 544 维估协方差?那是 个数(628 MB),特征分解还要 量级,同样不可行。
机会藏在数据里:这 12 544 个像素中,大部分记录的是光照和传感器噪声,真正区分人与人的变化集中在少数几个方向上。主成分分析(principal component analysis, PCA) 就是找这几个方向的方法。
决策:降到 维再比对,还是硬扛全维?代价很具体:降错了,戴眼镜的老员工被反复拒之门外;更糟的是,陌生人被放进来。
读完你能回答的三个问题:
- 哪 个方向最保留「人与人之间的差别」?
- 降维造成的误差有多大,能不能事先算出来?
- 为什么 PCA 可能恰好丢掉「区分这两个人」的那一维?
1. 直觉
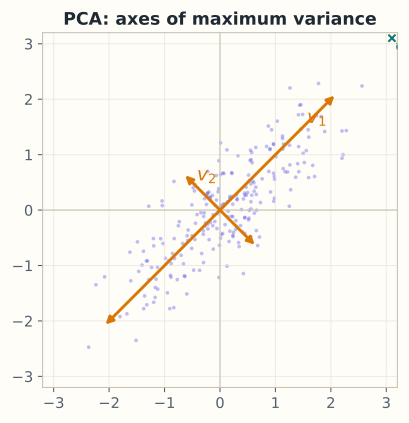
想象一团被拉长的点云。旋转坐标轴,让第一根轴沿点云最长的方向,第二根与它垂直、沿次长方向。页首的图就是旋转的结果:第一主成分指向点云最舒展的方向,第二主成分与它垂直。
- 第一主成分(first principal component):投影后方差最大的单位方向;
- 第二主成分:在与第一主成分正交的方向里方差最大的那个;
- 以此类推,最多 个,彼此正交。
投影到前 个主成分,相当于用一个 维「影子」代替点云;误差是点到这个 维平面的垂直距离平方和。
💡 一句话直觉:PCA 是「把点云转到它自己最舒展的坐标系里」,然后只保留最舒展的几根轴。
1.1 它在现实世界里对应什么
把人脸库想成像素空间里的一团点云,每一张脸是一个 12 544 维的点:
| 数学对象 | 人脸识别里的对应物 |
|---|---|
| 样本 | 一张 112×112 的灰度图,按行摊平 |
| 重心 | 8 万张图平均出来的「平均脸」——一张像所有人的模糊脸 |
| 第一主成分 | 像素一起变亮变暗的方向,通常就是整体光照 |
| 第 2、3 主成分 | 脸型宽窄、五官位置这类较大的结构变化 |
| 得分 | 这张脸的「特征坐标」,即常说的 eigenface 系数 |
| 到子空间的距离 | 这张脸「不像任何正常脸」的程度,可用于活体/异常检测 |
量级直觉(经验值):在裁剪对齐较好的人脸库上,前 100 个主成分常能解释 90% 以上的总方差。一张 112×112 的 fp32 图是 50 KB,128 维系数只要 512 B——压缩比在 100 倍量级。这也解释了为什么 1990 年代的 eigenface 方法能在当时的硬件上跑起来。
1.2 这个类比在哪里失效
第一主成分常常是光照,不是身份。它方差最大,对「这是谁」却几乎没用。方差排序不等于判别排序——这是 PCA 最容易被误用的地方。线性判别分析(LDA)之所以不同,就在于它优化的是「类间方差 / 类内方差」,而不是总方差。
线性子空间装不下姿态。头转 30° 以上,图像点已经离开这个线性子空间;PCA 重建会「糊」,因为人脸在图像空间的流形是弯的,不是一片平面。
没对齐就没有意义。人脸没做关键点对齐时,前几个主成分会被「整体平移」占据,真正的结构被埋在后面。所以工程上总是先对齐、再做 PCA,顺序不能反。
2. 定义
2.1 中心化
设数据矩阵 ,每行一个样本。样本均值 ,中心化(centering) 后 ,每列均值为 0。
2.2 协方差与方差最大化
本节用除以 的总体协方差 。
约定:9.1 的样本协方差用 ,本节用 ;两者只差常数 ,特征向量与解释方差比不变,但本节的 与 配套使用。第一主成分是
就是数据在 方向上的投影方差。
2.3 特征分解形式
对称半正定,特征分解 ,其中 、。 的列是主成分方向, 是沿该方向的方差。主成分得分(scores) 满足 ,即各列不相关。
2.4 SVD 形式
对中心化矩阵做瘦 SVD:。则 ,所以
两种做法给出同一组方向;SVD 不必显式构造 的 ,在 时更省。
2.5 解释方差比
第 个主成分的解释方差比(explained variance ratio) 为 。前 个的累计比 。因为 是总方差,这些比值加起来为 1。
2.6 投影与重建
取前 个主成分 ,则 ,重建 。矩阵形式的重建是 ; 是到前 个主成分子空间的正交投影矩阵(orthogonal projection matrix)(第 1.6 节)。
3. 为什么这样定义
为什么必须中心化? 不中心化时, 是二阶矩而不是协方差,第一主成分会偏向均值方向。极端例子:所有点都在 附近,第一主成分几乎就是均值方向,投影后看起来「方差很大」,其实只是整体偏移。
为什么特征向量就是最优方向? 这是带约束的优化。用拉格朗日乘子(第 8.8 节):,对 求导得 ,即 。代回目标,值正好是 。
为什么主成分彼此正交? 对称,由谱定理(第 6.4 节)存在一组标准正交特征向量。正交意味着得分之间协方差为 0: 是对角阵。
为什么 SVD 与特征分解等价? 因为 ,而 给出 。右奇异向量就是 的特征向量,奇异值平方除以 就是特征值。
3.1 反事实:不中心化、或按逐维方差选特征,会坏在哪
反事实 A:跳过中心化。
四个点 ,均值是 。中心化后它们变成 ,协方差是 :两个方向方差都是 1,主成分方向根本不唯一,也没有哪个方向「更舒展」。
不中心化,直接算二阶矩 :
迹 、行列式 ,所以特征值是 与 。第一特征向量满足 ,即 ——正好是均值方向。解释方差比 ,漂亮得可疑。
它捕捉到的是什么?「所有样本都在图像中央、像素值都在 100 上下」这个常量偏移。这个方向方差巨大,却和「这是谁」无关。中心化就是把这一层公共底色减掉。
反事实 B:用逐维方差排序代替协方差。
取中心化后的四个点 。两列各自的方差都是 1,于是「按方差选前 2 个像素」会把两列都留下——一维都没压掉。
但协方差矩阵是
特征值 与 :数据只沿一条 直线变化,另一个方向完全没有波动。保留 1 维,重建误差就是 0。
逐维方差永远发现不了「两列完全重复」这种冗余,因为每一列单独看都「信息量满满」。要看见冗余,必须看协方差;这也正是 PCA 与「挑几个方差大的特征」的本质区别。
4. 性质与推导
4.1 第一主成分的拉格朗日推导
最大化 受约束 。拉格朗日条件 ,左乘 得 。所以所有单位方向中,投影方差的最大值就是最大特征值 ,取得它的方向是 。
4.2 总方差与重建误差
投影到前 维保留方差 ,丢掉 。对每个样本,重建误差是到子空间的距离平方;对所有样本求和:
这也说明 PCA 截断与 7.3 的截断 SVD 是同一件事,只是作用在中心化数据上。
4.3 解释方差比与尺度
是相对总方差的比例,不是相对任务信息的比例。若数据里 99% 的方差是噪声,前几个主成分也可能解释 99%,却对分类没有帮助;选 要结合下游指标。另外,PCA 对每个坐标的单位敏感:身高用厘米、体重用千克时,协方差会被大单位主导。若各维单位不可比,通常先标准化再 PCA,这等价于对相关系数矩阵做特征分解。
5. 例子
5.1 手算:四个点的 PCA
数据(已中心化):
特征值 (方向 )、(方向 )。解释方差比 与 。
取 ,样本 的得分
残差 ,平方长度 。四个点对称,总误差 。
核对: ✓;总方差 ✓;相对误差 ✓。SVD 侧: 的奇异值为 与 ,、 ✓。
5.2 场景:4096 维激活降到 2 维
个 token、。取前两个主成分得到 的坐标,可以散点图。若前两个特征值占 35%,这张图只保住三分之一的总方差;它可能显示主要结构,也可能把细微但任务相关的结构压扁。看图前先报解释方差比,是负责任的做法。
5.3 场景闭环:8 万张底图、512 MB、300 ms
输入:8 万张 灰度底图,展平成 12 544 维。离线在全部底图上中心化后做 PCA,取 个主方向,累计解释方差 95%。
计算:主方向矩阵 ,fp32 占 MB;底图坐标库 MB。查询图投影一次是 次乘加(约 3.2 MFLOP);与 8 万张底图逐一比距离是 次乘加(约 20 MFLOP),单核毫秒级。离线投影 8 万张约 FLOP,可放在夜间批处理。
输出:最近邻的欧氏距离 。若 且次近邻距离明显更大,判为本人;否则拒绝。阈值 由误拒率(FRR)与误受率(FAR)的业务取舍决定。
成本:常驻内存约 47 MB,加上原图缓存仍远低于 512 MB;在线算力 20 MFLOP,300 ms 预算的大头其实在人脸检测与对齐。真正的成本是底图更新:新增 1 万张就要重算均值和主方向,否则坐标库与基底不一致。
失败条件:
- PCA 不监督「身份」:方差最大的方向可能是光照、姿态或摄像头差异,不是「区分这两张脸」的方向。兜底:改用有监督的度量学习(如对比损失),或保留更多维。
- 侧脸与遮挡:训练底图多为正脸,侧脸在主子空间里的重建误差大,距离天然偏远。兜底:按姿态分桶,每桶一套基底与阈值。
- 阈值漂移:换摄像头、换季节光照, 的分布整体平移。兜底:用当天的通过/拒绝日志在线校准阈值,而不是写死一个数。
6. 常见误区
- 误区:PCA 就是对 做 SVD。纠正:必须先中心化,对 做 SVD;直接对 做 SVD,第一方向会被均值拉偏。
- 误区:特征值就是「重要性分数」,可以和原始方差直接比。纠正:特征值是沿该方向的方差,单位是原单位的平方;跨数据集比较要用解释方差比。
- 误区:PCA 之前一定要标准化。纠正:同单位且想保留「谁方差大谁重要」时不该标准化;单位不可比时才标准化,两种选择结果不同。
- 误区:解释方差比高就说明降维没损失。纠正:它只说明相对总方差损失小;被丢的低方差方向若承载类别信息,分类性能仍会下降。
7. 概念网络
- 前置:9.1 概率与随机变量 —— 协方差矩阵的定义与半正定性。
- 前置:9.2 多元高斯 —— 高斯等高线的轴就是 PCA 方向。
- 前置:7.3 低秩近似 —— 截断 SVD 的最优性,PCA 是它的中心化版本。
- 前置:6.4 对称矩阵与谱定理 —— 正交特征基的存在性。
- 后续:9.4 白化 —— 在 PCA 之后再缩放每个方向。
- 关联:8.8 拉格朗日乘子 —— 方差最大化的推导。
8. 通往大模型:表征几何与预算
出现位置:激活可视化、表征相似性分析、embedding 压缩、KV Cache 的低秩近似、LoRA 子空间分析,以及「这层到底用了几维」的诊断。
形状:,中心化后做 SVD,,得分 。 时投影矩阵有 个参数(fp32 约 2 MiB);协方差矩阵有 个元素(约 64 MiB)。
为什么需要: 时显式协方差是 存储、 特征分解; 时它还奇异。直接对 做 SVD 的代价是 ,并且可以只算前 个奇异值/向量(截断或随机化 SVD),把成本压到与 成正比。
可检验结论:解释方差比等于 ;重建的相对 Frobenius 误差是 。若谱衰减很慢( 只有 20%),说明这层激活本质上是高维的,PCA 降维会明显损伤信息。
import numpy as np
rng = np.random.default_rng(0)
X = rng.normal(size=(8192, 4096))           # [N, D]
Xc = X - X.mean(axis=0, keepdims=True)      # 中心化
U, s, Vt = np.linalg.svd(Xc, full_matrices=False)
ratio = s**2 / (s**2).sum()                 # 解释方差比
Z = Xc @ Vt[:128].T                         # [N, 128] 前 128 个得分
print(ratio[:3], ratio[:128].sum()) # 前 128 个累计比与低秩近似的联系:PCA 的 正是 的秩 最优近似(Eckart–Young)。所以「PCA 降维」与「低秩压缩」在数学上是同一个操作,只是一个强调坐标,一个强调存储。
9. 练习
- 概念:PCA 为什么必须先中心化?不中心化时第一主成分会变成什么?
- 概念:两个特征值相等(都为 3)说明什么?此时主成分方向唯一吗?
- 计算:数据 ,求协方差矩阵、特征值、解释方差比;取 求 的得分、重建与总重建误差。
- 计算:中心化矩阵 有 10 个样本,奇异值为 。求协方差特征值与解释方差比。
- 开放:用 PCA 把 4096 维降到 64 维,累计解释方差 95%。能否据此断定「64 维足够用于分类」?还需要什么实验?
参考答案
- 不中心化时,协方差被二阶矩 替代,第一主成分偏向均值方向,整体偏移被误当成方差;极端情况下第一主成分几乎等于 方向。
- 该子空间内所有方向方差相同,主成分方向不唯一,任意正交基都可以;数值上特征向量可能不稳定,但投影子空间确定。
- ,特征值 ,比值 ,方向 、。 得分 ,重建 ,残差 平方长度 2;四个点总误差 。
- ;总方差 4.0,比值 。
- 不能。95% 是相对总方差,不保证剩下的 5% 与类别无关;需要看降维前后的分类/检索指标、被丢方向的类别可分性,以及交叉验证。
10. 一页速记
- PCA = 中心化 + 找 最大化 ,解为 。
- 等价地:对 做 SVD,,方向是右奇异向量。
- 解释方差比 ,累计比用来选 。
- 重建 ,误差平方和 。
- 不中心化会偏;单位不可比时先标准化;方差大不等于任务重要。
- 物理意义 / 现实对应:PCA 找的是数据云团最长的几根轴——它压缩的是「变化」,不是「意义」;变化最大的方向不一定是最能区分人的方向。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、定理名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- 皮尔逊(Karl Pearson, 1901):On Lines and Planes of Closest Fit to Systems of Points in Space。把「用低维线性流形拟合点云」化为最小二乘问题,这是 PCA 的雏形;本页的「找方差最大的方向」是它的主轴版本。Taylor & Francis(DOI)
- 霍特林(Harold Hotelling, 1933):Analysis of a Complex of Statistical Variables into Principal Components。把主轴法推广到一般随机变量并给出 principal components 这一名称,本页的得分矩阵 就是它的矩阵写法。APA PsycNet(DOI)
- 埃卡特与杨(Carl Eckart & Gale Young, 1936):The Approximation of One Matrix by Another of Lower Rank。证明秩 截断 SVD 是最优低秩近似,本页重建误差 的最优性由它保证。Springer(DOI)
- Jolliffe(Ian T. Jolliffe, 2002):Principal Component Analysis。PCA 的权威专著,本页关于中心化、标准化与选 的实践建议在其中有系统讨论。Springer(DOI)
下一篇 → 9.4 白化
随堂测 · 5 题
源文件:09-概率与统计/03-PCA.md