3.2 矩阵乘向量:线性映射
本节位置:模块 3 · 矩阵与线性映射 | 前置:3.1 | 预计:35 分钟
一句话: 同时是「列向量的加权和」「一排点积」和「对空间做一次变换」——三种算法,同一个结果。
0. 场景引入
周五下午,协作机器人调试现场。一台 6 轴机械臂要在 2 毫秒的控制周期里(500 Hz)走一条直线:末端以 0.25 m/s 沿桌面匀速前推,焊一条 300 mm 的缝。
控制器每一拍只做一件事:给定末端速度 (3 个线速度 + 3 个角速度),求 6 个关节的速度 ,满足
是 的雅可比矩阵(Jacobian),随姿态 变化,每一拍都要重算。
算错的代价很直接:缝偏 1 mm 就是废件。更糟的是某个关节的速度超过额定 180°/s(约 3.14 rad/s),驱动器过流保护直接抱闸——机械臂停在半空,工件和夹具一起报废。
这条缝要走 s,也就是 600 个控制周期。每一拍都要把新的 乘一次、解一次,中间任何一拍算错,后面的轨迹就全歪了。
问题: 为什么能算出一个速度,而不是六个互不相干的数?当 接近不可逆时, 为什么会突然爆掉?
读完本节,你应该能回答三件事:
- 三种算法(列组合、行点积、变换)在机器人上分别对应什么物理量;
- 为什么 的第 列就是「只动第 个关节、其余锁死」时末端的速度;
- 变大时,为什么解出的关节速度会失控,工程上怎么兜底。
1. 直觉
1.1 三种算,同一件事
一个 2 维向量 经过矩阵
之后变成什么?你可以按三种方式算:
- 把 的两列按 加权相加;
- 用 的每一行和 做点积;
- 把 看成对平面的一次拉伸,看 这个点被搬到哪里。
列组合:把输入当配方。 有两列 、。输入 说的是:取 1 份第一列、2 份第二列。
这是「鸡尾酒配方」视角:输入是各原料的用量,矩阵的列是原料,输出是调好的酒。
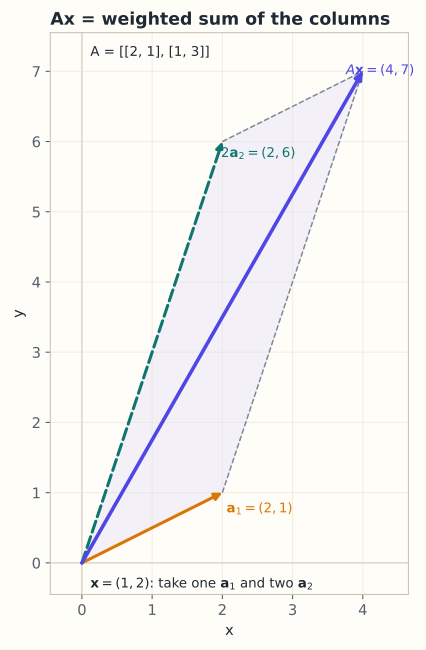
图: 的两列 、;输入 表示取 1 份 、2 份 ,平行四边形的对角线就是 。
行点积:把矩阵当一组测量。 的第一行 与 做点积得 ;第二行 得 。输出分量就是每个行向量与输入的相似度/投影。
变换:把矩阵当动作。 把基向量 送到 ,把 送到 。单位正方形因此被拉成一个平行四边形, 跟着一起被搬走。
💡 一句话直觉:列组合是「怎么算」,行点积是「每个输出看什么」,变换是「几何上发生了什么」。
类比边界:只有当矩阵是方阵且可逆时,「变换」才是一个可来回搬运的坐标变换; 时它是升维/降维,信息一定丢失或冗余。
1.2 现实对应:一组传动比
把 的第 列单独拎出来看。若只有第 个关节在动(,其余为 0),则 。也就是说:
的第 列 = 只动第 个关节时,末端的速度方向;它的长度就是这个关节的「力臂」。
以连杆总长 0.4 m 的机械臂为例,第 6 个关节(腕部)转 1 rad/s,末端走 0.4 m/s。所以 的第 6 列范数约 0.4,单位是「米每弧度」。
这就是列组合视角在机器人上的样子:末端速度是 6 个关节各自贡献的线性叠加——每个关节按自己的角速度贡献一列,加起来就是末端的总速度。 里的 在机器人上就是 。
这个类比在哪里失效:传动比是常数,雅可比不是。 依赖当前姿态 ,机械臂一动 就变。把 当固定矩阵用(比如整条轨迹只算一次),等于假设机械臂没动——这是仿真与实机对不上的最常见原因。
1.3 量级直觉
关节速度的额定值是 180°/s,即 3.14 rad/s。连杆 0.4 m 时,末端速度上限约 m/s——比焊接要的 0.25 m/s 快 5 倍,看起来余量充足。
余量是被 吃掉的。末端要 0.25 m/s,若某个方向上 ,最坏方向上的关节速度就要 rad/s,直接超限。线性映射的增益不是均匀的:沿不同方向,它差 倍。
2. 定义
2.1 矩阵乘向量(matrix-vector product)
设 ,,则 ,其第 个分量为
逐项读法:输出的第 个分量,是 第 行与 的点积。形状:。
2.2 列组合形式
把 按列分块 ,则
这是与 §2.1 等价的写法,只是把「按行求和」换成了「按列加权」。
把 读成「列的组合」,也是 Trefethen & Bau 第一讲的开篇算法。
2.3 线性性
映射 满足:对任意 和标量 ,
满足这条性质的映射叫线性映射(linear map)。注意 是它的必要条件:原点必须不动。
3. 为什么这样定义
为什么不逐元素乘?因为逐元素乘 要求形状相同,而且它不满足「先组合再变换 = 先变换再组合」。线性映射的价值恰恰在于这条可交换性:你可以先把输入拆成基向量的组合,分别看它们去哪,再加起来。
为什么行点积和列组合必须一致?因为矩阵只有一份数字。行定义给出计算顺序,列定义给出几何含义;两者一致,才能让「代数计算」和「空间变换」互相翻译。
为什么原点必须不动?如果 ,映射就是 仿射(affine) 的。线性层里的偏置 正是干这个的: 是仿射,不是严格线性。把 增广成 、 增广一列 ,就又能写成线性形式。
3.1 反事实:如果 定义成「第 个输出只看第 个输入」
逐元素乘 要求形状相同,所以对 的矩阵和 2 维向量来说,形状上说得通。把它明确写成:第 个输出取 。
取一个 90° 姿态下的平面二连杆,只保留两个关节对末端线速度的贡献:
第 1 列 :动第 1 关节,末端沿 走;第 2 列 :动第 2 关节,末端沿 走。两个力臂都是 0.4 m。
让第 1 个关节以 1 rad/s 转动,第 2 个锁死:。
正确算法(行点积):
末端沿 走 0.4 m/s,符合「力臂 × 角速度」。
逐元素算法:
末端速度为零。也就是说:电机在转、关节在动、连杆扫过 0.4 m 的弧,末端却「没动」。
一眼可见的荒谬:末端固定在连杆上,关节一动它必动(除非力臂为 0)。逐元素算法做了两件错事:把「第 2 个关节锁死」误读成「整行归零」;同时丢掉了 对第 1 个输出的贡献——那正是「第 2 个关节也在推着末端往 走」这件事。
结论: 的每个输出分量必须把所有输入维度都看一遍(行点积),才能表达「多个关节共同决定一个方向的速度」。任何「第 个输出只看第 个输入」的定义,都会把耦合整个删掉。
4. 性质与推导
4.1 两种算法为什么相等
把 的第 个分量写出来:
第一步是向量线性组合按分量展开,第二步用「第 列的第 个分量就是 」。列组合与行点积不是两个定义,而是同一个求和的两种分组方式。
4.2 线性性的推导
逐分量相等,所以向量相等。
4.3 基本性质
| 性质 | 式子 | 说明 |
|---|---|---|
| 零矩阵 | 是所有元素为 0 的矩阵 | |
| 单位阵 | 对角为 1、其余为 0 | |
| 加法分配 | 形状必须相同 | |
| 数乘 | 先缩放矩阵等于先缩放输出 | |
| 原点不动 | 线性的必要条件 |
单位阵的列是标准基:,所以 。
5. 例子
5.1 手算:三种算法算同一个
取 ,。
列组合:
行点积:第一行 ;第二行 。
变换:,。单位正方形被拉成顶点依次为 的平行四边形; 被送到 。
验证线性性:取 ,则 ,;而 ,一致。
5.2 场景:带偏置的线性层
线性层实际算的是 。取 、、,则 ,加偏置得 。因为 时 ,这个映射是仿射的;偏置让输出整体平移。
5.3 场景闭环:500 Hz 的速度环
输入:(fp64,288 字节),末端目标速度 (沿 匀速下降 0.25 m/s),控制周期 ms。
计算:每一拍解 。用 LU:分解约 FLOPs,回代 FLOPs,合计 216 FLOPs。若 在 6 拍内不变,分解可以复用,每拍只花 72 FLOPs。
输出:6 个关节速度指令,先过一道限幅 rad/s。通过才下发;任一关节超限,就按比例整体缩放(保方向、降速度),并上报「接近奇异位形」。
成本:算力完全不紧张—— FLOP/s,一块几十 MHz 的 MCU 都绰绰有余;内存也只是 36 个数。真正的成本在重算 本身:6 个关节角要做十几次三角函数、几十次乘法,比解方程贵一个数量级。所以瓶颈从来不是「算不动 」,而是「来不及更新 」。
失败条件与兜底:
- 奇异位形:手臂完全伸直时,末端沿手臂方向无法产生速度, 某列退化,,,解出的 可以是 rad/s。兜底:阻尼最小二乘,把 换成 , 随 增大(第 3.4 节的伪逆,第 4.5 节的一般形式)。代价是末端速度略小于目标——宁可慢,不要抱闸。
- 编码器噪声:关节角读数上 rad 的噪声经 放大 倍。 时,速度指令上就有 rad/s 的抖动,表现为末端高频震颤。兜底:对 低通滤波,但会引入相位滞后,直线走成轻微弧线。
- 过期:若为省算力每 10 拍才更新一次 ,中间 20 ms 里机械臂已经转了几度, 与实际姿态不符,直线误差到毫米级。兜底:让 的更新与插补周期对齐,宁可多算三角函数。
6. 常见误区
-
误区: 是 的每个元素乘 的对应元素。 纠正:逐元素乘是 Hadamard 积 ,要求同形状; 是行点积/列组合,输出维度由 的行数决定。
-
误区:行向量也能直接写 。 纠正:本书约定 是列向量。若在代码里拿到行向量
x,应写x @ A.T,本质仍是 。 -
误区: 是线性映射。 纠正:只要 就是仿射映射,原点被搬到了 。深度学习里习惯把整层叫「线性层」,是工程叫法。
7. 概念网络
- 前置:3.1 矩阵的四种身份 —— 矩阵的列与映射方向。
- 前置:1.2 加法、数乘与线性组合 —— 列组合就是线性组合。
- 前置:1.3 点积 —— 行视角的每一行是一次点积。
- 后续:3.3 矩阵乘法 —— 把两个 串起来。
- 后续:3.4 逆矩阵与可逆性 —— 已知 反求 。
- 后续:3.7 四个基本子空间 —— 哪些 被送到零。
- 关联:11.2 线性层 —— 大模型里的 。
8. 通往大模型:线性层就是一次矩阵乘向量
出现位置:Transformer 的每个线性层、QKV 投影、FFN 的第一层与第二层、输出 logits 层,本质都是对每个 token 做一次 。
形状:隐藏状态 ,权重 。代码写作 X @ W.T + b,逐 token 展开就是 次矩阵乘向量;这一层在 BLAS 里叫 GEMV,即第 2 层矩阵–向量例程(Golub & Van Loan)。QKV 投影常把三个矩阵拼成 ,一次算出 (三组投影的原始定义见 Vaswani 等,2017);当 时输出维是 12288。
为什么需要:线性层是模型里把特征维度线性组合起来的主要运算:attention 混合的是不同 token 的信息,LayerNorm 做的是逐 token 的归一化,它们都不提供可学习的跨维线性权重。没有 ,每个特征维度永远独立,模型无法组合特征。
可检验结论:对 、、 的 QKV 投影,FLOPs 约为 ,即约 412 GFLOP。把 翻倍,FLOPs 变为 4 倍——这就是大模型算力随宽度平方增长的来源。
如果这一步算错,用户会看到什么现象: 少算一项,最典型的症状是「某些东西永远不变」——某个注意力头对某些 token 的分数恒为 0,模型对这些词完全无感,表现为系统性忽略某类实体。把输出维度方向搞反(x @ W 写成本该 x @ W.T),如果形状恰好还能对上,模型会照常训练、loss 照常下降,只是学到的东西整体「错位」,最终效果比随机初始化好不了多少。符号错(少一个负号)则常表现为训练早期 loss 突然变 NaN 或爆炸——因为残差流被反复放大而不是相互抵消。
9. 练习
- 概念:用列组合语言解释「 的第 列等于 」。
- 计算:,,分别用列组合与行点积求 。
- 计算:接上题,求 ,并验证它等于 ,其中 。
- 场景:,,,求 ,并说明为什么它不是线性映射。
- 开放:如果线性层去掉偏置,表达能力会损失什么?在什么情况下偏置是冗余的?
参考答案
- 表示「只取第 份原料」,列组合 ,其余系数为 0,所以结果就是第 列。
- 列组合:;行点积:,。
- ;。,,一致。
- ,加偏置得 。 时输出 ,原点被平移,故不是线性映射。
- 偏置让每个输出维度可以整体平移,相当于给决策边界/激活阈值一个可学习的起点;如果数据已经中心化、或下一层有 LayerNorm,偏置的作用会大幅减弱,甚至可省略。
10. 一页速记
- ;形状 。
- 物理意义 / 现实对应: 是「每个输入的贡献按列加权求和」;在机械臂上就是各关节速度按各自力臂叠加成末端速度, 的列就是力臂。
- 列组合:;行点积:每个输出是一次点积。
- 线性:,且 。
- ,。
- 线性层实际是仿射:,偏置让原点平移。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、定理名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- Golub & Van Loan(2013):Matrix Computations(第 4 版)。把 定为 BLAS 第 2 层的 GEMV,并给出 FLOPs 与访存计数,本页的行点积/列组合在实现里就是它。Johns Hopkins University Press
- Trefethen & Bau(1997):Numerical Linear Algebra。第一讲就把 解释成列向量的线性组合,本页「列组合」视角的标准出处。SIAM
- Vaswani 等(2017):Attention Is All You Need。给出 的线性层与 三组投影,本页 §8 的形状推导直接沿用。arXiv:1706.03762
下一篇 → 3.3 矩阵乘法:四种视角
随堂测 · 4 题
源文件:03-矩阵与线性映射/02-矩阵乘向量.md