8.6 凸性与优化
本节位置:模块 8 · 微积分与优化 | 前置:6.5 二次型、8.4 Hessian | 预计:35 分钟
一句话:凸函数像一只碗,没有第二个坑;在它上面,任何局部最优都是全局最优。
0. 场景引入
室外 C,一个 480 万 m² 的城区供热系统总热负荷 1200 MW,由 3 台热源分担:两台热电联产机组和一台燃气调峰锅炉。每台的燃料成本都随出力加速上升(机组越接近满负荷,单位供热耗煤越高):
调度员每 15 分钟要决定一次 怎么分。按容量均分(每台 400 MW),总成本是 96 万元/h;按等边际成本分配,最优点是 MW,总成本 94 万元/h。每小时省 2 万元,采暖季 120 天、2880 小时,就是 5760 万元。
但调度员必须回答一个更根本的问题:凭什么说 就是全局最优? 如果成本曲线有好几个坑,等边际成本只会把你带到其中一个,而你可能永远不知道另一个坑更深。
代价:如果成本函数不是凸的(比如汽轮机进汽阀逐个开启造成的「阀点效应」),等边际成本法会稳定地收敛到一个局部最优,一个采暖季多烧的钱足以覆盖一次控制系统改造。
把现场抽象掉:凸性就是判断「什么时候可以相信局部下降」的标尺,也是理解正则化、对偶、KL 约束的基础。经典模型(logistic 回归、SVM)的损失是凸的,大模型的不是(§8)。
读完本节,你应该能回答三件事:
- 凸性的弦定义、一阶判据、二阶判据分别在说什么,为什么等价?
- 为什么「凸 + 驻点」就等于全局最优?
- 什么样的工程现实会让凸性失效,失效后该怎么办?
1. 直觉
1.1 凸集:没有凹坑
一个集合是凸的,如果集合里任意两点的连线仍完全在集合里。圆盘、半空间、 都是凸的;月牙、环形不是。
1.2 凸函数:弦在图像上方
在函数图像上任取两点连一条弦,如果图像总在弦的下方,函数就是凸的。
等价地:图像上每一点的切线(或切平面)都在图像下方。碗满足这一点,帽子不满足。
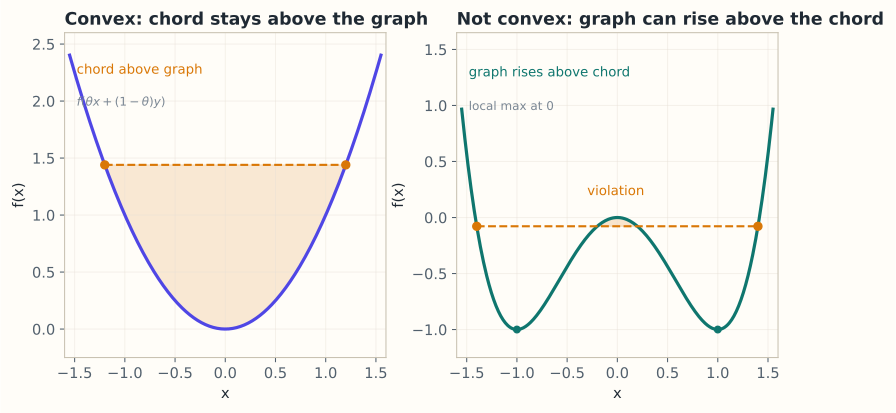
图:左图 上任意两点连弦,图像都在弦的下方;右图 在 附近是局部最高点,弦会落到图像下方,违反凸性定义。
💡 一句话直觉:凸函数 = 一只碗;你站在碗里任何位置,往下走都能到同一个底。
类比边界:碗可能很扁(强凸性弱)、可能没有唯一的底(平坦区域),也可能不可微(有尖角)。凸性只保证「没有第二个坑」,不保证「好优化」——条件数仍然重要。
1.3 它在现实世界里对应什么
在供热调度里,凸性不是抽象性质,它是**「成本曲线越走越陡」的另一种说法**:
| 数学对象 | 供热系统里的对应物 | 单位 |
|---|---|---|
| 第 台热源的出力 | MW | |
| 燃料成本 | 万元/h | |
| 边际成本:多发 1 MW 要多花多少钱 | 万元/(h·MW) | |
| 边际成本随出力上升的速度 | 万元/(h·MW²) |
凸性的物理内容是:边际成本递增。这里 ,意味着每多供 1 MW,下一兆瓦都比上一兆瓦更贵——机组越接近满负荷,效率越低。
量级直觉: 在几百 MW 量级, 在几十万元/h 量级,边际成本 在 万元/(h·MW) 上下。三台的边际成本曲线斜率都是 ,所以「等边际」的解很稳:任何一台多出 10 MW,它的边际成本就升 ,立刻被其它机组比下去。
边界:凸性保证「等边际成本 = 全局最优」,但它不保证解唯一(线性成本时是一整段平台)、不保证可微(分段报价的电力市场里成本是折线,只能用次梯度)、也不保证可行域是凸的(机组有最小技术出力,禁止在 0–30% 区间运行,可行域被挖掉一段)。
这个类比在哪里失效:这里的「碗」假设三台机组之间没有耦合。真实管网有水力耦合、有供热半径带来的管损, 不再是三个独立函数之和,凸性要在更大的变量空间里重新验证。
2. 定义
2.1 凸集
集合 是凸集(convex set),若对任意 和 ,都有 。
2.2 凸函数
函数 是凸函数(convex function),若其定义域是凸集,且对任意 和 ,有 。
若严格不等式对 成立,称严格凸(strictly convex)。
2.3 两个判据
一阶判据( 可微):。读法:切平面永远在函数下方。
二阶判据( 二阶可微): 对所有 成立。读法:每个点的 Hessian 都半正定,即每个方向都不向下弯。
3. 为什么这样定义
凸性的价值在于把「局部信息」升级成「全局结论」:
- 驻点 全局极小(不需要检查别处);
- 局部下降 一定能到全局最优;
- 对偶问题没有「对偶间隙」(强对偶在约束品性下成立)。
如果只要求「局部最优」,那么任何驻点都合格,优化器无法给你保证。凸性是用结构换保证:牺牲模型表达能力,换取可证明的最优性。
这也解释了为什么凸优化(convex optimization)在深度学习时代仍然重要:很多子问题(最后一层分类头、正则化项、KL 约束下的策略优化)是凸的,可以在非凸的大框架里提供可靠的局部解。
3.1 反事实:把凸性定义换成「 正定」会坏在哪
方案 A:定义成 (严格正定)。 取 。它在 处 ,按这个定义会被判成非凸。但用弦定义检查:、、中点 ,而弦在中点的值是 , 成立;对任意 都成立, 是严格凸的。把「正定」当定义,会把一整类严格凸函数判成非凸。
方案 B:定义成 处处成立。 取 。它确实是凸的(弦永远在图像上方),但在 处根本没有二阶导数。二阶判据在这里不是「判错」,而是「用不了」。 凸性的定义必须建立在弦不等式上,二阶判据只是可微情形下的一个等价刻画。
方案 C:在工程里忽略凸性,直接对成本曲线做等边际分配。 加上阀点效应后,某台机组的微增成本曲线会出现一段凹():进汽阀刚开启时效率突然跳升,多发一点反而更便宜。取一个能手算的玩具:
,在 时为负。用弦定义检验 、:,,中点 处
图像跑到了弦的上方,凸性被违反。 后果不是「收敛慢一点」:等边际成本法会把负荷推进这段凹区,然后停在一个局部最优;真正的全局最优可能在凹区另一端,成本差可以到百分之几——在 1200 MW、2880 小时的尺度上,就是每年几百万元。
工程上的兜底不是「假装它凸」,而是:分段枚举(阀点组合是有限的)、动态规划,或把非凸段线性化后做混合整数规划。
4. 性质与推导
4.1 局部最优 = 全局最优
设 凸, 是局部最优。反设存在 使 。
令 ,。由凸性,。当 足够小时, 落在 的任意小邻域内,这与「局部最优」矛盾。所以不存在更低的点。
4.2 二阶判据的直觉
沿方向 ,一元函数 的二阶导是 。凸性等价于每个方向都是一元凸函数,即 对所有 。这正是 的定义。
4.3 保凸运算
- 非负加权和:()仍凸;
- 仿射复合: 仍凸;
- 逐点最大: 仍凸;
- 凸且单调增的外层复合: 仍凸( 凸且单调增)。
这些规则让你不用每次回到定义,就能判断一个损失是不是凸的。
4.4 强凸性
若 (),称 是 -强凸。此时最优解唯一,且 。读法:离最优越远,函数值至少以二次速率变高。强凸 + 光滑()是梯度下降线性收敛的标准假设。
5. 例子
5.1 手算:用定义验证
取 ,,:,成立。二阶判据:,处处成立,所以 严格凸。
5.2 手算: 不是凸函数
取 ,,:
,违反凸性定义。
用 Hessian 也能看出来:,特征值 和 ,不定。沿 方向向上弯,沿 方向向下弯。
对比 :,特征值 ,正定,所以是凸函数,原点是全局极小。
5.3 场景:logistic 损失是凸的
二阶导恒非负,所以 凸。 时 ,; 时 ,。
对 个样本求和、再加 L2 正则,仍然是凸的。但把 换成神经网络的输出 后, 非凸,整体就不再凸——凸性被网络复合破坏了。
5.4 场景闭环:3 台机组、1200 MW、每 15 分钟一次
输入:3 台机组的成本系数(6 个数)、总负荷 1200 MW、每天 96 个调度时段;机组容量上限 MW,都满足。
计算:等边际条件 给出
三式相加令等于 1200:
代回得 。凸性给的红利是:你不需要搜索,只需要解一个单调方程。
输出: MW 的分配指令,以及每台的边际成本(用于判断「下一兆瓦该给谁」)。
成本:二分法找 约 40 步,每步 3 次乘加,总共约 FLOP,微秒级;若改成 1 MW 精度的网格搜索,单纯形上有 个组合,慢近 2 万倍。内存:只有 6 个系数,没有矩阵。
失败条件与兜底:
- 可行域非凸:机组最小技术出力 30%, 区间禁止运行,等边际解可能落进禁区。兜底:按禁区分段,段内做等边际,最后比较各段成本。
- 成本参数漂移:煤质、气温、机组状态每天都在变, 一周就能漂 5%。兜底:每 15 分钟用实测煤耗重估 ,并保留 3% 的成本裕度。
- 阀点效应: 变负,等边际法失效。兜底:按 §3.1 的分段枚举,或在阀点附近做扰动测试(左右各偏 5 MW,看成本是否下降)。
6. 常见误区
-
误区:凸函数一定可微。 纠正:、 都凸但不可微。此时用次梯度(subgradient),优化理论仍然成立。
-
误区:凸函数一定是二次函数。 纠正:、、、 都凸。二次型只是最容易分析的一类。
-
误区:非凸就意味着无法训练。 纠正:深度学习非凸但实践有效。过参数化会让很多局部极小接近全局;初始化、动量、批噪声都在帮助「逃出」坏区域。凸性给出的是保证,不是必要条件。
-
误区:凸函数上梯度为零的点一定是全局最小。 纠正:在定义域内部是的;若有约束,还要满足可行性。凸性 + 驻点 + 可行,才是全局最优。
7. 概念网络
- 前置:6.5 二次型 —— 凸当且仅当 。
- 前置:8.4 Hessian —— 二阶判据用 。
- 后续:8.7 梯度下降与牛顿法 —— 强凸 + 光滑给出收敛速率。
- 后续:8.8 拉格朗日乘子 —— 凸问题 + 约束品性 ⇒ 强对偶。
- 关联:8.5 矩阵求导 —— 判断凸性要算 Hessian。
8. 通往大模型:LLM 损失不是凸的,但局部是
出现位置:语言模型的训练损失
为什么非凸: 含多层线性映射、注意力、LayerNorm 和 ReLU/GELU,复合后 Hessian 不定;嵌入表与输出层还互相耦合。因此「局部最优 = 全局最优」不成立,Adam 也没有全局收敛保证。
但局部是凸的:固定隐藏状态 ,只训练最后的分类头 ,则交叉熵 关于 logits 是凸的(log-sum-exp 凸 + 线性项)。所以 linear probing、最后一层微调这类子问题有全局最优保证。同理,KL 正则项 关于 是凸的,这让 8.8 节的约束优化有良好结构。
可检验结论:把一个已训练模型的最后一行权重单独拿出来,用固定特征做带 L2 正则的逻辑回归,损失曲面是凸的——从不同初始化出发,最终训练损失应几乎相同(差异只来自数值误差)。而端到端微调同一模型,不同种子的最终损失会明显不同。
如果凸性判断错了,训练时看到什么:误以为整体凸、于是只跑一个种子并期待可复现,结果换种子得到明显不同的最终 loss;或者反过来,因为「非凸」就放弃调参,而实际上最后一层(固定特征上的逻辑回归)是凸的——如果它换初始化后 loss 不一致,问题在数据或数值,不在初始化。
9. 练习
- 概念:凸函数的「一阶判据」和「二阶判据」分别在说什么?为什么它们等价?
- 计算:用定义验证 在 时满足凸性不等式。
- 计算:判断 是否凸,求 Hessian 特征值。
- 计算:,求 与 (保留三位小数),说明为什么 。
- 开放:既然 LLM 损失非凸,为什么「最后一层是凸的」这个事实仍然有用?举一个实际场景。
参考答案
- 一阶:切平面在图像下方,;二阶:每点 Hessian 半正定。沿任意方向看一元函数,二阶导非负 ⇔ 该一元函数凸 ⇔ 切线在下方,所以两者等价(在可微假设下)。
- ,,,成立。
- ,特征值 和 ,正定,凸。
- 。:;:,。因为 在 取最大值 。
- 可以把「表征」冻结,只优化凸的分类头,得到可靠的最优解和校准;也用于 linear probing 评估表征质量、在低资源下做可复现的基线。它不能保证端到端最优,但提供了一个有理论保证的参照。
10. 一页速记
- 凸集:任意两点的连线仍在集合内。
- 凸函数:弦在图像上方;等价于切平面在下方。
- 二阶判据: 处处成立。
- 凸函数上,局部最优 = 全局最优。
- 深度网络非凸,但最后一层分类头、KL 正则等子问题常是凸的。
- 物理意义 / 现实对应:凸 = 成本曲线越走越陡(边际成本递增),所以「等边际成本」就是全局最优;几何上就是碗底唯一,沿任何方向往下走都能到。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、定理名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- Jensen(1906):Sur les Fonctions Convexes et les Inégalités entre les Valeurs Moyennes。凸函数与 Jensen 不等式的原始论文;本页 §2.2 的弦定义与 §4 的一阶/二阶判据都源于此。Acta Mathematica
- Rockafellar(1970):Convex Analysis。凸集、凸函数与对偶理论的经典教材,本页 §4 的严格结论可在其中找到。Princeton University Press
- Boyd & Vandenberghe(2004):Convex Optimization。凸优化与 KKT/对偶的开放教材,对应本页 §8 与下一节 8.8。Cambridge University Press
下一篇 → 8.7 梯度下降、牛顿法与学习率
随堂测 · 4 题
源文件:08-微积分与优化/06-凸性.md