11.4 Attention(下):softmax 与多头
本节位置:模块 11 · 大模型专题 | 前置:11.3 | 预计:40 分钟
一句话:softmax 把分数变成「和为 1 的注意力预算」,多头让模型在不同子空间里同时关注不同类型的关系。
0. 场景引入
周一上午,律所的内部摘要服务收到一份 320 页的并购合同,约 12.8 万 token。服务跑在一张 80 GB 卡上:130 亿参数、40 层、40 个注意力头、,K/V 用 8 组共享(GQA-8),fp16 推理。
工程师要拍板:把 12.8 万 token 一次性喂进去,还是切成 8 段 1.6 万 token 分别摘要再合并?这正是多头注意力落地时要算的账。两种做法都得在 80 GB 卡上跑,差别不只是快慢,而是能不能看见整份文档。
先算显存。GQA-8 每个 token 的 KV Cache 是 ,12.8 万 token 约 21 GB;若每个头独立存 K/V(MHA),立刻变成 105 GB,一张卡直接 OOM。打分矩阵若真被物化,,根本存不下,所以必须让 FlashAttention 分块。
再算时间。全量 attention 约 FLOP,按有效 100 TFLOPS 估算要 134 秒;切 8 段只要约 1/8。但切段会丢掉「第 3 章定义的违约金适用于第 7 章」这类跨段指代,律师得再花 30 分钟人工核对。
一份合同还要过三轮摘要(提取、核对、成稿),预填充就是 秒;解码时每生成一个 token 要读一遍 21 GB 的 KV,按 2 TB/s 带宽约 10.5 ms。所以决定不是「能不能放下」,而是「多花 400 秒换回跨章节引用,值不值」。
问题:softmax 把分数变成了什么?40 个头凭什么比 1 个头强,又为什么有的头可以砍?
读完本节,你能回答的三个问题是:
- softmax 的归一化与数值稳定各自解决了什么;
- 多头注意力的参数、计算、显存三笔账怎么算;
- 什么时候该用 GQA、什么时候必须保留全部头。
1. 直觉
1.1 softmax 是「平滑的 argmax」
给定分数 ,softmax 输出大约 :最高的那个拿到大部分预算,但其它也有份。 分数差距越大,分布越尖锐;差距越小,越接近均匀。
1.2 多头是「并行子空间」
把 维拆成 个 维子空间,每个头在自己的子空间里做 attention。 最后把所有头的输出拼回 维,再用 混合。
💡 一句话直觉:softmax = 把分数变成注意力预算;多头 = 用多组不同的 Q/K/V 投影,从多个角度同时看同一句话。
类比边界:头之间不是完全独立的——它们共享输入,且 会把它们混合;「每个头负责一种语法」是过度简化的说法。
1.3 它在现实世界里对应什么
softmax 像一台总额固定的预算分配器:手上只有 1 份预算,按各项目的报价(logits)分配;多头则像 40 位互不通气的评审同时读同一份材料,各写一份意见,最后由 汇总成一份。
量级上,如果 的每一维都是独立的标准正态,那么 的方差是 ,标准差 。也就是说,未缩放的 logits 天然散布在 的范围里,分布一动就接近 one-hot;若再省掉减最大值, 已经越过 fp16 的上限 65504。除以 后标准差回到 1,,softmax 才有可用的梯度。
这个类比在哪里失效:预算分配假设「总额守恒、可以任意细分」,而 attention 的输出是 的凸组合,范数取决于 本身,并不守恒;40 位评审也不独立——它们共享输入, 会把意见重新混合,「每位评审负责一个议题」只是事后解释。
2. 定义
2.1 softmax(按行)
对向量 ,softmax 定义为:
对矩阵 ,按每一行做 softmax:
2.2 多头注意力
对第 个头:
其中 是 mask(合法位置 0,非法位置 )。
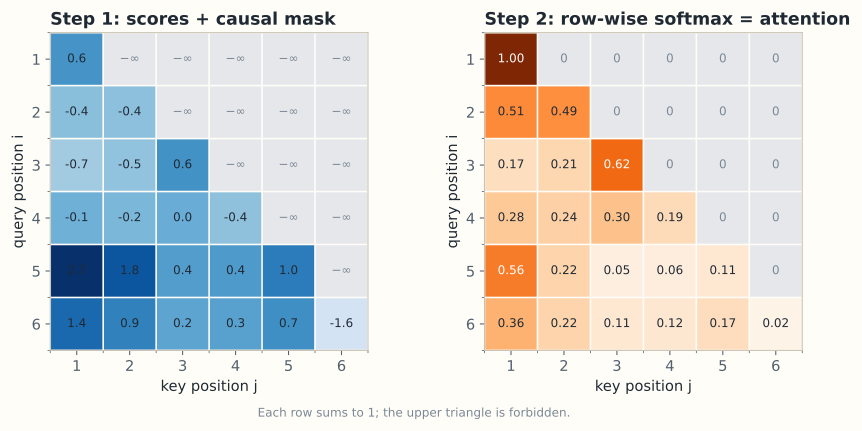
图:左图是 的示例分数矩阵,上三角被 mask 成 ;右图按行做 softmax 后,第 行只在前 列分配概率,每行和为 1。这就是自回归模型「只能看前面」的数学实现。
。
2.3 形状
| 张量 | 形状 |
|---|---|
[B,T,D] | |
[B,H,T,d_k] | |
[B,H,T,T] | |
[B,H,T,T] | |
[B,H,T,d_k] | |
| Concat | [B,T,H·d_k]=[B,T,D] |
| 输出 | [B,T,D] |
2.4 MHA / MQA / GQA
KV 参数量与缓存随 线性下降。
3. 为什么这样定义
为什么 softmax 而不是直接归一化? 直接除以和会让负分数变成负权重;指数保证非负,且放大差异,让模型能「聚焦」。指数还让 softmax 对整体平移不变(加常数不改变输出)。
为什么多头? 单个 softmax 只能产生一种「注意力分配」。多头提供多个分配,且每个头在不同子空间计算,能捕捉不同的关系。 再把它们组合。
为什么拼接后还要 ? 拼接只是把各头并排放置, 让不同头的信息交叉混合,而不是简单相加。
3.1 反事实:不除 、也不减最大值
取 ,,则 。
不除 :logit 就是 128。若按 2.1 的定义直接算 ,fp32 里 已超过 的上限(),直接变 inf;fp16 更早,,logit 超过 11.1 就溢出。就算向量不取全 1, 的标准差也意味着「11 左右」是常态,fp16 里相当一部分 logits 会溢出。
就算换 fp32、也没溢出,还有第二个坑:softmax 对尺度的响应会饱和。两维 logits 为 时,输出约 ,梯度 的非对角元只有 ,几乎学不动;除以 后 logits 变成 ,输出 ,非对角元回到约 。
不减最大值:logits 为 时, 在任何浮点格式里都是 inf, 得到 nan;先减最大值只花一次减法:,,结果 ,与直接算完全一致。这不是「让结果更好」,而是「让结果存在」——4.1 的平移不变性在数值上的真正用途。
反过来也要说清代价:除以 只是假设各维同方差的缩放;若 的分布本身很偏,它就不是最优缩放,有些实现因此加 QK-Norm 或可学习温度来替代这个固定常数。
4. 性质与推导
4.1 softmax 的性质
- 非负、和为 1:输出是概率分布;
- 平移不变:;
- 温度:, 更尖锐, 更平滑;
- Jacobian:。
4.2 数值稳定实现
直接算 会上溢。标准做法:
平移不改变结果(性质 4.1),但避免了 。
4.3 参数量
每个头: 各 ,共 ; 个头合计 。加 的 ,总共 。
注意:多头并不比单头()参数多;它只是把同样的 拆成 份。
4.4 计算复杂度
每个头 , 个头合计 ;与单头相同量级。多头的主要代价在显存( 个 矩阵)和小的 GEMM 效率。
4.5 掩码
加性 mask:, 或 。softmax 后非法位置权重为 0。因果 mask 使 下三角。
5. 例子
5.1 手算:softmax 与温度
:
温度 :,,,,和 :
更尖锐。:,输出更均匀。
5.2 手算:两个头
设 ,,。头 1 的 取前两维,头 2 取后两维(仅示意)。 输入两个 token:,。 头 1 看到 与 ,正交,注意力接近均匀;头 2 看到 与 ,分数全 0,注意力完全均匀。 拼接后 与 再经 混合——说明不同头可以关注不同子空间。
5.3 场景:GQA 省显存
Llama 2 70B 使用 GQA: 个 query 头, 组 KV。KV Cache 约为 MHA 的 。 代价是每组 KV 要服务 8 个 query 头,表达能力略降,但推理显存大幅下降。
5.4 场景闭环:12.8 万 token 的合同,一次读完还是切八段
回到第 0 节的律所,把整条链路算一遍。输入:,,, 层, 个头,,GQA 的 ,fp16。
计算:
- KV Cache:。若用 MHA(),同一式子给出 ,超过 80 GB 卡。
- attention 乘加:每层 ,全模型 FLOP。
- 若把打分矩阵 真存下来:,不可能;FlashAttention 分块后峰值显存只与块大小有关,约 。
输出决策:21 GB KV + 约 26 GB 权重(13B,fp16)+ 激活,总量约 50–60 GB,80 GB 卡放得下——选一次全量前向,保留跨章节指代;若只有 40 GB 卡,则退化为 8 段 16k 的分块摘要。
成本:按有效 100 TFLOPS 估算,attention 部分约 秒;分块方案约 ,约 17 秒。解码时每生成一个 token 要读一遍 21 GB 的 KV,按 2 TB/s 带宽估算约 10.5 ms,单请求上限约 95 token/s。
失败条件与兜底: 远超训练长度时,RoPE 的角度进入未见区间(见 11.5),attention 分布偏移,摘要开始重复——这时分块反而更稳。工程兜底:KV 超阈值就换 GQA 或量化 KV,打分矩阵超限走 FlashAttention 分块,单段超过训练长度先做位置插值。
6. 常见误区
-
误区:每个头负责一种可命名的语言现象。 纠正:有些头确实表现出可解释模式,但大多数头功能重叠、可替代;头的重要性需通过消融验证。
-
误区:多头比单头参数多 倍。 纠正:总参数仍是 ;只是把维度拆成 份,每份 。
-
误区:softmax 输出是「校准的概率」。 纠正:它只是归一化分数,不保证置信度校准;温度、训练目标都会影响。
-
误区:attention 权重越大,该 token 越「重要」。 纠正:权重是混合比例;某个 value 可能本身接近零,权重再大也不贡献信息。
7. 概念网络
- 前置:11.3 QKV —— 单头 attention。
- 前置:9.2 多元高斯 —— softmax 与分布。
- 后续:11.7 KV Cache —— GQA 的显存收益。
- 后续:11.11 采样 —— softmax 的另一个用途。
- 关联:12.1 einsum —— 多头注意力的统一写法。
8. 通往大模型:实现与代价
PyTorch 形状:
# X: [B, T, D]
q = X @ Wq                      # [B, T, D]
q = q.view(B, T, H, dk).transpose(1, 2)   # [B, H, T, dk]
s = q @ k.transpose(-2, -1) / math.sqrt(dk)  # [B, H, T, T]
a = torch.softmax(s + mask, dim=-1)
out = (a @ v).transpose(1, 2).reshape(B, T, D) @ WoFlashAttention:不显式存储 ,而是分块计算 softmax 与加权和,把显存从 降到 ;计算量仍是 。
可检验结论:因果 mask 下, 的每一行和为 1,且 ()。用 assert torch.allclose(a.sum(-1), torch.ones(...)) 可验证。
算错时用户看到什么:漏了 ,训练早期 loss 尖峰、对学习率极敏感,上线后表现为长文档摘要只抓住开头几句、后文被忽略;忘了减最大值,fp16 下一次 inf 就换来整条回复空白或 nan;把 GQA 的头数误配成 MHA,显存直接 OOM,用户看到 5xx 而不是变慢;拼接时把 [B,H,T,d_k] 直接 reshape 成 [B,T,D] 而没先转置,代码不会报错,只会输出语法通顺但答非所问的文本——这类 bug 最难查。
9. 练习
- 概念:softmax 为什么要减去最大值?不减会怎样?
- 计算: 的 softmax 是什么? 呢?
- 计算:,,求 ;四个投影的总参数量。
- 场景:GQA 中 、,KV Cache 是 MHA 的几分之几?代价是什么?
- 开放:如果所有头的 都相同,多头还有意义吗?为什么?
参考答案
- 防止指数上溢;减去最大值后结果不变(平移不变性),但数值安全。
- 均匀分布 ;,极度尖锐。
- ;。
- ;每组 KV 服务 4 个 query 头,表达力略降,且实现更复杂。
- 没有意义;所有头产生相同的注意力模式和输出,拼接后只是重复, 也无法创造新信息。多头的前提是不同投影。
10. 一页速记
- softmax 按行归一化;减最大值保证数值稳定。
- 多头 = 个 子空间并行 attention,再拼接 + 。
- 参数量仍是 ;计算量 。
- MQA/GQA 减少 KV 头数、省显存;因果 mask 在 softmax 前加 。
- 物理意义 / 现实对应:softmax 是总额固定的预算分配器,多头是 40 路并行评审, 把报价拉回可比较的尺度。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、方法名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- Vaswani 等(2017):Attention Is All You Need。多头注意力「拆成 个 子空间、拼接后再乘 」的结构与 参数账都出自这里,对应本页第 2.2 与 4.3 节。arXiv:1706.03762
- Bridle(1990):Probabilistic Interpretation of Feedforward Classification Network Outputs, with Relationships to Statistical Pattern Recognition。把前馈网络的输出经指数归一化解释成概率分布,softmax 这个名字与它的最大似然含义由此而来;本页的按行归一化、和为 1 就是它的直接应用。DOI:10.1007/978-3-642-76153-9_28
- Ainslie 等(2023):GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints。让多个 query 头共享一组 K、V,并给出从 MHA 检查点「升级」到 GQA 的做法;本页第 2.4 与 5.3 节的 记法、KV Cache 按比例缩小都来自它。arXiv:2305.13245
- Shazeer(2019):Fast Transformer Decoding: One Write-Head is All You Need。MQA:解码时所有 query 头共用一份 K、V,把 KV Cache 压到 ,是本页 MQA/GQA 讨论的起点。arXiv:1911.02150
下一篇 → 11.5 位置编码与 RoPE
随堂测 · 3 题
源文件:11-大模型专题/04-Attention-下-softmax与多头.md