11.11 logits、softmax、温度与采样
本节位置:模块 11 · 大模型专题 | 前置:1.4、11.1 | 预计:30 分钟
一句话:模型最后输出的是每个词的「分数」(logits),softmax 把它变成概率,温度与截断再决定「怎么掷骰子」。
0. 场景引入
一家电商文案生成平台,每天要产出 200 万条商品短文案,平均每条 380 个 token;模型词表 ,隐藏维 。运营和风控同时压下来两条硬指标:违规率低于 0.1%,人工改写率低于 12%。
你手上只有两个旋钮:温度 和 top-p。
A 档 、top-p=0.95:点击率高,改写率只有 10%,但 0.6% 的文案踩到「功效类违禁词」——每天 条要人工复核(0.5 元/条,6000 元/天),而复核窗口只有发布前的 90 秒,根本排不完。
B 档一刀切 、top-p=0.8:违规率降到 0.08%,可输出变得重复平淡,改写率升到 18%;每多一个百分点就是 2 万条,按 0.8 元/条算,一天多花 1.6 万元。
两档各踩一条红线。于是问题不再是「温度调多少」,而是:在哪一步、对哪些候选、用哪个旋钮,才能同时压住违规率和改写率? 这要求你看懂 softmax 把 logits 变成概率时做了什么、温度如何改变熵、top-k 与 top-p 砍掉的到底是哪一段概率质量。
对同一段上下文,logits 是固定的;变的只是从 logits 到概率再到采样的那几行。
读完本节,你能回答的三个问题是:
- softmax 为什么必须先减 max?温度在指数上到底改了什么,为什么它单调地抬高熵?
- 同样把候选砍短,top-k 与 top-p 在「头部尖锐」和「头部平坦」两种分布上差在哪?
- 给定违规率、改写率、延迟三条线上约束,温度、top-p、logits mask 该怎么组合,算错的代价是什么?
1. 直觉
把 logits 想成考试分数:
- 分数本身不是概率,可能为负、可能很大;
- softmax 把分数变成「占比」,总和为 1;
- 温度是「放大/缩小分差」:低温让第一名更突出,高温让大家更平均;
- top-k/top-p 是先淘汰一批候选,再在剩下的里按比例抽签。
💡 一句话直觉:logits = 原始打分;softmax = 归一化成概率;温度 = 调分布尖锐度;top-k/p = 砍掉长尾。
1.1 它在现实世界里对应什么
工程上,这一整套就是一张每一步都重画的彩票盘:softmax 给 个格子分配面积,温度决定面积差多悬殊,top-p 决定哪些格子留在盘上、哪些直接抹掉。
量级:某一步 个候选,、top-p=0.95 时真正留在盘上的通常只有 20–100 个 token(经验值),99.9% 以上的候选被丢掉;而这一步算 logits 要 FLOP,softmax 只有 次 exp——贵的是「打分」,不是「抽签」。
这个类比在哪里失效:彩票盘的格子一旦印好就不再变,而这里的格子面积每一步都按 logits 重算;更关键的是抹掉格子之后要重新归一化,剩下格子的相对大小会变——top-p 砍掉长尾后,头名的条件概率从 0.771 抬到 0.806(§5.2 的同一组数),若只留一个候选则直接变成 1——这与「只是少抽几个奖」完全不是一回事。
2. 定义
2.1 logits
最后一层隐藏状态 经 unembedding:
是词 的 logit,未归一化,可为任意实数。
2.2 带温度的 softmax
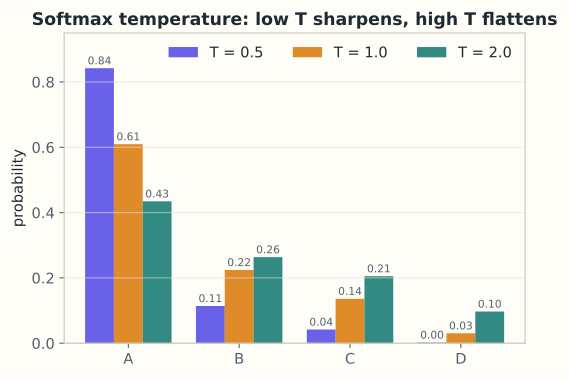
- :趋向 one-hot(argmax);
- :标准 softmax;
- :趋向均匀分布。
2.3 top-k 采样
只保留概率最高的 个词,重新归一化后采样(Fan 等 的原始定义)。
2.4 top-p(nucleus)采样
按概率从大到小累加,保留累计和达到 的最小集合,再归一化采样。候选数量随分布自适应,这就是 Holtzman 等 提出的 nucleus 采样。
2.5 贪心与束搜索
- 贪心:每步取 argmax,确定性;
- 束搜索:保留 条候选序列,适合翻译等任务,但计算/显存开销大。
3. 为什么这样定义
为什么用 softmax 而不是直接除以和? logits 可为负,直接归一化会产生负概率;指数保证非负,且可微。
为什么要温度? 训练时模型学的是「真实分布」,但生成任务常需要权衡「多样性 vs 质量」。温度是一个简单的分布调节旋钮。
为什么要 top-k/top-p? softmax 的长尾包含大量低概率词,采样到它们会产生不连贯文本。截断长尾能提升质量,但过高截断会损失多样性。
3.1 反事实:把温度和截断拿掉,具体坏在哪
两个都能手算的反例。
反例一:贪心解码()在重复循环里出不来。
设第 步只有两个像样的候选:上一轮刚出现的 token()和次优 token()。 时 argmax 恒取前者,而那一步它的概率只有
连一半都不到:它只是「略高于第二」,并不「应该被选」。
更要命的是自增强:上下文里每多一个重复 token,注意力就把它再抬一点。设三步里 依次是 ,对应 。
- 贪心:三步 100% 都选它,输出
的的的,然后继续锁死; - 采样:出现同一串的概率是 ,五次里只有一次左右——大多数路径会自己拐出去。
贪心的错不在「选了概率最大的那个」,而在把每一步的局部最优当成整串的全局最优:它看到 0.55 就当作「确定」,再把这个确定性一步步喂回上下文。
反例二:top-p 把长尾整段清零,模型从此说不出稀有词。
某步的分布是头部 加一段 1000 个词的平坦长尾,每个词 ,长尾总质量 ,三部分恰好凑成 1。
- 取 top-p=0.6:,加上 后 ,最小集合就是那两个头部词。1000 个长尾词的条件概率被置为 0。若正确答案恰好落在这段长尾里(总质量 0.30),它从 变成 ——100 步里至少踩中一次的概率是 ,也就是说整段回复里几乎必然至少出现一次「该说却永远说不出」。
- 取 top-k=50:保留 2 个头部加 48 个长尾,归一化后每个长尾词还有 ——还活着。
反过来,在「头部平坦」的分布上结论会倒过来:100 个词各 时,top-k=50 只留下 的概率质量,一半候选被均匀砍掉;top-p=0.9 保留 90 个,只丢 。
一句话:top-k 固定「个数」,top-p 固定「质量」。头部尖锐时 top-p 比 top-k 更狠(会清零长尾),头部平坦时 top-p 比 top-k 更宽容(会多留候选)。
4. 性质与推导
4.1 温度对熵的影响
分布越尖锐,熵越小。对固定 logits, 越小熵越低; 时熵趋于 0。
这不是一句观察,可以算出一个干净的导数。令 ,熵 对温度求导:
这个式子说的是:熵随温度单调不减,增长速度正好等于当前分布下 logits 的方差。而 自己会随 增大而缩小,所以升温「前半程」最有效,越往后越钝。
拿 验一下。 时 ,、,于是温度每加 1,熵增加约 0.42 nat( bit)。实测: 时熵 bit, 时 bit, 时 bit,上界 bit 要 才取到。
这条曲线解释了两件事:低温段每降一点温度,熵掉得很快(所以 从 0.7 改到 0.5 手感明显);高温段再加热,熵的增幅明显变慢,但长尾被整体抬起来,输出开始出现「合法但离谱」的词——「高温变疯」不是熵在涨,而是低概率候选的概率被抬高后抽中了。
4.2 top-p 的自适应
若分布很尖锐(一个词占 0.9),top-p=0.9 只保留一个词;若分布平坦,会保留很多词。这比固定 top-k 更灵活。
代价是它的候选数不可预测:尖锐时可能只留 1–2 个,模型想换个说法都没得选(§3.1 反例二的长尾清零就出在这里);平坦时可能留几百个,长尾又回来了。所以生产实现常配 min_tokens_to_keep(至少留 3 个)当兜底,或者用 top-k=50 做「地板」、top-p=0.95 做「上限」。§3.1 用一组具体分布算过两者的分野:top-k 固定个数,top-p 固定质量。
4.3 数值稳定
减去最大值不改变结果,但避免上溢。对温度,先算 再减最大值。
为什么要这么小心?把 直接代进指数:fp32 的上界是 , 一下是 88.7——也就是说 就溢出成 inf;fp16 窄得多,上界 65504,门槛只有 。
手算一个会炸的例子:、,指数上是 , 在 fp32/bf16/fp16 里全是 inf,于是 ,采样结果直接乱掉。先减 max 就没事:
,三个数都在 fp32 的表示范围内,最小的那个连 bf16 都存得下。
顺序上,减 max 和除 谁先谁后都行——softmax 对整体平移不变, 与 给出同一个分布。真正会出错的是忘了减(fp32 门槛 88.7、fp16 门槛 11.09),或者用 low precision 存中间结果。另外不少实现在 fp32 里算 softmax 再把结果转回 bf16:bf16 的范围够(上界 ),但 7 位尾数意味着 有 的相对误差,足以让 top-p 边界上两个概率差 的候选排反。
4.4 概率不是置信度
softmax 输出只保证归一化,不保证校准。模型可能对错误答案给出高概率;温度也会改变校准。用温度缩放做事后校准,是 Guo 等 给出的标准做法。
4.5 重复惩罚
对已出现 token 的 logits 减去惩罚项:
它改变的是 logits,不是概率;过度惩罚会破坏语法。
5. 例子
5.1 手算:温度
logits 。
:(见第 11.4 节)。
:,
比 更尖锐。
5.2 手算:top-k 与 top-p
接上,,。
- top-k=2:保留前两个,归一化 ;
- top-p=0.9:,加上 得 ,保留前两个,归一化 ;
- top-p=0.8:只保留第一个(,加第二个后 ,但最小集合是「第一个 + 第二个」?严格按定义,累计到 0.8 需要两个,所以仍是两个;若阈值 0.75,仍两个;若 0.7,一个)。
注意:top-p 的「最小集合」是累计概率首次 ≥ p 的集合,不是「单个概率 ≥ p」。
5.3 场景:温度 0 与温度 1 的差异
温度 0 等价于 argmax(贪心),适合事实问答、代码生成;温度 0.7–1.0 适合创意写作;温度 >1.5 往往失去连贯性。
5.4 场景闭环:200 万条文案、128k 词表
回到开头的平台。模型 、,每生成一个 token 都要做一次 unembedding 再采样。
输入:每步 ,权重 ,bf16 存储。
计算:
- 参数量 ,bf16 占 GB;
- FLOP: FLOP/token;
- 带宽:每个 token 必须把这 GB 权重完整读一遍。HBM 2 TB/s 下单条请求 ms;
- 算力:同样一次 GEMV 若跑出 100 TFLOP/s 只要 μs——慢了 50 倍的那一侧是带宽,不是 FLOPs(第 10.3 节的 Roofline)。
注意这里有个容易算漏的摊销:32 条请求并发解码时,这 1.05 GB 权重每步只读一次,摊到每条请求是 μs/token。一天 个 token,串行跑是 GPU·h/天,32 并发批处理只要 GPU·h/天——差 32 倍,这就是批处理存在的理由。(只核算 unembedding 这一层,全模型还要加 attention 与 KV cache 的访存。)
输出:每步在 top-p 截断后的候选集里采一个 token;同时把违规词的 logit 直接置 (等价于在 上加一个 mask)。mask 的代价是每步多 次加法,可以并进 softmax 的同一个 kernel;而事后对 12 万条词表做子串匹配,是一条独立的 CPU 流水线。
决策与成本:标题与卖点句用 、top-p=0.95 保创意,正文用 、top-p=0.9 保稳定,两段都叠 mask。人工侧:A 档 1.2 万条复核 元/天;B 档多出的 8 个百分点改写 万条 万元/天。只要 mask 能把违规率压到 0.1% 以下,A 档就是唯一划算的组合——省下的 12.8 万元/天,远高于多出来的那点 GPU 时间。
失败条件与兜底:
- 长尾被砍光:top-p=0.9 在头部尖锐时可能只剩 1–2 个候选,型号、尺码这类低频词永远出不来。兜底:
min_tokens_to_keep=3,或用 top-k 做地板。 - 两道闸门同时关死:温度调低后分布变尖,再套 top-p=0.95,候选更少,等于把 和 的紧缩乘在了一起。兜底:固定一个、只调另一个。
- NaN 传播:fp16 里 一溢出,整个 batch 采样出同一个 token。兜底:softmax 在 fp32 里算、先减 max、采样前检查
isfinite。 - 重复惩罚过头: 太大时常用词 logit 被压成负数,句子语法崩坏。兜底: 只取 1.0–1.2,且只作用于最近 64 个 token。
6. 常见误区
-
误区:温度改变了模型的知识。 纠正:温度只改输出的概率分布,不改变 logits/权重。
-
误区:top-p=0.9 意味着固定保留 90% 的词。 纠正:保留的是「累计概率达到 0.9 的最小集合」,数量随分布变化。
-
误区:贪心(温度 0)总是最好。 纠正:贪心可能陷入重复/次优;采样能提升多样性,但可能引入错误。
-
误区:softmax 概率就是模型「有多确定」。 纠正:概率未校准;高概率不等于正确,低概率也不等于错误。
7. 概念网络
- 前置:1.4 范数 —— logits 的尺度。
- 前置:11.1 Embedding —— unembedding 得到 logits。
- 前置:11.4 softmax —— 同一个函数。
- 关联:9.2 多元高斯 —— 概率分布视角。
- 关联:11.12 稳定性 —— logits 爆炸与训练。
8. 通往大模型:采样策略与形状
形状:[B,T,D] → [B,T,V] → softmax → [B,T,V];生成时通常只取最后一个位置 [B,V]。
常见组合:
| 场景 | 温度 | 截断 |
|---|---|---|
| 事实问答/代码 | 0–0.2 | 无或 top-p=0.95 |
| 通用对话 | 0.7 | top-p=0.9 |
| 创意写作 | 0.9–1.1 | top-p=0.95 |
| 多样化探索 | 1.0–1.3 | top-k=50 |
可检验结论:对固定 logits,温度从 1 降到 0.5,最大概率上升、熵下降;温度趋近 0 时,分布趋近 one-hot。
8.1 算错时用户看到什么
模型的 logits 往往是对的,错的是「把 logits 变成概率再采样」的那几行。用户不会看到 inf,只会看到这些:
- 温度方向搞反(该除 却写成乘): 方向,每次点「重新生成」都给一句不搭边的话;温度写成 0:连点十次返回同一句,用户以为按钮坏了。
- top-p 设成 0.05:候选集只剩一个词,回复两三个 token 后进入死循环或直接截断。
- softmax 没减 max:fp16 下 溢出成
inf,inf/inf得NaN,采样退化成固定下标,用户看到回复以一段重复的怪字符开头。 - logits 里混进一个
NaN:NaN与任何数比大小都是false,argmax 直接返回下标 0,整段输出变成同一个 token 的复读。 - mask 加在 softmax 之后(只把概率置零却不重新归一化):剩下概率之和小于 1,均匀采样 会落到空区间,表现为偶发乱码或直接报错。
- top-p 排序精度不够:概率差 的两个候选被排反,截断边界换人,同一个 prompt 两次生成的风格突变。
9. 练习
- 概念:logits 和概率有什么区别?为什么不能直接对 logits 采样?
- 计算:logits , 与 的分布分别是什么?
- 计算:,top-p=0.8 保留哪些词?归一化后概率是多少?
- 场景:为什么代码生成常用低温,而故事生成常用较高温?
- 开放:如果模型的 softmax 概率普遍偏高(过度自信),可以如何用温度/校准改善?
参考答案
- logits 是未归一化实数,可为负、和不为 1;采样需要概率,必须经 softmax(或类似变换)归一化。
- :均匀 ;:logits 变 ,仍是均匀——温度不改变相等分数的相对关系。
- 累计 ,加 得 ,保留前两个;归一化 。
- 代码要求确定性/正确性,低温减少随机性;故事需要多样性,较高温增加变化。
- 温度 >1 可平滑分布;也可做温度缩放校准(在验证集上拟合温度),或调整 top-p;但校准不增加信息。
10. 一页速记
- logits ,未归一化。
- ; 控制尖锐度。
- top-k 固定数量;top-p 自适应累计概率。
- 低温确定性,高温多样性但易失控。
- softmax 概率不等于校准置信度。
- 物理意义 / 现实对应:softmax 就是玻尔兹曼分布 ,logits 扮演 的角色—— 是真的「温度」, 越低系统越倾向停在能量最低的态(最大 logit), 时各态等概率;top-p 则是「只留百分之几十概率质量」的聚光锥,锥口开多大由分布自己决定。这个对应在 处失效:物理里绝对零度是冻结在基态,这里冻结成 argmax,但 argmax 不保证是全局最优的那一个词。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、定理名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- Holtzman 等(2019):The Curious Case of Neural Text Degeneration。nucleus(top-p)采样的出处:只保留累计概率达到 的最小候选集,解释了本页 §2.4 为什么它比固定 top-k 更自适应。arXiv:1904.09751
- Fan 等(2018):Hierarchical Neural Story Generation。top-k 采样的原始提出:只在概率最高的 个词里重新归一化再采样,即本页 §2.3 的定义。arXiv:1805.04833
- Guo 等(2017):On Calibration of Modern Neural Networks。指出现代网络的 softmax 概率普遍过度自信,并提出温度缩放(temperature scaling)作为事后校准;本页 §4.4「概率不是置信度」与练习 5 的依据。arXiv:1706.04599
下一篇 → 11.12 反向传播中的矩阵与训练稳定性
随堂测 · 4 题
源文件:11-大模型专题/11-logits与采样.md