11.3 Attention(上):QKV 与软查表
本节位置:模块 11 · 大模型专题 | 前置:1.3、11.2 | 预计:45 分钟
一句话:attention 让每个 token 用自己的 query 去「问」所有 token 的 key,按匹配度加权取回它们的 value——一次可微的软查表。
0. 场景引入
法务要把一份 200 页的并购合同问清楚:「第 3 条的赔偿上限,和第 11 条的终止权冲突吗?」
合同 12 万字,按中文常见「一字约一 token」估算,约 13 万 token。模型 24 层、32 头、、。
第一笔账是分数矩阵。全量算一遍, 的形状是 ,共 个数;fp16 存下来是 1.1 TB。一张 80 GB 的卡连一层都放不下,所以必须分块,让 永远不落地。
第二笔账是 KV。每层缓存 个 fp16,一层 2.1 GB,24 层 51.5 GB——放得下,但把卡占满了。
决策来了:硬上 13 万 token 的全上下文,还是先用检索挑出 8 个 4k 的候选块?全上下文每问约 FLOPs,按 1000 TFLOP/s 估约 8 秒;检索方案只喂 3.2 万 token,attention 项按 缩到 1/17,总 FLOPs 约 ,约 0.7 秒。代价是跨块的指代会断——第 3 条的「该等赔偿」指向第 2 条定义的「损失」,检索很可能只捞到一半。
就算选全上下文,51.5 GB 的 KV 还会反过来限制并发:80 GB 的卡扣掉权重,最多同时跑一两条请求,这笔开销摊销不掉。
读完本节,你能回答的三个问题是:
- 为什么分数要除以 ,不除会怎样?
- 为什么 分数矩阵不能物化,FlashAttention 省的是显存还是算力?
- 长文档答错时,怎么从注意力权重判断是「没看到」还是「看到了但没选对」?
1. 直觉
把 attention 想成一次软查表:
- Query(Q):我想找什么?(当前 token 的提问)
- Key(K):我有什么标签?(每个 token 的索引)
- Value(V):如果你选中我,我给你什么内容?(每个 token 的内容)
硬查表是「找到完全匹配的那一条,取它的 value」;软查表是「给每条打一个相似度分数,按分数加权平均所有 value」。这个机制最早由 Bahdanau 等 用来在神经机器翻译里学「对齐」。
💡 一句话直觉:attention = 用点积算「问题与标签的匹配度」,softmax 变成权重,再对 value 加权求和。
类比边界:它不是数据库检索,Q/K/V 都是学出来的线性投影,匹配度不等于语义相关性;attention 权重也不等于「解释」。
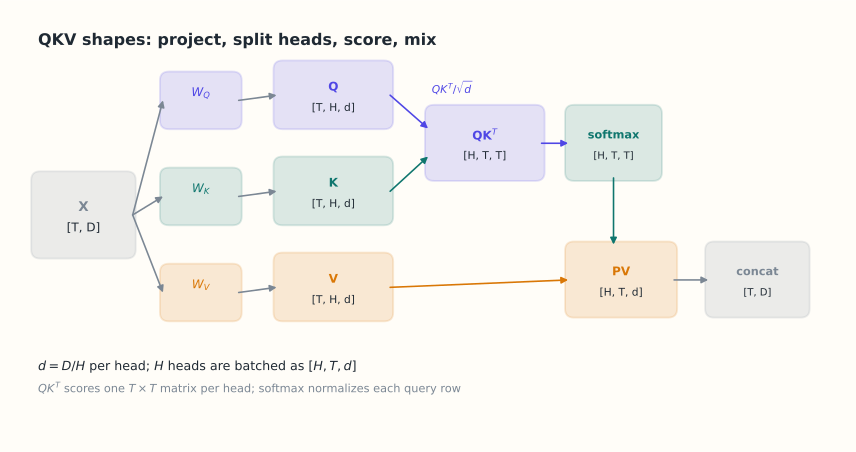
图: 经 投到每头 ; 给出 分数,softmax 后乘 得到 ,拼接回 。
1.1 它在现实世界里对应什么
一句话对应:attention 是一块「内容寻址存储器」(content-addressable memory, CAM)——递进去的不是地址,而是一个「我想找什么」的向量;每个槽位用自己的标签(key)与它比对,再按匹配度把内容(value)按比例倒出来。
量级算式:对单个 query、单个头,算 个分数要读 个 key 和同样多的 value,fp16 下是 字节;乘加是 FLOPs。两者一比:
和线性层单 token 的算术强度一样,都是 1。这不是巧合:decode 时整个模型都在搬数据,attention 只是搬得最多——、24 层的 KV 一次要扫 51.5 GB。
这个类比在哪里失效:真正的 CAM 是精确匹配、一次命中;attention 是 全表扫描,匹配度是学出来的连续相似度,不是「命中/未命中」。它更没有「找不到」这个返回值——softmax 一定给你一组和为 1 的权重,哪怕所有 key 都不相关,输出仍是一个像模像样的凸组合。这是长文档幻觉的数学根源,也是它和数据库检索最本质的区别。
2. 定义
2.1 输入与投影
设输入 (单个头、单条序列)。定义
其中 ,。常见 。
2.2 缩放点积注意力
Transformer 中最常见的写法是 Vaswani 等 提出的缩放点积注意力:
逐项读法:
- :第 项是第 个 query 与第 个 key 的点积;
- 除以 :控制方差(第 8 节);
- softmax 按行归一化:每个 query 对所有 key 的权重和为 1;
- 乘以 :得到每个位置的新表示,形状 。
2.3 因果掩码
自回归生成时,第 个位置不能看到 。做法是把上三角的分数设为 :
softmax 后这些位置的权重为 0。
2.4 多头
每个头有独立的 ,在 维子空间里做 attention,最后拼接再投影(第 11.4 节)。
3. 为什么这样定义
为什么用点积而不是欧氏距离? 点积是双线性的,计算可以用一次矩阵乘法完成,GPU 友好;而且它衡量「方向一致 + 强度」,适合做匹配分数(Luong 等 系统比较过点积与加性打分)。
为什么要 Q 和 K 分开? 同一个 token 作为「提问者」和「被查询者」的角色不同。分开投影让模型可以学「我需要什么」与「我能提供什么」两套表示。
为什么要 V? K 只负责匹配,V 负责传递内容。若直接用 K 加权,匹配与内容耦合,表达力受限。
为什么 softmax? 它把任意实数分数变成非负、和为 1 的权重,且可微;同时具有「赢者通吃」的趋势(分数差越大越集中)。
3.1 反事实:不除以 ,方差随 线性涨
设 独立同分布 ,点积 。每项 均值为 0、方差为 , 项独立相加,所以
方差随 线性涨,标准差随 涨。 代入三个真实宽度,取两个 logit 相差 作为典型跨度:
| 较大权重 | ||
|---|---|---|
| 16 | 4.0 | |
| 64 | 8.0 | |
| 128 | 11.3 |
那一行是关键:权重已经是 ,输出几乎是 one-hot。softmax 对角上的雅可比项是 ,在这一点上等于 ;而 fp16 能表示的最小正规数是 ,这个梯度在 fp16 反向里直接下溢成 0。模型不是「学得慢」,是这些位置上根本没有梯度。
除以 后 ,与宽度无关:两个 logit 差 2 时权重 ,梯度 ,落在健康区间。这就是那个根号的来源——它不是超参,是把方差钉回 1 的归一化因子。
第二个反事实:除错了对象,除以 而不是 。 时方差变成 ,所有 logit 挤在 0 附近,softmax 退化成均匀分布 :每个位置平均地看所有人,attention 沦为对 value 求均值。它照样能跑、loss 照样降,只是永远学不会「该看谁」——这类错误最难发现,因为形状和数值范围都「看起来正常」。
4. 性质与推导
4.1 形状链
批量与多头:
4.2 每行权重和为 1
softmax 的定义保证对每个 :。因此输出是 value 的凸组合,不会因序列变长而数值爆炸(但权重可能集中在少数位置)。
4.3 计算复杂度
需要 , 需要 ,合计 。这就是长上下文昂贵的根源;FlashAttention 通过分块减少显存,但不改变 的计算量。
4.4 排列等变性(无位置编码时)
若把输入 token 的顺序打乱,输出也会同样打乱——attention 本身不知道顺序。所以必须加位置编码(第 11.5 节)。
4.5 分数矩阵的秩
的秩至多 。当 时,分数矩阵是低秩的;softmax 是非线性的,会改变秩,但注意力仍受这个结构约束。
5. 例子
5.1 手算:两个 token 的 self-attention
设 (两个 token,),,。
对每行做 softmax(,):
结果:每个 token 的新表示是「自己 67% + 对方 33%」。因为两个 token 的 query/key 正交,匹配度相同,softmax 把分数差(0.707 vs 0)压成了 2:1 的权重。
若加因果掩码:第 1 行只能看自己,,输出第 1 个 token 保持 。
5.2 手算:为什么除以
设 各分量独立 ,则
每项方差 1,独立相加,方差为 ,标准差 。 时标准差约 11.3;softmax 输入跨度过大,输出接近 one-hot,梯度接近 0。除以 后方差为 1。
5.3 场景:一个注意力头的完整形状
import numpy as np
B, T, D, H = 2, 5, 8, 2
d_k = D // H
X = np.random.randn(B, T, D)
Wq = np.random.randn(D, D)
Q = (X @ Wq).reshape(B, T, H, d_k).transpose(0, 2, 1, 3)  # [B,H,T,d_k]
S = Q @ Q.transpose(0, 1, 3, 2) / np.sqrt(d_k)             # [B,H,T,T]
A = np.exp(S - S.max(axis=-1, keepdims=True))
A = A / A.sum(axis=-1, keepdims=True)
print(A.shape, A.sum(axis=-1)[0, 0])  # (2,2,5,5) [1. 1. 1. 1. 1.]
5.4 场景闭环:13 万 token 的合同问答
输入规模:、、、、、。
计算(prefill),按三块拆开:
| 部分 | 算式 | FLOPs |
|---|---|---|
| QKV 与输出投影 | ||
| 与 | ||
| FFN | ||
| 合计 |
按 1000 TFLOP/s 估约 8 s。 那一项占 85%——这就是长上下文的定价方式:token 数翻倍,注意力开销翻四倍。
显存与带宽:分数矩阵若要物化, 个 fp16 是 1.1 TB,任何卡都放不下,只能分块(FlashAttention 干的就是这件事)。KV 每层 2.1 GB、24 层 51.5 GB;decode 每 token 要把这 51.5 GB 读一遍,3 TB/s 下约 17 ms/token。
输出决策:给出答案和条款引用;若某位置的最大权重低于 (接近均匀),标记「未找到依据」转人工,而不是硬答。
成本:一次提问 prefill 8 s 加 200 token 答案 s,约 11 s。一张 80 GB 卡被 51.5 GB 的 KV 吃掉大半,并发只能压到 1–2。
失败条件与兜底:
- 超出训练窗口: 超过预训练长度时,RoPE 外推让远处位置几乎不可分,表现是「引用错误的条款号」。兜底:滑窗 + 检索混合,窗口内全注意力、窗口外检索。
- 注意力塌缩:softmax 把权重全压到第一个 token(attention sink),后面 13 万 token 等于没看。兜底:监控每层注意力熵,熵低于阈值就报警。
- 分数溢出:不缩放时 , 在 fp16 里超过 65504 就变 inf。兜底:softmax 前减行最大值,所有稳定实现都这么做。
6. 常见误区
-
误区:attention 权重就是「模型解释」。 纠正:权重只表示信息混合比例,不表示因果重要性;不同头、不同层可能相互补偿。
-
误区:Q、K、V 是输入的不同副本。 纠正:它们是输入经过不同可学习投影得到的;初始化相同时也会因梯度不同而分化。
-
误区:attention 是「记忆」。 纠正:它只访问当前上下文窗口内的 token;长期知识存储在权重里,不在 attention 里。
-
误区:mask 只是「把未来置零」。 纠正:是在 softmax 前置 ,保证归一化后严格为 0;若在 softmax 后置零,行和不再为 1。
7. 概念网络
- 前置:1.3 点积 —— 匹配分数。
- 前置:11.2 线性层 —— QKV 投影。
- 后续:11.4 多头与 softmax —— 并行子空间。
- 后续:11.7 KV Cache —— 缓存 K、V。
- 关联:11.5 RoPE —— 给 Q/K 注入位置。
8. 通往大模型:参数量、复杂度与实现
参数量( 各 ):。 对 :约 6710 万/层。
计算量:; 时约 FLOPs/层(仅 与 ),是长上下文的主要开销。
KV Cache:推理时缓存历史 ,每步只算新 token 的 Q,避免重复计算历史(第 11.7 节)。
可检验结论:因果 attention 的权重矩阵是下三角( 对 ),且每行和为 1。若你的实现出现上三角非零,说明 mask 位置或 softmax 顺序错了。
算错时用户看到什么:mask 位置错( 加错了三角,或 softmax 之后才置零)在训练早期几乎看不出来,因为模型会学着不去看未来;推理时症状却很典型——生成到第二个 token 就开始复读第一个 token,整段退化成同一句话的循环。原因是训练时偷看了未来,模型学会「抄下一个词」;推理时没有未来可抄,只能抄自己。
缩放写错则走向两个极端:漏掉 ,softmax 逼近 one-hot,用户看到「答非所问、只盯着开头那个 token」;误除以 ,softmax 逼近均匀,用户看到「什么都答一点、什么都不准」的糊墙式回答。
还有一类只在长上下文暴露:KV Cache 的写入位置与位置编码的偏移不一致,前几百个 token 正常,几千 token 之后开始「引用不存在的条款」——因为 query 和 key 已经不在同一个位置坐标系里。
9. 练习
- 概念:为什么 attention 要分成 Q、K、V 三个投影,而不是直接用输入两两做点积?
- 计算:, 有多少个元素?需要多少次乘加(数量级)?
- 计算:接 5.1,若把 换成 ,分数和权重会怎样变化?输出会变吗?
- 场景:为什么因果 mask 必须在 softmax 之前加 ?在之后置零会破坏什么?
- 开放:如果 attention 权重矩阵的秩很低,对模型表达有什么影响?可能带来什么计算优势?
参考答案
- 直接用输入点积会让「提问」和「被查询」共用同一表示,无法分别学习;Q/K/V 分离提供更大的表达空间,V 还负责内容传递。
- M 个元素;每个元素 次乘加,共约 次乘加( FLOPs)。
- 分数翻倍,softmax 更尖锐(对角线权重更高),输出更接近自身;会变。
- softmax 后再置零会破坏「每行和为 1」,输出不再是凸组合;正确的做法是 softmax 前把非法位置设为 。
- 秩低意味着所有 query 的注意力模式高度相似,减少头的多样性、降低表达;优势是可低秩近似、加速长序列计算。
10. 一页速记
- ,,;;输出 。
- 物理意义 / 现实对应:一块内容寻址的软查表——用 query 和所有 key 比相似度,再按权重取回 value 的凸组合;代价是 的全表扫描,没有「未命中」这个返回值。
- 形状:。
- 缩放为了控制点积方差;mask 在 softmax 前加 。
- 复杂度 ;因果 attention 权重下三角、行和为 1。
- 参数量约 /层。
11. 参考文献与致谢
这一页的知识不是凭空来的。下面列出本页直接借用的原始工作与权威整理;正文中的人名、方法名已链接到对应条目。链接优先指向 DOI、arXiv 或可长期访问的原文存档。
- Vaswani 等(2017):Attention Is All You Need。本页的核心公式 、多头拼接与因果 mask 都出自这里;「除以 是为了控制点积方差」也是它给出的理由。arXiv:1706.03762
- Bahdanau 等(2014):Neural Machine Translation by Jointly Learning to Align and Translate。让解码器对源句每个位置学一个权重再加权取信息,attention 作为「可微软对齐」从这一步开始;本页的软查表直觉就是它。arXiv:1409.0473
- Luong 等(2015):Effective Approaches to Attention-based Neural Machine Translation。系统比较乘性(点积)与加性两种打分函数,说明 这种写法既便宜又够用——本页第 3 节「为什么用点积」的依据。arXiv:1508.04025
- Dao 等(2022):FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness。用分块与在线 softmax 避免把 分数矩阵写回显存,显存从 降到 而计算量不变,对应本页第 4.3 节。arXiv:2205.14135
下一篇 → 11.4 Attention(下):softmax 与多头
随堂测 · 5 题
源文件:11-大模型专题/03-Attention-上-QKV.md